
Dans le paysage foisonnant de l’inférence statistique appliquée aux sciences humaines, cognitives et médicales, l’analyse de variance — universellement désignée par son acronyme anglo-saxon ANOVA — occupe une position cardinale. Conçue pour départager la part des fluctuations imputable au hasard de celle résultant de manipulations expérimentales délibérées, cette méthodologie repose tout entière sur une statistique de test singulière : la valeur ou ratio F. Lorsqu’un logiciel d’analyse quantitative tel que R, SPSS ou JASP délivre ses sorties numériques, l’œil du chercheur est immédiatement attiré par cette métrique et par le seuil de signification qui lui est corrélé. Cependant, la question fondamentale demeure : que traduit véritablement une valeur F élevée sur le plan épistémologique, mathématique et pratique ?
Loin de constituer une simple formalité algorithmique destinée à franchir le seuil arbitraire d’une p-valeur inférieure à 0,05, l’émergence d’une valeur F substantielle cristallise une réalité géométrique et distributionnelle profonde. Elle matérialise l’émergence d’un signal expérimental robuste émergeant du bruit de fond inhérent à la variabilité biologique ou psychologique des sujets observés. Comprendre les implications mécaniques de ce ratio impose de plonger au cœur de la partition de la variance, de saisir l’asymétrie de sa distribution d’échantillonnage, et d’en appréhender les répercussions tant sur la séparabilité des populations que sur la validité des conclusions scientifiques formulées.
Le présent article propose une exploration exhaustive de la statistique F dans le cadre de l’ANOVA. En articulant rigueur mathématique, considérations méthodologiques et applications concrètes issues de la psychologie scientifique et des neurosciences comportementales, nous analyserons la genèse de ce test, décortiquerons la machinerie de son calcul, expliciterons la signification de ses grandeurs extrêmes et mettrons en garde contre les écueils interprétatifs courants. Du rejet de l’hypothèse nulle aux raffinements des tailles d’effet et des procédures post-hoc, ce guide constitue un manuel de référence pour tout praticien de la recherche quantitative désireux de dépasser l’application mécanique des tests d’hypothèse.
1. Fondements conceptuels de l’ANOVA et genèse de la statistique F
1.1 Principes fondamentaux de l’analyse de variance à un facteur
L’analyse de variance univariée à un facteur constitue le dispositif méthodologique de référence lorsqu’un chercheur souhaite comparer simultanément les moyennes d’une variable dépendante continue mesurée à travers trois groupes expérimentaux indépendants ou davantage. Face à un plan d’expérience comportant k modalités (par exemple, l’évaluation de trois protocoles psychothérapeutiques distincts et d’un groupe contrôle sur l’intensité des symptômes dépressifs), l’approche intuitive consistant à multiplier les comparaisons bivariées via le test t de Student se heurte à une aporie statistique insurmontable.
Sur le plan formel, l’hypothèse nulle, notée H0, postule une égalité parfaite et conjointe de l’ensemble des moyennes populationnelles sous-jacentes :
H0 : μ1 = μ2 = μ3 = … = μk
À l’inverse, l’hypothèse alternative, désignée par H1, ne formule aucunement l’exigence que toutes les moyennes diffèrent mutuellement les unes des autres de manière symétrique. Elle stipule avec précision et parcimonie qu’il existe au moins une paire de moyennes au sein du système pour laquelle une divergence statistiquement significative est observable :
H1 : ∃ (i, j) tel que μi ≠ μj pour i ≠ j
La nécessité théorique d’abandonner les tests t successifs au profit de l’ANOVA réside dans la gestion du risque d’erreur de première espèce (l’erreur de type I), qui consiste à rejeter H0 alors qu’elle est rigoureusement vraie dans la population. Si un expérimentateur réalise des comparaisons indépendantes au seuil nominal α = 0,05, la probabilité d’obtenir au moins un faux positif à travers c tests pairwise distincts s’élève mathématiquement à :
αglobal = 1 – (1 – α)c
Pour un design expérimental comprenant seulement 5 groupes, le nombre de comparaisons bilatérales possibles s’élève à c = 10, ce qui porte l’inflation du risque global à plus de 40 % (1 – 0,9510 ≈ 0,401). L’ANOVA pallie radicalement cette dérive en fournissant un test omnibus unique capable d’évaluer la variabilité collective sans gonfler artificiellement le risque de commettre une erreur d’inférence.
1.2 La nature duale de la variance dans les modèles expérimentaux
L’intuition fondamentale qui sous-tend l’analyse de variance repose sur un axiome géométrique d’une élégance absolue : la dispersion totale observée au sein d’un ensemble de données quantitatives peut être partitionnée de manière additive et exhaustive en composantes indépendantes. Ce partitionnement fondamental de la somme totale des carrés des écarts (désignée sous le sigle SSTotal pour Sum of Squares) s’exprime selon la célèbre équation :
SSTotal = SSInter + SSIntra
La première composante, la variance intergroupe (ou SSInter, parfois qualifiée de somme des carrés du traitement), quantifie la magnitude selon laquelle les moyennes de chaque sous-groupe divergent de la moyenne générale (le grand barycentre) calculée sur l’ensemble de l’échantillon. Cette métrique capte directement l’effet systématique induit par la variable indépendante manipulée, auquel s’agrège une fraction mineure d’erreur d’échantillonnage. Si le traitement administré — qu’il s’agisse d’une molécule pharmacologique, d’une méthode pédagogique ou d’une amorce cognitive — exerce un impact puissant, les moyennes des groupes seront projetées à distance les unes des autres dans l’espace des observations, augmentant drastiquement la valeur de la SSInter.
La seconde composante, la variance intragroupe (ou SSIntra, traditionnellement nommée somme des carrés résiduelle ou de l’erreur), saisit quant à elle la dispersion des scores individuels des participants autour de la moyenne spécifique de leur propre condition d’assignation. Puisque l’ensemble des sujets au sein d’un même groupe a été soumis rigoureusement au même traitement expérimental dans des conditions standardisées, les divergences constatées entre ces individus ne peuvent découler de la variable indépendante. Elles reflètent l’estimation pure du bruit aléatoire résiduel : variations génétiques interindividuelles, fluctuations attentionnelles momentanées, erreurs de mesure psychométrique ou bruits environnementaux non contrôlés.
Le tableau récapitulatif de l’ANOVA agit comme la structure intégrative suprême de cette partition. En formalisant les sommes des carrés, leurs degrés de liberté respectifs, les carrés moyens qui en découlent et le ratio de ces derniers, il offre une cartographie claire de l’origine de l’hétérogénéité des données, permettant de diagnostiquer instantanément si la structuration expérimentale prévaut sur l’entropie stochastique.
1.3 Origine historique et fonction épistémologique du test F de Fisher
La genèse de ce cadre formel trouve sa source historique dans les contributions pionnières de Sir Ronald Aylmer Fisher au cours des années 1920, lors de ses travaux agronomiques majeurs à la station expérimentale de Rothamsted. Confronté à la nécessité d’évaluer le rendement de différentes variétés de céréales et de formules d’engrais sur des parcelles de terre soumises à d’inévitables variations de fertilité du sol, Fisher comprit que l’inspection isolée des rendements moyens était scientifiquement stérile sans une formalisation rigoureuse de la dispersion environnante. C’est en son hommage que George Snedecor baptisa ultérieurement ce rapport de variances la « statistique F ».
D’un point de vue épistémologique, l’avènement du test F marque un tournant paradigmatique dans l’histoire des sciences empiriques : il s’agit de la transition définitive d’une statistique purement descriptive — cantonnée au recensement des tendances centrales — vers une inférence causale probabiliste rigoureuse. Le test F offre une solution mathématique pour trancher un débat causal fondamental : les écarts constatés entre nos conditions expérimentales témoignent-ils d’une véritable loi de causalité naturelle, ou constituent-ils de simples artefacts forgés par les caprices de l’échantillonnage aléatoire ?
L’utilité spécifique de cette statistique dite « omnibus » réside dans sa capacité à tester la variabilité collective sans postuler a priori quelle condition particulière doit l’emporter sur les autres. En se positionnant au cœur du modèle linéaire général (GLM), la statistique F ne se limite pas à l’ANOVA à un facteur : elle constitue le pivot analytique de la régression multiple, des analyses de covariance (ANCOVA), et des modèles mixtes les plus sophistiqués de la psychologie contemporaine.
2. Décomposition mathématique : Le calcul et la mécanique du ratio F
2.1 Structure du ratio : Carré moyen du traitement versus carré moyen résiduel
L’architecture mathématique de la statistique F repose sur une élégante fraction qui met en balance deux estimateurs indépendants de la variance de la population, calculés sous des prémisses théoriques distinctes. L’équation canonique s’énonce comme suit :
F = MSTraitement / MSErreur = MSInter / MSIntra
Dans cette formulation, le terme MS représente le Carré Moyen (en anglais, Mean Square), qui s’obtient systématiquement en rapportant la somme des carrés (SS) à ses degrés de liberté (df) associés :
MSInter = SSInter / (k – 1)
MSIntra = SSIntra / (N – k)
où k désigne le nombre total de groupes expérimentaux et N la taille globale de l’échantillon compilant l’ensemble des observations.
Le dénominateur de cette fraction, le carré moyen de l’erreur (MSIntra), joue un rôle fondamental dans la théorie statistique : il constitue un estimateur non biaisé de la variance populationnelle σ2, et ce, que l’hypothèse nulle soit rigoureusement vraie ou totalement fausse. Il quantifie la variance d’erreur pure au sein des populations échantillonnées. En revanche, le numérateur, le carré moyen du traitement (MSInter), n’estime fidèlement cette même variance σ2 que si et seulement si l’hypothèse nulle est scrupuleusement respectée. Si un effet expérimental tangible θ existe entre les groupes, l’espérance mathématique du numérateur devient :
E(MSInter) = σ2 + [ ∑ nj αj2 / (k – 1) ]
où αj représente la déviation systématique induite par le traitement du groupe j. Il apparaît donc avec une clarté analytique éclatante que lorsque l’effet expérimental α croît en magnitude, le terme de droite explose arithmétiquement, propulsant le numérateur vers des valeurs considérablement supérieures au dénominateur, ce qui fait inéluctablement grimper la valeur finale du ratio F.
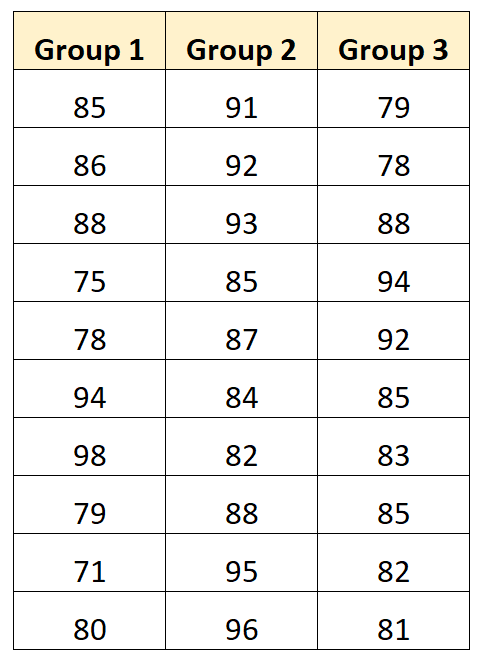
2.2 Visualisation du rapport signal sur bruit
Pour conceptualiser intuitivement la mécanique sous-jacente au ratio F sans s’égarer dans l’abstraction pure des formules algébriques, les statisticiens ont recours à l’analogie du rapport signal sur bruit (Signal-to-Noise Ratio, SNR), empruntée au traitement du signal et à l’ingénierie des télécommunications. Dans cette perspective métaphorique mais rigoureuse :
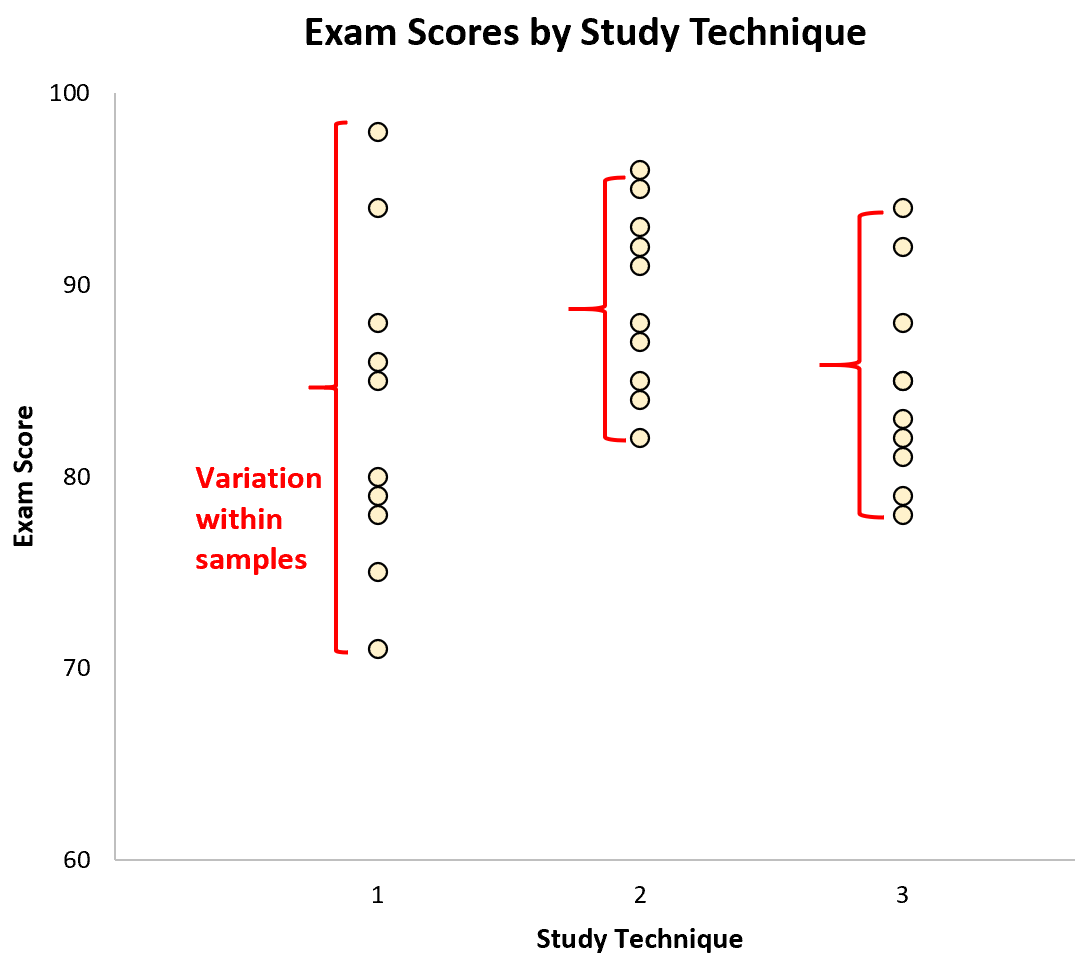
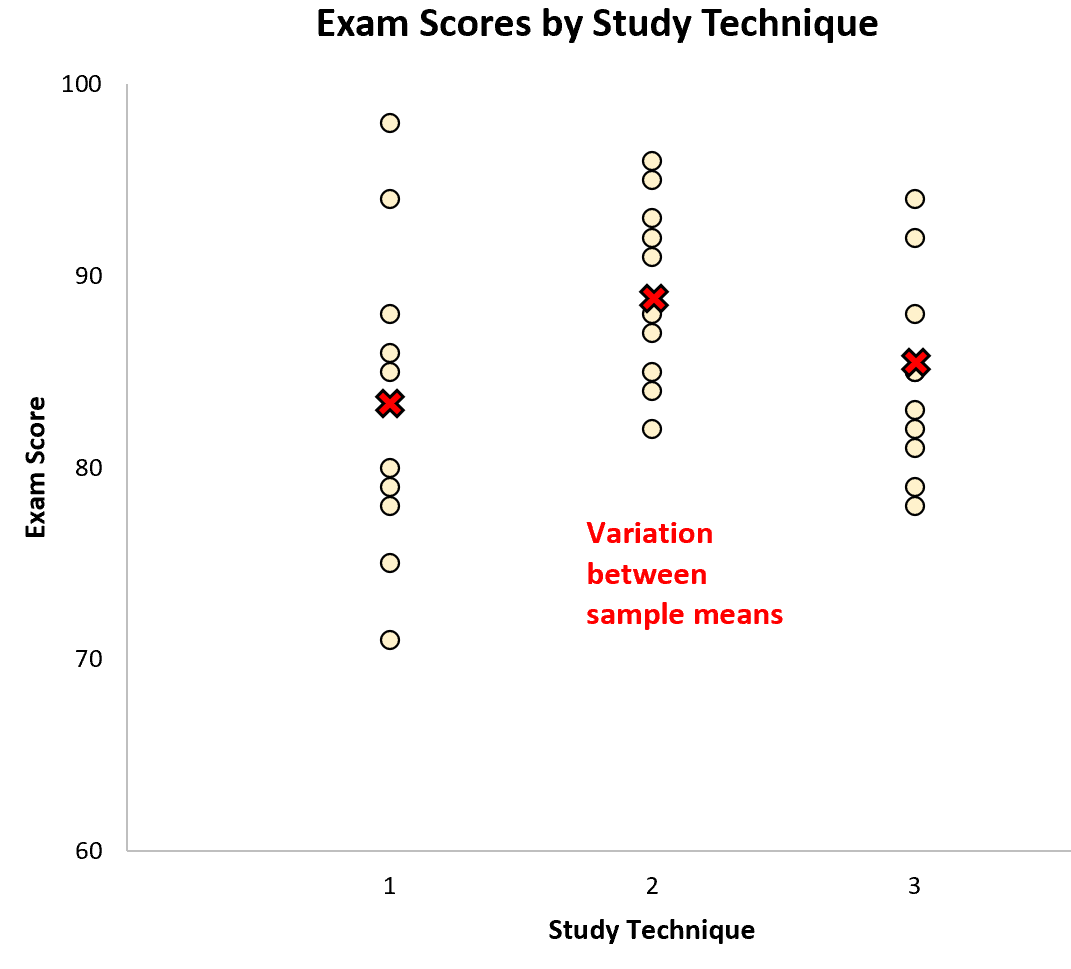
- Le signal est véhiculé par le numérateur (MSInter). Il correspond à la force avec laquelle la manipulation expérimentale a réussi à translater les scores des participants dans une direction systématique. C’est l’information structurée injectée par le protocole expérimental.
- Le bruit est incarné par le dénominateur (MSIntra). Il représente la cacophonie stochastique, la dispersion d’arrière-plan, la variabilité idiosyncrasique des participants qu’aucun facteur contrôlé ne permet d’endiguer.
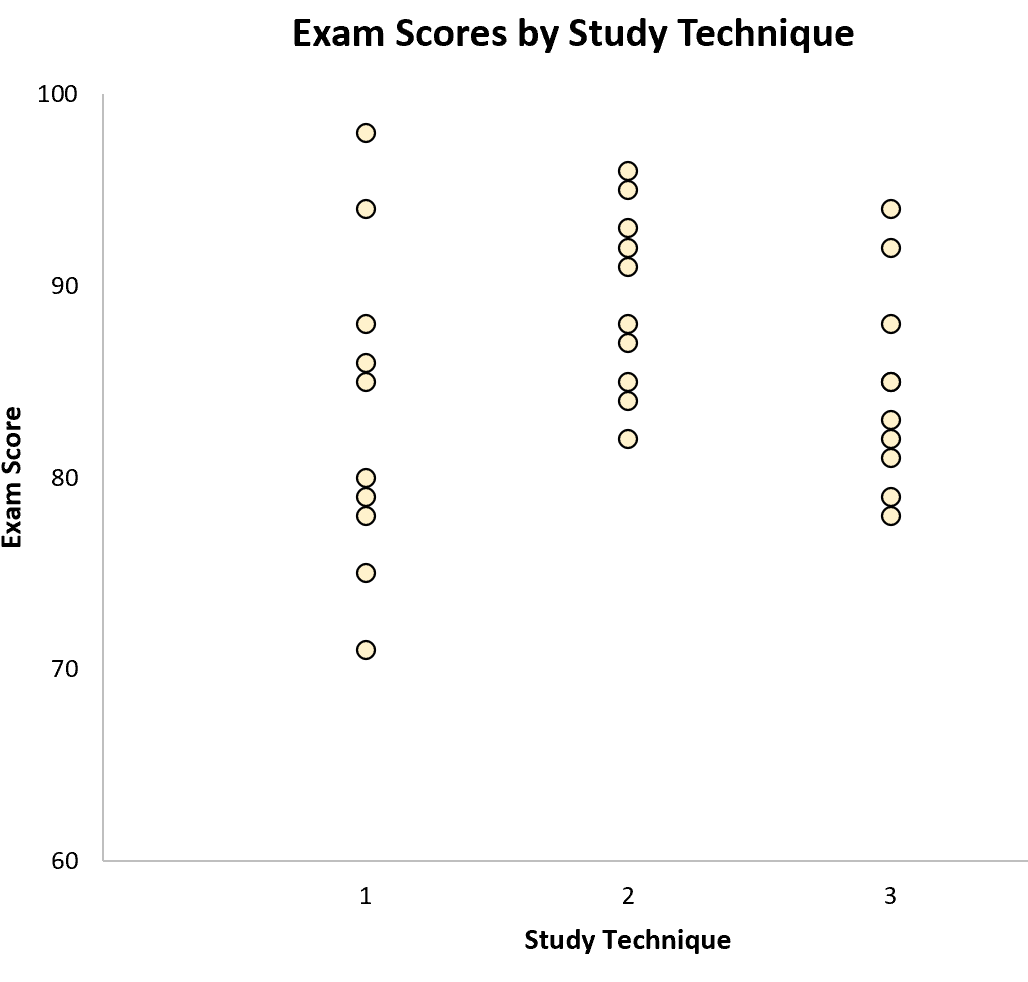
Une valeur F élevée atteste par conséquent que l’intensité du signal expérimental a transcendé le bruit de fond biologique ou environnemental. Il est particulièrement instructif de constater la dynamique bidirectionnelle qui gouverne l’accroissement mathématique de F. La valeur de F peut s’élever substantiellement soit parce que l’écart séparant les moyennes observées augmente de manière spectaculaire (augmentation du signal au numérateur), soit parce que les scores au sein de chaque groupe sont remarquablement homogènes, compacts et étroitement resserrés autour de leur moyenne respective (réduction drastique du bruit au dénominateur).
Inversement, même une manipulation expérimentale entraînant une translation marquée des moyennes de groupe échouera à générer une valeur F élevée si la variance interne à chaque groupe est titanesque. Si le bruit résiduel submerge le signal, l’ANOVA conclura logiquement à l’incapacité d’isoler l’impact du traitement du chaos probabiliste ambiant.
2.3 Étapes séquentielles du calcul à partir d’un tableau ANOVA
L’extraction arithmétique de la statistique F à partir des données brutes s’opère selon une séquence d’étapes algorithmiques immuables que les logiciels statistiques exécutent de manière matricielle instantanée, mais dont la compréhension pas-à-pas éclaire le fonctionnement intime du modèle :
La première phase implique le calcul des sommes des carrés. Pour chaque individu i au sein du groupe j présentant un score Yij, avec une moyenne de groupe désignée par Ȳj et une moyenne générale notée Ȳ• :
SSInter = ∑ nj (Ȳj – Ȳ•)2
SSIntra = ∑ ∑ (Yij – Ȳj)2
La deuxième étape consiste à attribuer de manière univoque les degrés de liberté attachés à chaque source d’hétérogénéité. Les degrés de liberté du numérateur (traitement) sont indexés sur la complexité structurelle du design factoriel :
dfInter = k – 1
Tandis que les degrés de liberté du dénominateur (erreur) mesurent la quantité d’informations résiduelles libres de varier une fois les moyennes de groupes stabilisées :
dfIntra = N – k
La troisième étape exécute la division arithmétique simple de chaque somme des carrés par son degré de liberté correspondant, générant les carrés moyens MSInter et MSIntra. Enfin, l’ultime étape résout la fraction finale en divisant MSInter par MSIntra pour obtenir la valeur scalaire F empirique. C’est cette valeur observée qui sera ensuite confrontée à la distribution théorique pour déterminer le seuil de significativité.
3. La signification statistique fondamentale d’une valeur F élevée
3.1 Rejet de l’hypothèse nulle et divergence intergroupe
La manifestation d’une valeur F substantiellement supérieure à l’unité (F ≫ 1) délivre un message statistique sans équivoque : la variabilité constatée entre les différentes conditions d’expérimentation est disproportionnellement plus vaste que ce que le simple hasard de l’échantillonnage pourrait raisonnablement engendrer à lui seul. Sur le plan de la décision d’inférence, une valeur F élevée contraint l’expérimentateur à rejeter l’hypothèse nulle H0 au profit de l’hypothèse alternative H1.
Ce mécanisme s’enracine dans la théorie des probabilités : sous l’hypothèse nulle où les populations d’origine partageraient une moyenne strictement identique, les estimateurs MSInter et MSIntra visent tous deux la même quantité mathématique σ2. Dès lors, le ratio de ces deux grandeurs devrait théoriquement graviter autour de 1. Lorsqu’un protocole expérimental culmine dans une valeur de F s’élevant à 8, 15, 40 ou davantage, l’observateur se heurte à une improbabilité mathématique flagrante sous l’hypothèse de l’invariance. La probabilité d’enregistrer une telle disparité par pure coïncidence stochastique devient infinitésimale.
L’observation d’un F hautement significatif confirme ainsi de façon péremptoire qu’au moins une des conditions expérimentales a divergé d’au moins une autre de manière statistiquement notable. L’homogénéité postulée est brisée, validant le fait que les données empiriques recueillies portent l’empreinte tangible de la variable indépendante.
3.2 Le comportement attendu de F lorsque l’effet est nul
Pour appréhender la singularité d’une valeur F élevée, il s’avère indispensable de comprendre la dynamique du ratio lorsque la manipulation n’a strictement aucun effet. Sous la stricte vérité de l’hypothèse nulle H0, la valeur théorique moyenne (l’espérance mathématique) de la statistique F ne s’établit pas exactement à 1,00 comme l’intuition première pourrait le suggérer, mais s’écrit formellement :
E(F) = dfIntra / (dfIntra – 2) (pour dfIntra > 2)
À mesure que la taille de l’échantillon global N croît, cette quantité converge asymptotiquement vers 1. Ainsi, dans une recherche où le traitement n’exerce aucune influence réelle, des fluctuations d’échantillonnage légitimes généreront typiquement des valeurs de F oscillant entre 0,80 et 1,30 environ, selon la configuration des degrés de liberté.
Une distinction critique doit être opérée entre un F proche de l’unité et un F qui s’effondre drastiquement en deçà de 1 (par exemple, F = 0,15 avec une p-valeur approchant 0,90). Alors qu’un F voisin de 1 atteste fidèlement de l’absence d’effet du traitement dans un modèle sain, une valeur F anormalement et exagérément basse soulève des soupçons méthodologiques majeurs. Un tel résultat implique que la variance entre les groupes est bizarrement inférieure à la variance interne attendue par simple échantillonnage.
Ce phénomène d’hyper-homogénéité intergroupe trahit fréquemment des anomalies méthodologiques sévères : une violation du postulat d’indépendance des observations (comme des participants qui se seraient concertés entre conditions distinctes), une autocorrélation positive non modélisée, une stratification inadéquate, voire, dans les cas les plus sombres de l’histoire de la recherche, une falsification délibérée de données où un falsificateur peu au fait des lois de la dispersion aurait artificiellement uniformisé les moyennes des différents groupes.
3.3 Implications sur la séparabilité géométrique des distributions
Sur le plan de l’analyse géométrique des données, l’élévation de la valeur F s’exprime visuellement par une réduction substantielle du chevauchement existant entre les courbes de densité de probabilité des différents échantillons. Si l’on trace les distributions gaussiennes théoriques de chaque condition expérimentale sur un axe horizontal figurant la variable dépendante, une valeur F modeste ou unitaire se matérialise par des courbes presque superposées : l’œil humain peine à distinguer où s’achève une condition et où débute la suivante, traduisant une indiscernabilité presque totale des profils individuels.
À mesure que F grandit et atteint des grandeurs élevées, les centroïdes de ces distributions s’écartent les uns des autres sur l’axe des abscisses, tandis que l’étalement interne de chaque cloche (la variance résiduelle) demeure étroit. Il en découle un phénomène géométrique où les surfaces d’intersection sous les courbes diminuent de manière exponentielle. La distance spatiale séparant les centres de gravité des groupes prévaut nettement sur le rayon de dispersion de chaque nuage de points.
Cette séparabilité géométrique accrue valide de facto l’efficacité de la manipulation expérimentale à segmenter les profils comportementaux ou cognitifs des participants. Face à un F hautement élevé, la connaissance du score d’un individu sur la variable dépendante permet de prédire avec une probabilité largement supérieure au hasard le groupe expérimental auquel il appartenait, illustrant la puissance de discrimination du modèle.
4. La relation inverse entre la valeur F et la p-valeur
4.1 Positionnement sur la distribution théorique de Snedecor
L’interprétation probabiliste d’une valeur F observée requiert son inscription au sein de la famille des distributions de Fisher-Snedecor. Contrairement à la célèbre distribution normale de Gauss ou à la distribution t de Student qui arborent une symétrie bilatérale parfaite centrée sur zéro, la distribution F est continue, strictement non-négative (définie sur l’intervalle semi-ouvert [0, +∞[) et présente une asymétrie positive marquée, caractérisée par une longue traîne s’étirant vers la droite.
Cette forme découle mathématiquement du fait que F est le ratio de deux sommes de carrés indépendantes préalablement divisées par leurs degrés de liberté respectifs, chacune suivant une distribution du Chi-deux (χ2). Puisqu’une variance ou une somme de carrés ne peut physiquement adopter une valeur négative, le ratio F est contraint d’évoluer au-delà de zéro.
Lorsqu’une expérimentation débouche sur une valeur F empirique très élevée, cette dernière est projetée géographiquement dans les confins extrêmes de la queue droite de la distribution théorique de Snedecor. Or, par définition du calcul des probabilités en inférence statistique continue, la p-valeur (ou degré de signification) correspond à la surface résiduelle sous la courbe située au-delà de la valeur F observée, s’étendant jusqu’à l’infini :
p = P(Fthéorique ≥ Fobservé | H0)
Il existe par conséquent une relation d’interdépendance purement décroissante et monotone entre la statistique F et la p-valeur : à degrés de liberté constants, plus la valeur de F s’élève et progresse vers la droite, plus la surface résiduelle sous la courbe se rétrécit pour finalement devenir infinitésimale, indiquant une rareté extrême de l’observation sous l’égide de H0.
4.2 Seuils de décision et valeurs critiques conventionnelles
Le protocole décisionnel institué par l’approche de Neyman et Pearson exige de confronter la valeur F calculée à partir des données de l’expérience à une valeur seuil, appelée F critique (notée Fcrit ou Fα), paramétrée selon le niveau de risque d’erreur α consenti par le chercheur (conventionnellement fixé à 0,05 dans les sciences du comportement, ou à 0,01 dans les contextes biomédicaux à haute criticité) :
- Si Fobservé ≥ Fcritique (ce qui est strictement équivalent à p ≤ α), le test omnibus est décrété statistiquement significatif et l’hypothèse d’invariance est rejetée.
- Si Fobservé < Fcritique (soit p > α), l’expérimentateur échoue à rejeter l’hypothèse nulle, concluant à l’absence de preuve suffisante pour affirmer l’existence d’un effet.
La manifestation d’une valeur F extrême (par exemple, F = 52,43) s’accompagne invariablement d’une p-valeur extrêmement ténue, souvent libellée dans les progiciels statistiques sous la mention standardisée p < 0,001. Sur le plan opérationnel, cela signifie que si l’hypothèse nulle était rigoureusement vraie dans l’univers, la probabilité d’observer par simple accident d’échantillonnage une disparité de moyennes au moins aussi spectaculaire que celle constatée dans l’échantillon d’étude serait inférieure à une chance sur mille.
Il convient néanmoins de dissiper d’emblée une confusion épistémologique récurrente chez les apprentis chercheurs : la significativité probabiliste mesurée par une p-valeur minuscule ne saurait en aucun cas être amalgamée à la portée théorique ou à l’ampleur substantielle du phénomène découvert. Une p-valeur microscopique atteste uniquement de la certitude statistique que l’effet n’est pas nul, sans préjuger de sa pertinence clinique ou expérimentale dans le monde réel.
4.3 Utilisation d’outils de calcul et tables de distribution
Sur le plan historique et instrumental, la détermination de la valeur critique reposait sur l’usage méticuleux de tables de Fisher-Snedecor imprimées sur papier, compilant des matrices denses de valeurs critiques croisant les degrés de liberté du numérateur en colonnes et les degrés de liberté du dénominateur en lignes, pour un seuil α donné. Le chercheur parcourait visuellement la table pour identifier le seuil requis afin d’authentifier la validité de son rejet statistique.
À l’ère de l’informatique ubiquitaire, les progiciels contemporains (tels que R, Python via SciPy, SAS ou JASP) recourent à des algorithmes d’intégration numérique sophistiqués fondés sur la fonction bêta incomplète régularisée pour calculer la p-valeur exacte associée à n’importe quelle valeur F arbitraire avec une précision décimale redoutable :
Ix(a, b) où x = (df1 · F) / (df1 · F + df2)
Cette sophistication informatique confronte toutefois l’utilisateur à des particularités techniques lors de l’obtention de valeurs F démesurément grandes (dépassant parfois F = 500 dans des études comportementales à grand effectif). Les logiciels affichent alors fréquemment des avertissements de calcul ou des approximations terminales telles que p = 0.0000 ou p < 2.2e-16 en raison des limites de précision machine (le standard IEEE 754 pour les flottants à double précision). Le statisticien rigoureux saura interpréter cette sortie comme le signe d’un F titanesque sans jamais consigner dans son rapport académique l’hérésie théorique selon laquelle p serait rigoureusement égal à zéro, une probabilité continue ne pouvant s’annuler totalement sous une loi asymptotique.
5. Distribution d’échantillonnage de F et rôle critique des degrés de liberté
5.1 Impact des degrés de liberté du numérateur sur la géométrie de F
La statistique F présente la propriété d’appartenir à une famille paramétrique de lois dont la morphologie géométrique dépend étroitement d’un couple indissociable de paramètres : les degrés de liberté du numérateur (df1 = k – 1) et ceux du dénominateur (df2 = N – k). Il est mathématiquement erroné d’appréhender une valeur F dans l’absolu sans connaître la courbure que lui confèrent ces paramètres.
Les degrés de liberté du numérateur sont régis directement par le nombre de groupes comparés dans le plan expérimental. Lorsque df1 = 1 (ce qui correspond au cas particulier où l’ANOVA teste deux groupes, devenant l’exact équivalent quadratique d’un test t de Student indépendant où F = t2), la distribution de Snedecor adopte une morphologie concave singulière : la densité de probabilité plonge vertigineusement depuis l’axe des ordonnées, tendant asymptotiquement vers l’infini au voisinage immédiat de F = 0.
À l’inverse, dès lors que le chercheur multiplie les conditions et que le nombre de groupes s’élève (df1 ≥ 2, puis ≥ 5 ou 10), la silhouette de la distribution se métamorphose : elle s’arrondit pour présenter un sommet unimodal bien défini s’écartant de l’origine. L’étalement de la courbe se redistribue, et le seuil critique Fcrit nécessaire pour proclamer un résultat significatif diminue progressivement. Ce phénomène reflète la pondération de la complexité du plan expérimental : à mesure que le nombre de degrés de liberté du numérateur s’élargit, le test global agrège davantage de dimensions de variabilité pour tester l’écart entre les multiples conditions.
5.2 Rôle stabilisateur des degrés de liberté du dénominateur
Si les degrés de liberté du traitement dictent la géométrie générale du sommet de la courbe, les degrés de liberté du dénominateur (df2 = N – k) exercent un pouvoir stabilisateur déterminant sur l’ensemble du système inférentiel. Ce paramètre, indexé directement sur le volume global de l’échantillon, contrôle la précision avec laquelle la variance d’erreur σ2 est estimée dans l’expérience.
Lorsque la taille d’échantillon est restreinte (par exemple, df2 ≤ 10, ce qui advient fréquemment lors d’études animales précliniques ou de protocoles exploratoires d’imagerie par résonance magnétique fonctionnelle), l’estimateur de l’erreur MSIntra est intrinsèquement volatile et sujet à d’amples fluctuations d’échantillonnage. En conséquence, la queue droite de la distribution théorique de Snedecor devient particulièrement épaisse et lourde, imposant des valeurs critiques Fcrit vertigineuses pour espérer franchir le cap de la significativité statistique (pour df1 = 2 et df2 = 4, le F critique au seuil 0,05 s’élève à 6,94).
À l’inverse, au fur et à mesure que la cohorte de participants s’étoffe et que df2 progresse vers des centaines ou des milliers d’observations, la variance d’échantillonnage de l’estimation de l’erreur se comprime selon la loi des grands nombres. La distribution de F converge de manière asymptotique, et la valeur critique s’abaisse pour se stabiliser (pour df1 = 2 et df2 = 1000, le F critique s’établit à seulement 3,00). Dès lors, dans le cadre d’échantillons massifs, l’obtention d’une valeur F élevée devient mécaniquement beaucoup plus facile à arracher à la distribution, même face à des oscillations expérimentales de modeste envergure.
5.3 Interaction entre puissance statistique et taille de l’échantillon
Cette articulation mathématique dévoile l’interaction intime qui lie la mécanique du ratio F à la puissance statistique — définie comme la probabilité (1 – β) de détecter un effet réel existant dans la population. Il est capital de prendre conscience que la valeur empirique F est directement fonction de la taille de l’échantillon N. Pour une même amplitude d’écart entre des moyennes expérimentales et une même dispersion interne :
F ∝ n · δ2
où n représente la taille des sous-groupes et δ la taille standardisée de la différence entre les conditions.
En gonflant massivement les effectifs recrutés dans une étude, un expérimentateur peut artificiellement démultiplier la valeur du ratio F, transformant une divergence moyenne imperceptible et dénuée de sens substantiel en un résultat affichant un F spectaculaire de 85,30 accompagné d’un p < 0,000001. Ce phénomène engendre un risque méthodologique insidieux : l’inflation de la significativité mécanique, conduisant à des conclusions triomphalistes sur des effets qui ne sont en réalité que des bruits microscopiques capturés par la loupe démesurée d’un échantillon gigantesque.
Pour prévenir cette dérive épistémologique, la méthodologie contemporaine impose de dissocier formellement la puissance du test de la simple chasse aux grands nombres. Il est impératif de procéder à une planification a priori de la puissance statistique (notamment via des logiciels dédiés comme G*Power). Une telle démarche permet de calibrer N afin d’atteindre une puissance conventionnelle idéale (généralement 0,80 ou 0,90) calibrée précisément pour détecter une taille d’effet théoriquement signifiante, prévenant à la fois le sous-dimensionnement chronique et le sur-dimensionnement inflationniste de la statistique F.
6. Interprétation d’un F élevé dans la recherche en psychologie
6.1 Validation des manipulations expérimentales en laboratoire
Dans l’écosystème de la psychologie expérimentale et des neurosciences cognitives de laboratoire, l’apparition d’un F élevé lors du dépouillement des données remplit avant tout une fonction cruciale d’attestation méthodologique : elle valide l’efficacité opérationnelle des manipulations induites par l’expérimentateur. Lorsque des sujets sont soumis à des protocoles d’amorçage sémantique, d’induction émotionnelle par stimuli audiovisuels ou de charge de mémoire de travail, l’obtention d’un ratio F substantiel confirme que le paradigme a effectivement altéré l’architecture cognitive des participants de manière congruente aux hypothèses.
Considérons, à titre d’illustration, une recherche en psychopharmacologie cognitive évaluant les effets différentiels d’un nouvel agoniste dopaminergique sur la consolidation mémorielle chez le rongeur ou chez l’humain à travers quatre dosages progressifs (Placebo, 5 mg, 15 mg, 30 mg). Un résultat stipulant F(3, 116) = 28,75, p < 0,001 démontre de façon percutante que la cinétique de la substance active module les scores de rétention bien au-delà de la variance biologique individuelle. La force du ratio F sert ici de baromètre attestant que le système neurobiologique ciblé répond vigoureusement à l’amplitude du traitement administré.
De surcroît, le calcul d’un F élevé s’avère indispensable pour administrer les contrôles de manipulation (manipulation checks). Avant même de tester une hypothèse causale complexe sur un comportement social ultérieur, le chercheur doit administrer une ANOVA sur ses échelles de contrôle afin de vérifier que son induction (par exemple, induire un état de stress aigu versus une condition de relaxation) a généré un F massif sur les mesures physiologiques de cortisol ou les auto-questionnaires d’anxiété état, attestant de l’intégrité de la variable indépendante.
6.2 Applications en psychologie clinique et psychothérapie comparée
Dans le domaine de la psychologie clinique et de la recherche translationnelle en psychiatrie, l’ANOVA et son ratio F constituent l’épine dorsale des essais contrôlés randomisés (ECR) comparant les thérapies empiriquement validées. Supposons une étude clinique randomisée comparant l’efficacité sur la réduction des symptômes du trouble de stress post-traumatique (mesurée via l’échelle PCL-5) de trois approches distinctes : la thérapie cognitivo-comportementale axée sur le traumatisme (TCC-T), l’intégration neuro-émotionnelle par les mouvements oculaires (EMDR) et une condition de liste d’attente active.
L’observation d’une valeur F élevée au terme de la période de prise en charge apporte la démonstration méthodologique formelle que la divergence observée entre l’efficacité des protocoles thérapeutiques prévaut structurellement sur l’immense hétérogénéité individuelle propre aux trajectoires psychopathologiques des patients. Dans un domaine clinique où la variance résiduelle (MSIntra) est traditionnellement exacerbée en raison de la variabilité des traits de personnalité, des comorbidités latentes et de l’alliance thérapeutique, parvenir à dégager un F hautement significatif représente une preuve éclatante de la supériorité d’un ou plusieurs modèles cliniques par rapport au groupe contrôle.
Cette rigueur inférentielle offerte par un F élevé permet ainsi de prémunir les praticiens contre les écueils des intuitions cliniques subjectives en objectivant l’existence d’une divergence thérapeutique tangible, ouvrant la voie à des recommandations éclairées pour la santé publique.
6.3 Différenciation inter-individuelle en psychométrie et psychologie différentielle
La psychologie différentielle et le développement psychométrique mobilisent également la machinerie de l’ANOVA dans le cadre de devis corrélationnels ou quasi-expérimentaux où la variable indépendante n’est pas manipulée en laboratoire, mais correspond à des typologies de sujets ou à des segments démographiques naturels. Les chercheurs s’intéressent alors à la capacité de tests psychométriques à discriminer finement différentes sous-populations.
À titre d’exemple, lors de l’étalonnage d’un instrument mesurant les capacités de flexibilité cognitive et les fonctions exécutives chez l’adulte, les investigateurs compareront les scores normés obtenus à travers différentes tranches d’âge (20-39 ans, 40-59 ans, 60-79 ans, 80 ans et plus). Un F substantiel — par exemple F(3, 496) = 45,12, p < 0,001 — valide l’hypothèse de l’involution neurocognitive liée au vieillissement et confirme la sensibilité du test psychométrique à capturer cette transition développementale.
Toutefois, dans ces designs transversaux non expérimentaux, l’interprétation d’un F élevé requiert une prudence épistémologique décuplée. L’assignation aléatoire faisant défaut, une valeur F imposante n’autorise aucunement une déduction causale directe. Les facteurs de confusion systématiques non contrôlés — tels que les effets de cohorte socioculturels, les disparités de niveau d’éducation ou l’état de santé générale — peuvent gonfler artificiellement la variance intergroupe (MSInter), générant un F imposant qui ne reflète en rien le processus chronologique sous-jacent, mais plutôt des distorsions d’échantillonnage transversales.
7. Ce qu’une valeur F élevée ne vous dit pas : Les limites inhérentes
7.1 La nature omnibus du test : L’indétermination des paires divergentes
En dépit de sa puissance analytique indéniable, la statistique F présente une limitation épistémologique congénitale que tout analyste doit impérativement garder à l’esprit : son caractère strictement « omnibus ». Le test F se comporte comme un signal d’alarme global révélant l’hétérogénéité générale d’un système de moyennes, mais s’avère fondamentalement aveugle quant à l’architecture exacte de cette hétérogénéité.
Une valeur F spectaculaire (par exemple, F = 34,18, p < 0,0001) obtenue sur un plan d’expérience à quatre groupes informe l’observateur qu’au moins une divergence significative existe au sein du quatuor, mais ne divulgue strictement aucun indice quant à la localisation précise du contraste. Une même valeur F massive peut découler de configurations structurales totalement discordantes :
- Un scénario où le groupe 1 surpasse très largement les groupes 2, 3 et 4, ces trois derniers étant parfaitement homogènes entre eux.
- Un scénario où les groupes 1 et 2 sont similaires, mais divergent radicalement des groupes 3 et 4 réunis en un autre pôle.
- Un scénario où les quatre moyennes s’échelonnent selon un gradient linéaire continu et régulier sans qu’aucune paire ne soit identique.
L’erreur méthodologique classique consiste à commettre le paralogisme d’homogénéisation, qui postule naïvement qu’un F élevé atteste que toutes les conditions se différencient mutuellement de façon bilatérale. L’obtention d’un F imposant ne marque donc jamais la fin du voyage analytique : elle constitue simplement le point de départ d’une déconstruction minutieuse du plan expérimental via des investigations complémentaires.
7.2 L’absence d’indication sur le sens ou la direction des écarts
Une autre propriété mathématique essentielle de la statistique F réside dans son caractère intrinsèquement non directionnel au niveau bilatéral. Puisque le numérateur de F (la somme des carrés intergroupes) repose sur l’élévation au carré des écarts entre les moyennes de groupe et le grand barycentre (Ȳj – Ȳ•)2, tout signe négatif est algébriquement annihilé lors de la sommation. Il en résulte que la statistique F traite une déviation positive avec une indifférence mathématique absolue par rapport à une déviation négative d’égale amplitude.
En conséquence, une valeur F hautement significative est parfaitement compatible avec un résultat qui invaliderait de fond en comble l’hypothèse théorique de travail de l’expérimentateur. Imaginons qu’un chercheur formule l’hypothèse qu’un entraînement cognitif informatisé intensif augmentera les facultés d’attention sélective par rapport à un entraînement témoin. Si, à la suite d’un phénomène imprévu d’épuisement mental ou de surcharge cognitive, le groupe expérimental s’effondre lamentablement et présente des performances dramatiquement inférieures au groupe témoin, l’ANOVA produira exactement la même valeur F élevée que si l’intervention avait été un triomphe phénoménal.
Interpréter un F élevé sans procéder à l’inspection minutieuse de la direction des moyennes empiriques observées et de leurs intervalles de confiance constitue ainsi un contresens scientifique majeur susceptible de conduire à des conclusions inverses à la réalité expérimentale.
7.3 La non-équivalence stricte entre significativité et importance clinique
L’illusion la plus pernicieuse qui guette l’utilisateur de l’ANOVA consiste à opérer une équivalence fallacieuse entre significativité statistique (marquée par un F élevé associé à une p-valeur infinitésimale) et importance pratique ou pertinence clinique (clinical relevance). Comme nous l’avons souligné dans l’analyse de la puissance statistique, la valeur F est le produit direct de la magnitude de l’effet conjuguée à la taille globale de l’échantillon d’étude.
Dans les enquêtes épidémiologiques massives ou les méga-données numériques contemporaines agrégeant des cohortes de dizaines de milliers de participants, des écarts de moyennes d’une banalité affligeante — par exemple, une différence de 0,5 point sur une échelle de bien-être mesurée sur 100 points — généreront des ratios F monumentaux de l’ordre de F = 78,5, p < 10-15. Le test omnibus rejette catégoriquement l’égalité parfaite des moyennes sous H0, mais le phénomène capturé n’a rigoureusement aucune incidence dans l’existence réelle des personnes.
En santé mentale et en psychométrie clinique, cette dissociation a conduit à forger le concept cardinal de Changement Clinique Minimalement Signifiant (en anglais, Minimal Clinically Important Difference, MCID). Une thérapie peut produire un test F astronomique face à un placebo sans pour autant que l’amplitude de l’amélioration ne permette au patient de franchir le seuil d’une rémission fonctionnelle perceptible dans son quotidien. L’évaluation de la pertinence d’un résultat exige dès lors d’adjoindre systématiquement à l’examen de F la quantification précise de la taille de l’effet.
8. Analyses post-hoc indispensables après l’obtention d’un F élevé
8.1 Contrôle du taux d’erreur par famille de comparaisons
Dès lors que la statistique F franchit triomphalement le seuil critique α et scelle le rejet de l’hypothèse nulle globale, l’investigateur se trouve confronté à l’impérieuse nécessité de disséquer ce résultat omnibus pour localiser avec précision les contrastes intergroupes victorieux. Cependant, se précipiter à ce stade sur des séries de tests t de Student bilatéraux non corrigés pour explorer toutes les paires envisageables ruinerait instantanément la protection probabiliste offerte par l’ANOVA en réactivant l’inflation dramatique de l’erreur de type I.
Pour parer à cette dérive, la statistique inférentielle a développé un arsenal d’analyses post-hoc spécialement architecturées pour contrôler le taux d’erreur par famille de comparaisons (Familywise Error Rate, FWER), c’est-à-dire garantir que la probabilité cumulée de déclarer au moins un faux positif au cours de l’ensemble des comparaisons par paires menées sur le jeu de données ne dépasse jamais le seuil α initialement consenti (habituellement 0,05).
Ces procédures déploient des stratégies d’ajustement algorithmique de sévérité variable, arbitrées par un dilemme permanent entre la prévention des faux positifs (conservatisme excessif) et la capacité à détecter des divergences authentiques (préservation de la puissance statistique). Parmi les approches les plus renommées :
- La correction de Bonferroni, simple mais rigide, qui divise uniformément le seuil α par le nombre total de comparaisons planifiées (k(k – 1) / 2).
- Le test de Scheffé, d’une grande rigueur mathématique, conçu pour autoriser l’exploration de tous les contrastes linéaires possibles, simples ou complexes, mais réputé très conservateur pour de simples comparaisons binaires.
- La méthode de Tukey, spécifiquement calibrée pour comparer toutes les paires de moyennes sans pénalité excessive.
8.2 Le test HSD de Tukey pour les comparaisons par paires non planifiées
Pour procéder à l’exploration exhaustive de l’ensemble des comparaisons par paires lorsque l’expérimentateur n’avait pas formulé d’hypothèses directionnelles rigides avant la collecte des données, le test HSD de Tukey (Honestly Significant Difference) s’impose comme l’étalon-or dans la littérature internationale.
Le test de Tukey ne s’appuie pas sur la loi t de Student standard, mais fonde ses calculs sur la distribution de l’étendue studentisée (la variable aléatoire q). Cette modélisation évalue l’écart séparant la moyenne la plus élevée et la moyenne la plus basse observées parmi un ensemble de k groupes. La formule pour tester la différence entre deux moyennes Ȳi et Ȳj se formalise ainsi :
q = |Ȳi – Ȳj| / √(MSIntra / n)
pour des échantillons de tailles égales n.
En exploitant directement l’estimateur de la variance d’erreur de l’ANOVA globale (MSIntra) au dénominateur, le test de Tukey bénéficie d’une stabilité mathématique bien supérieure à celle de tests indépendants isolés. Il permet de générer des intervalles de confiance ajustés simultanés à 95 % pour chaque paire de moyennes envisageable :
CI95% = (Ȳi – Ȳj) ± qcrit · √(MSIntra / n)
Si cet intervalle ajusté englobe la valeur zéro, l’égalité des moyennes concernées ne peut être rejetée. À l’inverse, si zéro demeure exclu de l’intervalle, la divergence entre cette paire est proclamée « honnêtement significative ». La procédure de Tukey-Kramer offre une extension analytique robuste de cet algorithme pour pallier d’éventuels déséquilibres légers dans les effectifs des groupes.
8.3 Contrastes planifiés a priori : Alternative élégante aux tests post-hoc
Bien que la séquence canonique « ANOVA globale avec F élevé, puis tests post-hoc non ciblés » soit largement répandue dans les publications empiriques, elle témoigne souvent d’une approche exploratoire semi-inductive. Les canons de l’épistémologie déductive contemporaine privilégient une alternative méthodologiquement plus puissante et théoriquement plus raffinée : le recours aux contrastes planifiés a priori.
Lorsque le chercheur élabore son protocole, son cadre théorique sous-jacent prescrit généralement des attentes prédictives hautement spécifiques quant aux relations attendues entre les conditions (par exemple, formuler l’hypothèse que la moyenne combinée de deux nouvelles thérapies actives surpassera la moyenne du groupe témoin). Les contrastes planifiés formalisent ces attentes sous la forme d’équations de pondération linéaire appliquées aux moyennes :
L = ∑ cj μj sous la contrainte stricte que ∑ cj = 0
où cj représente le coefficient numérique assigné au groupe j.
Lorsque ces contrastes sont configurés pour être mutuellement indépendants (contrastes orthogonaux), ils opèrent un partitionnement exact et exhaustif de la somme des carrés intergroupes (SSInter) en composantes indépendantes dotées chacune d’un unique degré de liberté. Chaque contraste est alors directement évalué via sa propre statistique F spécifique dotée d’une puissance statistique considérablement supérieure à celle des tests post-hoc d’exploration générale, éliminant le besoin de pénalités correctrices draconiennes pour comparaisons multiples.
9. Taille de l’effet versus valeur F : Éviter le piège de la significativité mécanique
9.1 Le coefficient Eta-carré (η²) : Proportion brute de variance expliquée
Pour neutraliser le biais d’échelle lié à la dépendance mécanique de la valeur F vis-à-vis du volume d’échantillon N, le recours aux indices standardisés de taille de l’effet constitue une obligation épistémologique et méthodologique incontournable. Le premier et le plus intuitif de ces descripteurs dans le cadre de l’analyse de variance est le coefficient Êta-carré (η²).
L’Êta-carré se définit mathématiquement comme le ratio direct entre la somme des carrés attribuée au traitement et la somme totale des carrés des écarts mesurés sur l’ensemble de l’expérience :
η² = SSInter / SSTotal
Sur le plan conceptuel, cet indice s’interprète avec une simplicité transparente : il quantifie la proportion brute (ou le pourcentage) de la variance globale de la variable dépendante qui se trouve expliquée ou imputable à l’assignation aux différents groupes expérimentaux. Un coefficient η² de 0,25 indique ainsi de façon limpide qu’un quart de la variabilité mesurée chez les participants s’explique par la manipulation de la variable indépendante.
Jacob Cohen a formalisé dans ses travaux séminaux des repères d’interprétation conventionnels (benchmarks) — bien qu’ils doivent toujours être contextualisés au regard de la discipline — pour situer l’ampleur d’un effet :
- Effet faible : η² ≈ 0,01 (environ 1 % de variance expliquée)
- Effet moyen : η² ≈ 0,06 (environ 6 % de variance expliquée)
- Effet fort : η² ≥ 0,14 (14 % de variance expliquée ou davantage)
Néanmoins, en dépit de sa commodité descriptive, l’Êta-carré souffre d’un défaut structurel majeur : il constitue un estimateur purement descriptif et échantillon-dépendant, affichant une tendance intrinsèque systématique à surestimer (biais positif) la part réelle de variance expliquée dans la population générale de référence, tout particulièrement lorsque les échantillons d’étude sont réduits.
9.2 L’Eta-carré partiel (η²p) et l’Oméga-carré (ω²) : Des estimateurs plus raffinés
Face aux limites inhérentes à l’Êta-carré brut, la méthodologie quantitative contemporaine mobilise deux indices alternatifs dotés de propriétés analytiques nettement plus sophistiquées : l’Êta-carré partiel (η²p) et l’Oméga-carré (ω²).
L’Êta-carré partiel est spécialement préconisé dans l’analyse des designs multifactoriels complexes (ANOVA factorielles à deux facteurs ou plus). Il redéfinit le dénominateur pour isoler l’effet d’un facteur donné en purgeant la variance totale des parts captées par les autres facteurs manipulés :
η²p = SSEffet / (SSEffet + SSErreur)
Dans le cas strict d’une ANOVA univariée à un seul facteur, η² et η²p sont mathématiquement identiques. Cependant, dans les designs factoriels, η²p présente l’avantage d’évaluer la magnitude d’un facteur indépendamment du nombre d’autres variables introduites dans le modèle matriciel.
Sur le plan de l’inférence populationnelle non biaisée, le coefficient Oméga-carré (ω²), introduit originellement par William Hays, surpasse incontestablement l’Êta-carré. Conçu comme un véritable estimateur de paramètre populationnel, il incorpore explicitement les degrés de liberté et l’erreur quadratique moyenne afin de corriger mathématiquement le biais de surestimation inhérent aux petits échantillons :
ω² = [SSInter – (k – 1) · MSIntra] / [SSTotal + MSIntra]
Si la valeur calculée au numérateur devient négative (ce qui survient lorsque le ratio F glisse sous l’unité), l’Oméga-carré est simplement tronqué à zéro. En psychologie et en sciences comportementales, où les cohortes dépassent rarement quelques dizaines de sujets par cellule expérimentale, l’Oméga-carré offre une estimation sobre, réaliste et non gonflée de l’impact substantiel du traitement, protégeant les chercheurs contre l’optimisme trompeur des estimations brutes.
9.3 Dissociation empirique : Valeur F titanesque versus taille d’effet marginale
La compréhension approfondie du comportement du ratio F culmine dans l’intégration de ce paradoxe statistique fondamental : il n’existe aucune corrélation linéaire absolue entre la magnitude brute du ratio F et l’importance pratique de la taille de l’effet. L’équation de conversion unissant directement F à l’Êta-carré partiel en apporte une démonstration analytique irréfutable :
η²p = (df1 · F) / [df1 · F + df2]
F = [η²p / (1 – η²p)] · (df2 / df1)
Cette relation explicite mathématiquement le rôle d’amplificateur démesuré joué par le terme df2 / df1. Examinons le cas empirique d’une étude d’épidémiologie génétique ou d’une analyse comportementale issue d’une cohorte numérique en ligne compilant N = 20 000 participants répartis en quatre groupes (df1 = 3 ; df2 = 19 996). Si la taille de l’effet réel est dérisoire, par exemple un η² = 0,004 (ce qui indique que la manipulation n’explique que 0,4 % de la variance), la résolution de la formule génère la statistique F suivante :
F = [0,004 / (1 – 0,004)] · (19 996 / 3) ≈ 0,004016 · 6 665,33 ≈ 26,77
Le chercheur se retrouve ainsi en possession d’un ratio F imposant de 26,77 associé à une p-valeur astronomiquement minuscule (p ≈ 10-17). Déclarer ce résultat sur la seule foi de son F triomphant laisserait croire à la découverte d’un phénomène expérimental majeur, alors qu’il ne s’agit en réalité que de la capture hyper-précise d’une micro-variation quantitative sans portée pratique.
C’est précisément pour éradiquer cette illusion méthodologique que l’ensemble des comités de lecture des revues scientifiques internationales (notamment sous les recommandations de l’American Psychological Association) interdisent désormais formellement de publier un résultat d’ANOVA sans assortir scrupuleusement le ratio F d’une mesure standardisée de taille d’effet et de son intervalle de confiance.
10. Robustesse et violations des postulats face à une valeur F anormalement élevée
10.1 L’hypothèse d’homogénéité des variances (homoscédasticité)
La validité mathématique du ratio F repose sur le respect de postulats stochastiques précis régissant le comportement des résidus du modèle linéaire. Au premier rang de ces exigences figure l’homoscédasticité, c’est-à-dire l’hypothèse stipulant que les variances de la variable dépendante au sein de chaque population sous-jacente sont strictement équivalentes :
σ12 = σ22 = … = σk2 = σ2
Cette condition est impérative car le dénominateur de l’ANOVA, MSIntra, est calculé en réalisant une moyenne arithmétique pondérée des variances internes de chaque groupe. Or, la statistique F classique de Fisher est notoirement vulnérable aux violations de cette hypothèse, tout particulièrement lorsque le plan d’expérience est asymétrique ou déséquilibré (présentant des tailles d’échantillons nj inégales entre conditions).
Deux configurations aux répercussions divergentes peuvent alors se matérialiser :
- Le cas conservateur : Les groupes aux effectifs les plus vastes présentent les variances les plus élevées. Dans cette situation, MSIntra est artificiellement surévalué, ce qui compresse le ratio F et accroît indûment le risque d’erreur de type II (β).
- Le cas libéral (très dangereux) : Les groupes associant de faibles effectifs présentent les variances résiduelles les plus massives. Dans ce scénario, le dénominateur MSIntra est sévèrement sous-estimé par rapport à la dispersion réelle, provoquant une explosion artificielle de la valeur F. Le test produit alors un F apparemment colossal qui n’est en fait qu’un artefact d’hétéroscédasticité, propulsant le taux d’erreur de première espèce (α) bien au-delà de 0,15 ou 0,20 au lieu du seuil théorique consenti de 0,05.
L’inspection diagnostique de l’homoscédasticité constitue de ce fait un préalable absolu à toute proclamation triomphale d’un F significatif, traditionnellement validée via le test de Levene (plus robuste aux écarts à la normalité) ou le test de Bartlett.
10.2 Alternatives robustes en cas d’hétéroscédasticité : ANOVA de Welch et Brown-Forsythe
Lorsque les tests diagnostiques confirment la faillite du postulat d’homoscédasticité (p < 0,05 au test de Levene), le chercheur ne doit en aucun cas se fier à la statistique F standard issue du modèle de Fisher. Il convient d’abandonner l’estimateur classique au profit d’alternatives robustes spécialement calibrées pour résister à l’hétérogénéité des variances : les tests de Welch et de Brown-Forsythe.
L’ANOVA de Welch applique une pondération inverse sophistiquée : plutôt que de moyenner passivement les variances, elle attribue à chaque condition un poids wj qui est fonction inverse de sa propre variance d’échantillon (wj = nj / sj2). Simultanément, la méthode ajuste arithmétiquement les degrés de liberté du dénominateur (df2), réduisant ce paramètre de manière fractionnaire pour refléter l’incertitude liée à l’instabilité des dispersions.
La statistique résultante, le F ajusté de Welch (noté FWelch), présente un comportement inférentiel exemplaire : face à des variances sauvagement asymétriques, elle ne s’emballe pas artificiellement et maintient le taux d’erreur α rigoureusement à sa valeur nominale de 5 %. Les plus éminents méthodologistes en sciences comportementales recommandent d’ailleurs d’adopter systématiquement l’ANOVA de Welch par défaut dans l’analyse de données expérimentales, dans la mesure où elle égale la puissance du test de Fisher traditionnel lorsque les variances sont homogènes, tout en offrant une immunité absolue en cas de rupture d’homoscédasticité.
10.3 Non-normalité résiduelle et présence de valeurs aberrantes (outliers)
L’autre pilier axiomatique de l’ANOVA repose sur l’hypothèse selon laquelle les résidus du modèle sont distribués selon une loi normale au sein de chaque population parente. Si le théorème central limite confère à l’ANOVA une excellente résilience face aux écarts modérés à la normalité lorsque les effectifs d’échantillons sont amples (par exemple, n > 30 par condition), la présence d’observations extrêmes ou aberrantes (outliers) peut gravement déstabiliser le calcul du ratio F.
L’élévation d’un score à la puissance carrée dans le calcul des sommes des carrés agit comme une lentille grossissante sur les déviations extrêmes. Une seule observation aberrante logée dans un groupe dont la moyenne était par ailleurs modeste peut exercer un effet de levier disproportionné, distordant mathématiquement la moyenne de cette modalité et amplifiant artificiellement la SSInter, ce qui gonfle le ratio F de manière factice. Dans d’autres circonstances, si l’observation aberrante s’écarte du barycentre de son propre groupe, elle fait enfler le dénominateur MSIntra, comprimant injustement un F qui aurait dû être significatif.
Le diagnostic de ces distorsions impose une inspection graphique méthodique des distributions (via les boîtes à moustaches ou boxplots, les diagrammes quantile-quantile Q-Q) et le recours aux métriques de levier telles que la distance de Cook. Si la non-normalité résiduelle est irréductible ou les valeurs aberrantes indéniables sans motif d’exclusion légitime, l’analyste se tournera vers l’ANOVA non paramétrique sur rangs de Kruskal-Wallis ou vers les techniques contemporaines de rééchantillonnage par bootstrap et de statistiques robustes fondées sur les moyennes tronquées (trimmed means de Wilcox).
11. Études de cas pratiques en psychologie expérimentale
11.1 Cas 1 : Impact d’un entraînement cognitif sur la mémoire de travail
Pour illustrer de manière concrète l’interprétation d’une valeur F élevée, examinons une étude contrôlée randomisée menée en psychologie cognitive évaluant l’efficacité d’un entraînement exécutif informatisé. Soixante participants sont aléatoirement distribués au sein de trois conditions indépendantes (n = 20 par groupe) : un groupe Contrôle passif (sans intervention), un groupe Programme A (entraînement générique d’attention) et un groupe Programme B (entraînement adaptatif ciblé sur la mise à jour en mémoire de travail de type n-back). La variable dépendante est le score obtenu à une épreuve complexe d’empan de lecture (Reading Span Test) post-intervention.
Le traitement informatique des données brutes délivre le tableau d’ANOVA suivant :
- Somme des carrés intergroupes (SSInter) : 412,40 avec df1 = 3 – 1 = 2. D’où MSInter = 412,40 / 2 = 206,20.
- Somme des carrés intragroupes (SSIntra) : 793,00 avec df2 = 60 – 3 = 57. D’où MSIntra = 793,00 / 57 = 13,91.
- Calcul de la statistique F : Fobservé = 206,20 / 13,91 = 14,82.
En consultant la distribution de Fisher pour (2, 57) degrés de liberté, la valeur critique pour un risque α = 0,05 s’établit à approximativement 3,16. Notre valeur empirique F = 14,82 pulvérise ce seuil critique, générant une probabilité conditionnelle p = 0,0000078 (soit p < 0,001). L’hypothèse nulle d’égalité des scores d’empan est révoquée sans ambiguïté. Le calcul de la taille d’effet révèle un η² = 412,40 / (412,40 + 793,00) = 0,342, attestant qu’une part massive de 34,2 % de la variance des scores d’empan est directement attribuable au type de programme suivi.
Toutefois, la nature omnibus de ce F imposant ne permet pas d’affirmer d’emblée la supériorité du Programme B. L’administration d’un test post-hoc HSD de Tukey est alors réalisée. Elle met en lumière une absence de différence significative entre le groupe Contrôle (M = 28,4) et le Programme A (M = 29,8 ; p = 0,42), mais démontre une divergence majeure entre le Programme B (M = 35,1) et les deux autres modalités (les deux p < 0,001). Ce cas clinique illustre parfaitement comment un F global élevé est décortiqué avec précision pour circonscrire le bénéfice thérapeutique à une modalité spécifique.
11.2 Cas 2 : Effet du stress aigu sur le temps de réaction motrice
Considérons à présent une expérimentation en ergonomie cognitive et psychologie ergonomique analysant l’impact du stress aigu induit par pression temporelle et évaluation sociale sur la vitesse d’évitement d’un obstacle dans un simulateur de conduite d’engins industriels. Quatre-vingts opérateurs sont affectés à quatre niveaux de stress standardisés (n = 20 par cellule) : Stress Nul, Stress Faible, Stress Modéré et Stress Sévère. La variable mesurée est le temps de réaction motrice exprimé en millisecondes.
L’analyse statistique extrait une valeur F modérément élevée :
F(3, 76) = 4,12 ; p = 0,009 ; MSIntra = 1 450
Le ratio dépasse le seuil critique (Fcrit ≈ 2,73), validant le rejet de l’invariance globale au seuil α = 0,05. Le statisticien consciencieux calcule l’Oméga-carré pour obtenir un estimateur non biaisé en population générale :
ω² = [SSInter – (4 – 1) · 1 450] / [SSTotal + 1 450] = 0,105
L’Oméga-carré révèle que la manipulation du stress explique environ 10,5 % de la variance populationnelle des temps de réaction, ce qui caractérise un effet d’envergure intermédiaire à forte selon les critères de Cohen. Sur le plan de l’application industrielle, bien que le ratio F ne soit pas titanesque (4,12), la taille d’effet substantielle valide des aménagements ergonomiques prioritaires visant à réguler la charge mentale des opérateurs pour éviter les ralentissements d’évitement en situation de crise.
11.3 Cas 3 : Piège méthodologique d’un échantillon géant dans une enquête en ligne
Ce troisième scénario dissèque l’illusion méthodologique fréquemment rencontrée à l’ère des mégadonnées et des protocoles de crowdsourcing sur le Web (Amazon Mechanical Turk ou Prolific). Une équipe de chercheurs en psychologie sociale diffuse un questionnaire évaluant l’adhésion à une préférence esthétique sur une échelle de Likert en 7 points auprès d’un échantillon massif de dix mille répondants (N = 10 000). Les participants sont catégorisés en trois groupes selon leur lieu de résidence : Métropole urbaine, Zone périurbaine et Milieu rural (soit approximativement 3 333 sujets par groupe).
Le traitement par ANOVA délivre une statistique F spectaculaire :
F(2, 9997) = 35,40 ; p = 2,7 × 10⁻¹⁶
L’examinateur inexpérimenté pourrait s’enthousiasmer devant ce F monumental et cette p-valeur infinitésimale pour proclamer une divergence sociologique majeure des sensibilités esthétiques selon les territoires géographiques. Cependant, le calcul minutieux de la taille d’effet ramène instantanément l’observateur à la réalité empirique :
η² = (2 · 35,40) / [ (2 · 35,40) + 9 997 ] ≈ 70,8 / 10 067,8 ≈ 0,0070
L’indice η² s’établit à 0,007, ce qui atteste que l’assignation géographique n’explique que 0,7 % de la variabilité des préférences exprimées, une proportion dérisoire. L’inspection des moyennes empiriques confirme cette platitude : MUrbain = 4,12 ; MPériurbain = 4,21 ; MRural = 4,28 sur une échelle s’étirant de 1 à 7. La divergence entre les groupes n’atteint même pas deux dixièmes de point d’écart. Ce cas d’école démontre comment la puissance statistique titanesque conférée par un méga-échantillon peut transmuer une poussière d’effet en un F massif, illustrant le danger d’une foi aveugle accordée à la seule statistique F déconnectée de son ampleur écologique.
12. Guide de rédaction et rapport normé d’une valeur F élevée selon les normes APA
12.1 Règles stylistiques et syntaxiques de la 7e édition de l’APA
La formalisation académique des résultats d’un test statistique constitue une compétence technique essentielle pour tout chercheur aspirant à diffuser ses travaux dans des revues internationales sous les standards de l’American Psychological Association (APA 7e édition). La description d’une statistique F obéit à des contraintes typographiques rigides et immuables.
La structure formelle canonique s’agence selon le gabarit suivant :
F(dfnumérateur, dfdénominateur) = [valeur de F], p = [p-valeur], [taille d’effet avec CI]
Les conventions typographiques imposent les impératifs suivants :
- La lettre F ainsi que la lettre p et les lettres grecques symbolisant la taille d’effet (η²p, ω²) doivent être systématiquement composées en italique.
- Les degrés de liberté sont insérés entre parenthèses immédiatement après la lettre F, sans espace, séparés par une virgule suivie d’un espace :
F(2, 57). - Les valeurs scalaires de la statistique F doivent être arrondies rigoureusement à deux décimales (par exemple,
F(2, 57) = 14,82). - Concernant la p-valeur, les normes APA préconisent de rapporter la valeur décimale exacte arrondie à trois décimales lorsqu’elle se situe au-delà de 0,001 (ex. :
p = .024oup = .008, en omettant le zéro précédant le séparateur décimal selon les normes anglophones de publication). En revanche, lorsque la p-valeur est infinitésimale et s’effondre sous le seuil d’un millième, il est strictement interdit d’écrirep = .000; il convient impérativement d’utiliser la mention tronquéep < .001. - L’association systématique d’une mesure standardisée de taille de l’effet, assortie de son intervalle de confiance à 90 % ou 95 %, est formellement exigée par les comités de rédaction internationaux.
12.2 Exemples concrets de formulations académiques pour manuscrits
Pour illustrer la fluidité rédactionnelle attendue au sein de la section « Résultats » d’un manuscrit scientifique de haut rang, examinons deux formulations exemplaires respectant scrupuleusement l’orthodoxie méthodologique et articulant la statistique omnibus avec les investigations complémentaires.
Exemple 1 : Rapport d’une ANOVA univariée significative suivie de tests de Tukey :
« Une analyse de variance univariée à un facteur a été conduite pour évaluer l’incidence du type d’intervention sur les performances de mémoire de travail. Les analyses révèlent un effet principal hautement significatif du protocole thérapeutique, F(2, 57) = 14,82, p < 0,001, η²p = 0,34, IC 95 % [0,16, 0,48]. Des comparaisons post-hoc conduites à l’aide du test HSD de Tukey indiquent que les participants assignés au Programme B (M = 35,10, SD = 3,65) présentent des scores d’empan significativement plus élevés que ceux du groupe Programme A (M = 29,80, SD = 3,82 ; p < 0,001, d = 1,42) et que ceux du groupe Contrôle (M = 28,40, SD = 3,71 ; p < 0,001, d = 1,82). En revanche, aucune divergence significative n’a été détectée entre le Programme A et le groupe Contrôle (p = 0,421, d = 0,37). »
Exemple 2 : Rapport en présence d’une hétérogénéité des variances nécessitant le test de Welch :
« Le test de Levene ayant mis en évidence une violation flagrante du postulat d’homogénéité des variances, F(3, 76) = 5,84, p = 0,001, l’ANOVA robuste de Welch a été substituée au modèle classique de Fisher. Les résultats confirment l’existence d’une modulation statistiquement significative des temps de réaction par le stress, FWelch(3, 38,42) = 6,29, p = 0,001, ω² = 0,11. Les contrastes planifiés attestent que l’élévation du stress au stade sévère entraîne une dégradation linéaire marquée de la rapidité motrice comparativement aux paliers physiologiques basaux. »
12.3 Représentation graphique conjointe des résultats statistiques
La communication scientifique de pointe ne saurait se borner à l’alignement de valeurs textuelles : elle exige une symbiose visuelle harmonieuse entre la prose démonstrative et la sémiologie graphique. Dans les manuscrits normés, la figuration d’un F élevé gagne à abandonner les traditionnels graphiques en barres pleines (bar plots) — fréquemment qualifiés de « graphiques dynamiques de détritus » par les biostatisticiens contemporains en raison de leur propension à masquer l’hétérogénéité sous-jacente — au profit de visualisations denses et transparentes telles que les diagrammes en violon (violin plots) ou les graphiques de dispersion individuels superposés avec boîtes à moustaches.
Quelle que soit la typologie graphique sélectionnée, l’intégration des indicateurs d’incertitude est obligatoire selon les normes APA :
- Chaque moyenne doit être obligatoirement flanquée d’une barre d’erreur matérialisant soit l’erreur type de la moyenne (Standard Error, SE), soit préférentiellement l’intervalle de confiance à 95 % (CI 95 %).
- La légende de la figure doit obligatoirement expliciter la nature exacte de ces barres d’erreur (par exemple :
Les barres d'erreur représentent l'intervalle de confiance à 95 % de la moyenne). - L’incorporation d’annotations visuelles horizontales reliant les groupes mutuellement distincts (avec astérisques standardisés :
* p < .05,** p < .01,*** p < .001) permet au lecteur d’appréhender instantanément la localisation des contrastes post-hoc victorieux confirmés par le test F omnibus.
En respectant scrupuleusement cette architecture formelle, le chercheur s’assure que la puissance probante de sa statistique F est transmise avec une clarté optique, analytique et épistémologique exemplaire, conférant à ses découvertes la crédibilité méthodologique qu’exige la science moderne.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Hays, W. L. (1994). Statistics (5th ed.). Harcourt Brace College Publishers.
Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
Snedecor, G. W., & Cochran, W. G. (1989). Statistical methods (8th ed.). Iowa State University Press.
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.2307/2332579
Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.