
L’investigation empirique au sein des sciences du comportement repose sur un impératif fondamental : transformer un ensemble foisonnant d’observations brutes en métriques intelligibles, capables d’éclairer les mécanismes sous-jacents de la cognition, de la personnalité et de la psychopathologie. Face à la variabilité inhérente aux conduites humaines, les chercheurs se trouvent systématiquement confrontés à la nécessité de résumer des distributions empiriques complexes par des indices synthétiques. Au cœur de cette démarche de réduction des données se dressent les mesures de tendance centrale, outils d’apparence élémentaire dont la maîtrise conditionne pourtant la validité de l’ensemble de la chaîne inférentielle. Le choix entre ces différents estimateurs ne saurait être réduit à une simple préférence calculatoire ; il engage la fidélité de la représentation psychologique et la robustesse des conclusions tirées des protocoles de laboratoire comme des bilans cliniques.
Parmi ces métriques, la confrontation entre la moyenne arithmétique et la médiane cristallise des débats méthodologiques récurrents en psychologie cognitive, en neuropsychologie et en psychométrie différentielle. Alors que la première mobilise l’intégralité de l’information quantitative véhiculée par chaque mesure pour déterminer le barycentre mathématique de l’échantillon, la seconde privilégie une logique topologique d’ordonnancement, isolant la valeur qui scinde la cohorte observée en deux effectifs rigoureusement égaux. Cette divergence conceptuelle n’a rien d’anodin : selon la configuration géométrique de la distribution, le respect des postulats d’échelle et la survenue inévitable de scores aberrants, la moyenne et la médiane peuvent dresser des portraits diamétralement opposés d’une même réalité comportementale.
Naviguer avec clairvoyance entre ces deux pôles requiert une compréhension aiguë de leurs fondements mathématiques, de leurs propriétés de résistance face aux contaminations d’échantillonnage, ainsi que des caractéristiques propres aux construits psychologiques étudiés. Le présent article propose une analyse approfondie et systématique des conditions méthodologiques régissant l’emploi respectif de la moyenne et de la médiane en psychologie et en neurosciences. À travers une exploration des fondements théoriques, des études de cas concrètes et des recommandations de modélisation avancée, nous fournirons au chercheur comme au praticien les clés d’arbitrage indispensables pour sélectionner l’indicateur le plus fidèle à la dynamique de ses données empiriques.
1. Introduction aux mesures de tendance centrale en sciences du comportement
1.1 Définition et rôle fondamental de la tendance centrale
Dans l’arsenal de la statistique descriptive appliquée aux sciences humaines et sociales, la mesure de tendance centrale remplit une fonction fondamentale d’épure et de condensation mathématique. Lorsqu’un protocole expérimental recueille des centaines de latences motrices, ou qu’une batterie psychométrique évalue l’efficience cognitive d’une cohorte clinique, l’analyste fait face à un volume considérable d’observations caractérisées par un bruit stochastique substantiel. L’objectif premier de la tendance centrale consiste à identifier une valeur unique, hautement informative, capable de résumer la distribution globale en opérant comme le représentant le plus plausible ou le centre de gravité des données recueillies. Cette condensation dimensionnelle est indispensable pour communiquer des résultats de manière concise, comparer des groupes expérimentaux et calibrer des étalonnages normatifs.
Cependant, cette opération de réduction ne va pas sans péril épistémologique. Condenser une série de scores en un indice ponctuel implique inévitablement une perte d’information quant à la variabilité individuelle et à la microstructure des réponses. Si l’indicateur sélectionné s’avère inadapté à la topologie de la distribution sous-jacente, il risque d’introduire un biais d’interprétation délétère en projetant sur l’échantillon une régularité illusoire ou, à l’inverse, en masquant la concentration effective des individus autour d’un pôle particulier. En recherche fondamentale comme en pratique diagnostique, la fidélité de cette synthèse numérique conditionne la légitimité des constats empiriques : une tendance centrale mal calibrée fausse le calibrage des seuils pathologiques et fausse les jugements portés sur l’évolution longitudinale d’un tableau clinique.
Au-delà de sa fonction descriptive immédiate, la mesure de tendance centrale constitue la pierre angulaire de l’inférence statistique et de l’architecture des modèles prédictifs. En psychologie cognitive et en modélisation computationnelle du comportement, les paramètres d’ajustement, les fonctions de coût et les équations structurelles s’articulent intimement autour de l’estimation précise de ces points focaux. Qu’il s’agisse de déterminer l’espérance mathématique d’un processus de décision ou de positionner un individu sur un continuum latent au moyen d’un score factoriel, l’estimation correcte du centre de distribution demeure le préalable indispensable à toute entreprise de généralisation scientifique.
1.2 Différenciation conceptuelle entre moyenne et médiane
La distinction théorique fondamentale entre la moyenne arithmétique et la médiane réside dans leur traitement intrinsèque de l’espace métrique et de l’information quantitative. La moyenne arithmétique appréhende la série de données sous l’angle d’un équilibre physique : elle constitue le barycentre ou centre de gravité exact du système de points. Chaque observation individuelle y contribue proportionnellement à sa magnitude numérique brute. Par conséquent, une modification infinitésimale apportée à un unique score au sein d’une distribution affecte immédiatement, par réverbération arithmétique, la valeur finale de la moyenne. Cette caractéristique en fait un estimateur hypersensible à l’amplitude des mesures, intégrant la totalité des fluctuations présentes dans l’échantillon.
À l’opposé, la médiane s’ancre dans une logique purement positionnelle et ordonnée. Définie comme le point d’inflexion qui sépare la série de scores ordonnés en deux sous-ensembles de cardinalité rigoureusement identique, elle ne prend pas en considération l’amplitude des écarts numériques séparant les observations adjacentes, mais uniquement leur rang séquentiel. Dès lors que le statut relatif d’une valeur se trouve au-delà ou en deçà du centre, son éloignement kilométrique par rapport à ce centre n’exerce aucune influence sur la détermination de la médiane. Cette dissociation radicale entre rang et intensité confère à la médiane une insensibilité structurelle aux variations brutales des queues de distribution, offrant un reflet fidèle du profil affiché par l’individu médian de la population.
Cette divergence conceptuelle entraîne des implications directes sur la modélisation des variables psychologiques. Selon que le construit étudié se prête à une conceptualisation cumulative — où chaque surcroît d’intensité possède une signification substantielle — ou à une approche hiérarchique où prévaut l’ordre relatif des sujets, la moyenne et la médiane ne délivrent pas le même message substantiel. Alors que la première privilégie la quantité totale d’énergie, de temps ou de ressources cognitives déployées au sein du groupe, la seconde renseigne sur l’état du sujet typique, évitant que la performance de la majorité ne soit artificiellement occultée par les particularités comportementales d’une minorité atypique.
1.3 Défis métrologiques propres aux données psychologiques
L’application rigoureuse des mesures de tendance centrale en sciences du comportement se heurte d’emblée à un défi méthodologique structurel : la nature indirecte de la mesure psychologique. Contrairement aux grandeurs physiques fondamentales comme la masse ou la longueur, les construits psychologiques latents — tels que l’anxiété trait, l’efficience de la mémoire de travail ou l’estime de soi — ne peuvent être appréhendés par une lecture instrumentale directe. Ils sont inférés à partir d’indicateurs manifestes, souvent obtenus via des échelles d’auto-évaluation, des épreuves chronométriques ou des batteries de performances, introduisant une zone d’incertitude quant aux propriétés métriques réelles de la variable enregistrée.
Dans ce contexte, la taxonomie formelle des niveaux de mesure formulée par le psychophysicien Stanley Smith Stevens impose une vigilance méthodologique permanente. La distinction entre échelles purement ordinales — où seul l’ordre des catégories de réponse est garanti — et échelles d’intervalles strictes — où l’égalité des écarts numériques reflète une égalité de distances psychologiques — demeure au centre des controverses d’évaluation. En clinique et en psychométrie, une majorité d’instruments de mesure fournit des données que la communauté scientifique qualifie prudemment de « quasi-intervallaires » : si le score total est traité arithmétiquement comme un continuum, rien ne garantit mathématiquement que la distance psychique séparant un score de 20 à 25 sur une échelle de dépression soit rigoureusement équivalente à celle séparant un score de 45 à 50.
À ces équivoques métrologiques s’ajoute l’extrême fréquence des profils distributionnels asymétriques au sein des populations neuropsychologiques et psychopathologiques. Les distributions gaussiennes idéales, requises pour l’usage non contraint de certains estimateurs classiques, constituent bien souvent une exception plutôt que la règle empirique. Qu’il s’agisse de la présence de sous-groupes cliniques réfractaires, de planchers de performance ou de phénomènes de compensation cognitive, la distribution des données psychologiques reflète une complexité biologique et environnementale qui défie les hypothèses d’homogénéité standard, exigeant un discernement statistique sans faille dès la phase descriptive du protocole.
2. Fondements mathématiques et propriétés de la moyenne arithmétique
2.1 Formulation algébrique et calcul formel
Sur le plan analytique, la moyenne arithmétique d’un échantillon fini de taille N, notée conventionnellement X̄ ou M, est définie comme le quotient de la somme de toutes les observations individuelles xi par l’effectif total de cet échantillon. Dans le formalisme algébrique standard, cette relation s’exprime par l’équation canonique suivante :
X̄ = (1 / N) ∑i=1N xi
Dans le cas où les données sont regroupées en classes de fréquences ou issues de tableaux de contingence avec des effectifs pondérés, la formulation s’ajuste pour tenir compte du poids relatif wi ou de la fréquence observée fi associée à chaque valeur distincte, aboutissant à la moyenne pondérée : X̄w = (∑ wi xi) / (∑ wi). Cette formalisation capture la nature linéaire de l’opérateur d’agrégation, assurant que l’ensemble des valeurs observées participe à la construction finale de la métrique, sans omission ni hiérarchisation a priori.
Considérons à titre d’illustration empirique un protocole d’évaluation de l’empan mnésique complexe administré à un groupe de 7 participants adultes sains. Les scores bruts obtenus, reflétant le nombre maximal d’unités d’information restituées dans un ordre parfait, sont les suivants : {5, 6, 7, 7, 8, 8, 11}. Le calcul pas à pas requiert d’abord l’évaluation de la somme vectorielle de la série :
∑ xi = 5 + 6 + 7 + 7 + 8 + 8 + 11 = 52
L’application de la formule donne X̄ = 52 / 7 ≈ 7,43 unités. Cet exemple met en évidence une caractéristique immédiate du calcul de la moyenne : le résultat arithmétique (7,43) est une valeur continue appartenant à l’espace des réels ℝ, bien que la variable initiale soit strictement discrète et exprimée en entiers naturels ℕ. La moyenne s’abstrait de la matérialité discrète des observations individuelles pour exprimer une valeur d’espérance asymptotique abstraite.
2.2 Propriétés algébriques optimales de la moyenne
La primauté historique et méthodologique de la moyenne arithmétique au sein de la modélisation statistique repose sur un ensemble de propriétés algébriques élégantes. La plus remarquable d’entre elles concerne le critère de minimisation géométrique : la moyenne constitue le point central unique qui minimise la somme des carrés des écarts de chaque observation par rapport à cette valeur. Formellement, la fonctionnelle d’erreur quadratique définie par f(c) = ∑ (xi – c)2 atteint son minimum absolu précisément lorsque la constante c est égale à X̄. Cette propriété mathématique singulière rattache directement la moyenne arithmétique au principe fondamental des moindres carrés, qui sous-tend la quasi-totalité de l’économétrie, de la régression linéaire et des modèles linéaires généraux (GLM).
Une seconde propriété essentielle réside dans la linéarité absolue de l’opérateur moyenne face aux transformations affines des données brutes. Si l’on applique à chaque mesure xi une transformation linéaire de la forme yi = a · xi + b (où a et b sont des constantes réelles), la nouvelle moyenne arithmétique Ȳ est strictement égale à a · X̄ + b. Cette caractéristique confère une remarquable stabilité analytique aux métriques centrées, simplifiant considérablement les procédures de changement d’unités de mesure (par exemple, la conversion de millisecondes en secondes) ou la standardisation des épreuves psychométriques sous forme de scores zed, de notes T ou de quotients intellectuels calibrés.
Enfin, dans le contexte paradigmatique de l’échantillonnage issu de distributions normales, la moyenne arithmétique bénéficie d’une efficacité statistique maximale au sens de l’estimation paramétrique. En vertu du théorème de Cramér-Rao, elle constitue l’estimateur sans biais de variance minimale (MVUE) pour l’espérance mathématique de la population parente. Cela signifie qu’à taille d’échantillon équivalente, la moyenne d’échantillon présente une dispersion d’échantillonnage (erreur type) plus faible que n’importe quel autre estimateur de position non biaisé, conférant aux tests d’hypothèses subséquents une puissance statistique optimale sous réserve de normalité.
2.3 Vulnérabilité structurelle aux valeurs extrêmes
En contrepartie directe de ses vertus d’intégration universelle, la moyenne arithmétique souffre d’une fragilité structurelle majeure : son extrême sensibilité à l’apparition de scores atypiques ou aberrants au sein de l’échantillon. Dans la mesure où chaque observation xi pèse de tout son poids arithmétique dans l’équation d’agrégation, une unique mesure présentant un écart gigantesque par rapport au corps central des données suffit à modifier radicalement la valeur de l’indicateur. Si une seule valeur tend vers l’infini, la moyenne arithmétique de l’échantillon tend simultanément et inéluctablement vers l’infini, quelle que soit la taille finie N de l’échantillon considéré.
Dans le vocabulaire de la statistique robuste initiée par Peter J. Huber, cette vulnérabilité se traduit par un point de rupture (breakdown point) rigoureusement égal à zéro pour cent :
ε* = 0 % (pour N → ∞)
Le point de rupture quantifie la proportion minimale d’observations arbitrairement contaminées ou erronées qu’un échantillon peut accueillir avant que l’estimateur ne produise une estimation elle-même entièrement arbitraire et dénuée de sens substantiel. Un point de rupture nul indique qu’aucune tolérance n’est accordée à l’estimateur face aux artefacts d’enregistrement ou aux anomalies expérimentales.
Cette fragilité engendre des risques substantiels de distorsion dans la recherche clinique et comportementale. Lorsqu’un sous-échantillon de participants présente des profils singuliers en raison d’une défaillance instrumentale, d’un défaut de compréhension des consignes ou d’une comorbidité psychopathologique non détectée, la moyenne arithmétique est violemment attirée vers cette queue de distribution contaminée. Elle cesse alors d’opérer comme un indicateur représentatif de l’échantillon pour devenir le reflet déformé d’un artefact marginal, conduisant l’investigateur à formuler des inférences erronées sur les compétences moyennes de la cohorte évaluée.
3. Fondements mathématiques et propriétés de la médiane
3.1 Algorithme d’ordonnancement et identification du rang médian
Sur le plan mathématique, la médiane, désignée couramment par le symbole M̃ ou Med, s’affranchit du concept d’addition arithmétique pour se fonder sur une opération purement séquentielle de tri et de statistique d’ordre. Définie pour une variable quantitative ou ordinale continue, elle correspond au cinquantième percentile (P50) ou au second quartile (Q2) de la distribution empirique. Sa détermination algorithmique exige au préalable la réorganisation de la série d’observations non ordonnées {x1, x2, …, xN} sous la forme d’une série ordonnée ascendante notée {x(1), x(2), …, x(N)}, où x(1) ≤ x(2) ≤ … ≤ x(N) représentent les statistiques d’ordre de l’échantillon.
Le protocole de calcul formel se ramifie ensuite selon la parité de l’effectif N :
- Si la taille de l’échantillon N est impaire, la médiane correspond précisément à la valeur centrale occupant le rang d’ordre k = (N + 1) / 2, soit : M̃ = x((N+1)/2).
- Si la taille de l’échantillon N est paire, la distribution ne comporte pas une valeur centrale unique, mais deux valeurs médianes adjacentes situées aux rangs N / 2 et (N / 2) + 1. Par convention arithmétique standard, la médiane est alors estimée par la moyenne de ces deux valeurs pivots : M̃ = (x(N/2) + x((N/2)+1)) / 2.
Appliquons cette procédure pas à pas à une étude portant sur l’inattention motrice chez l’enfant d’âge scolaire, mesurée par le nombre d’erreurs d’omission lors d’une épreuve de performance continue (CPT) informatisée. Soit un échantillon de 8 enfants présentant la série de scores bruts désordonnés suivante : {14, 2, 8, 22, 5, 3, 9, 6}. La première phase consiste à opérer le tri strict des statistiques d’ordre :
Série ordonnée : {2, 3, 5, 6, 8, 9, 14, 22}
L’effectif N = 8 étant pair, nous ciblons les positions centrales d’ordre 8 / 2 = 4 et (8 / 2) + 1 = 5. Les observations correspondantes sont x(4) = 6 et x(5) = 8. Le calcul de la médiane donne :
M̃ = (6 + 8) / 2 = 7,00 erreurs
La médiane scinde ainsi impeccablement le groupe d’enfants : exactement 50 % des participants ont commis un nombre d’erreurs inférieur ou égal à 7, et 50 % ont produit un nombre d’erreurs supérieur ou égal à 7. Si le score extrême de 22 était devenu 85 sous l’effet d’une crise d’agitation, la médiane serait restée rigoureusement inchangée à 7,00, attestant de sa stabilité opérationnelle.
3.2 Robustesse statistique et point de rupture
L’avantage cardinal de la médiane dans l’exploration de données réside dans son immunité remarquable face aux contaminations quantitatives, une propriété formalisée sous le concept de robustesse non paramétrique. Contrairement à la moyenne arithmétique, la médiane possède un point de rupture asymptotique optimal de cinquante pour cent :
ε* = 50 %
Cette valeur constitue le maximum théorique absolu concevable pour tout estimateur de tendance centrale : il faudrait que plus de la moitié de l’échantillon soit délibérément corrompue ou remplacée par des valeurs infiniment déviantes pour parvenir à déplacer arbitrairement la médiane vers l’infini. Tant que la majorité des observations (50 % + 1) conserve sa cohérence ordinale, la médiane demeure ancrée au cœur topologique de la population étudiée.
Sur le plan géométrique et variationnel, la médiane répond à un critère d’optimisation distinct mais tout aussi noble que celui de la moyenne. Alors que cette dernière minimise la somme des carrés des écarts (norme L2), la médiane est la valeur unique c qui minimise la somme des écarts absolus (norme L1), formalisée par l’équation de perte :
g(c) = ∑i=1N |xi – c|
Cette propriété géométrique confère à la médiane une insensibilité structurelle aux variations d’échelle en périphérie : déplacer un point situé au-dessus de la médiane encore plus loin vers la droite n’accroît pas son gradient de dérivée absolue, laissant le point de minimisation intact. En neuropsychologie expérimentale et en recherche biométrique, cette caractéristique neutralise automatiquement les artefacts provoqués par des microsaccades parasites lors des enregistrements oculométriques ou les bruits d’électrodes en électroencéphalographie.
3.3 Limites algébriques de la médiane
En dépit de sa robustesse, la médiane se heurte à des contraintes mathématiques intrinsèques qui limitent son déploiement universel dans les architectures d’analyse complexes. La faiblesse la plus manifeste concerne sa non-additivité algébrique. Si l’on considère deux variables aléatoires indépendantes ou corrélées X et Y mesurées sur un même groupe d’individus, la médiane de la variable combinée (X + Y) n’est, en règle générale, pas égale à la somme des médianes individuelles :
Med(X + Y) ≠ Med(X) + Med(Y)
Cette discontinuité s’oppose à la propriété de linéarité absolue de la moyenne arithmétique, où l’espérance de la somme est toujours égale à la somme des espérances, rendant le calcul de bilans agrégés ou de composites de scores psychométriques notablement plus laborieux lorsqu’on manipule exclusivement des médianes.
Par ailleurs, la médiane présente une efficacité relative plus faible que la moyenne au sein d’une distribution normale pure. Dans un échantillon gaussien de grande taille, l’erreur type de la médiane est approximativement 1,253 fois plus élevée que celle de la moyenne arithmétique, ce qui correspond à une efficacité asymptotique de seulement 64 % (soit 2 / π). Autrement dit, estimer la tendance centrale d’une population gaussienne par la médiane sur un échantillon de 100 sujets procure le même niveau de précision statistique que l’utilisation de la moyenne sur seulement 64 sujets, induisant un gaspillage substantiel de puissance statistique lorsque les postulats de normalité sont effectivement réunis.
Enfin, la médiane souffre d’une complexité algorithmique accrue lors de son insertion dans des équations matricielles multivariées. Sa fonction de dérivée n’étant pas différentiable au sens classique au point d’origine (présence d’une singularité due à la valeur absolue), elle ne se prête pas avec la même élégance que la moyenne aux calculs de décomposition de variance orthogonale requises par l’analyse factorielle exploratoire ou la régression multivariée, exigeant des procédures d’optimisation numérique itératives plus lourdes.
4. Influence de la forme de la distribution : Symétrie et Asymétrie
4.1 Comportement des indices dans une distribution normale
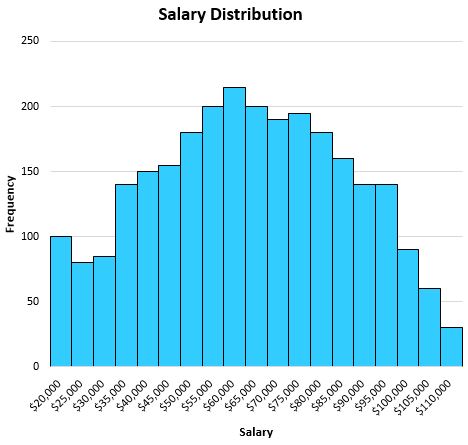
La morphologie géométrique de la distribution de données constitue le déterminant le plus puissant de la divergence ou de la convergence entre la moyenne et la médiane. Dans le cadre théorique idéal d’une distribution parfaitement symétrique et unimodale — dont la courbe de Gauss représente l’archétype mathématique le plus célèbre —, il se produit un phénomène remarquable d’alignement unitaire : la moyenne arithmétique, la médiane et le mode se superposent rigoureusement au même point d’abscisse central :
Moyenne = Médiane = Mode
Sous cette géométrie d’une régularité absolue, le barycentre physique des données coïncide fidèlement avec le point de division des rangs et avec le pic maximal de densité d’observations, rendant les deux indicateurs mathématiquement équivalents quant à leur positionnement spatial.
Dans ces conditions d’homoscédasticité et de parfaite symétrie mésokurtique, le choix entre la moyenne et la médiane ne soulève aucun différend d’interprétation substantielle sur la localisation de l’individu typique. La moyenne arithmétique est alors universellement plébiscitée par les psychométriciens en raison de son erreur type minimale et de son intégration immédiate dans les processus de standardisation. C’est précisément sur ce postulat de normalité sous-jacente que reposent les échelles composites d’intelligence globale, telles que les échelles de Wechsler (WAIS, WISC), où les scores bruts sont recalibrés par transformation linéaire pour produire une distribution normale théorique de moyenne 100 et d’écart type 15.
Toutefois, la convergence empirique absolue demeure rare dans les échantillons cliniques réels de taille restreinte. Même lorsque la population parente suit approximativement une loi normale, les fluctuations d’échantillonnage introduisent de légères variations stochastiques qui séparent la moyenne de la médiane de quelques dixièmes d’unités. Dès lors que cette oscillation demeure dans les limites prévues par les erreurs types respectives, l’interchangeabilité des deux indices reste méthodologiquement défendable, bien que la moyenne conserve un avantage fonctionnel pour l’inférence paramétrique ultérieure.
4.2 Distributions asymétriques positives en psychologie cognitive
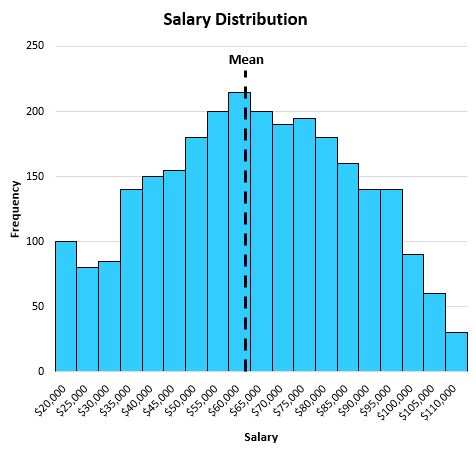
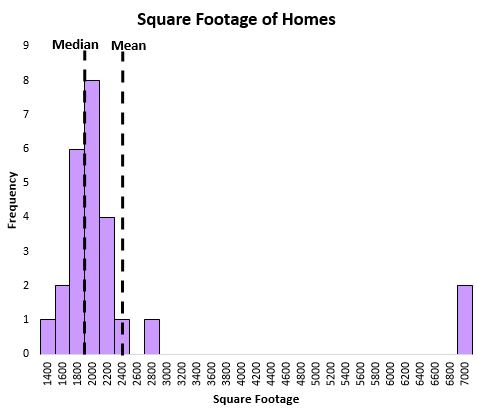
Les distributions asymétriques positives, couramment désignées sous le terme d’asymétrie droite (skewness positif), constituent le profil empirique dominant dans un large pan des sciences cognitives et des neurosciences comportementales. Dans une telle distribution, le corps principal des données se concentre massivement sur des valeurs faibles ou modérées, tandis qu’une queue de distribution étirée s’allonge vers des scores substantiellement plus élevés. Cette conformation génère un découplage mécanique et prévisible de la hiérarchie des tendances centrales, respectant la relation d’ordre canonique :
Mode < Médiane < Moyenne
Sous l’effet gravitationnel de la queue droite, la moyenne arithmétique est puissamment déportée vers le haut par les rares observations ultra-élevées, tandis que la médiane résiste fermement à cette traction périphérique.
Ce phénomène d’asymétrie droite s’observe de manière quasi universelle sur les mesures chronométriques, telles que les temps de réaction (TR) et les latences de décision lexicale. Les distributions de TR ne sont pas gaussiennes, mais s’ajustent typiquement à des modèles de type ex-gaussien, log-normal ou de Wald. Ces profils s’expliquent physiologiquement : un participant possède une limite plancher biologique infranchissable pour le traitement visuomoteur (environ 150 à 200 ms), mais aucune limite plafond stricte pour des réponses tardives induites par une baisse passagère d’attention ou une hésitation décisionnelle. Il en résulte une accumulation de latences brèves flanquée d’une longue traînée de temps prolongés.
Dans ce contexte chronométrique, recourir à la moyenne arithmétique pour qualifier la performance d’un individu ou d’un groupe expérimental constitue un contresens psychologique direct. La moyenne calculated intègre l’amplitude disproportionnée de quelques essais pollués par des lapses attentionnels, produisant une métrique qui ne correspond plus à l’expérience de la vaste majorité des essais moteurs. La médiane, en revanche, se maintient à l’épicentre du processus de réponse canonique, fournissant une photographie fidèle de la vitesse de traitement effective du sujet exemptée des interférences sporadiques.
4.3 Distributions asymétriques négatives et effets de plafond
À l’exact opposé de la dynamique précédente, les distributions asymétriques négatives (asymétrie gauche ou skewness négatif) se caractérisent par une concentration majeure des scores sur le versant élevé de l’échelle d’évaluation, tandis qu’une traînée éparse s’étire vers les valeurs résiduelles les plus faibles. Dans cette topologie inversée, les estimateurs de tendance centrale se réorganisent selon un ordre vectoriel rigoureusement antagoniste :
Moyenne < Médiane < Mode
Ici, c’est la présence de quelques performances exceptionnellement dégradées ou de profils très fragiles qui exerce un effet d’aspiration de la moyenne vers le bas, l’éloignant significativement de la concentration modale de la population.
En psychologie du développement, en gérontologie et en éducation, ce phénomène survient fréquemment en raison des redoutés « effets de plafond » (ceiling effects). Lorsqu’une épreuve psychométrique d’évaluation cognitive globale s’avère trop accessible pour une cohorte d’étudiants d’université ou pour des sujets sains sans atteinte neurologique, une proportion écrasante d’individus sature l’outil en enregistrant des scores parfaits ou quasi parfaits (par exemple, des scores de 29 ou 30 sur 30 au Mini-Mental State Examination). Seuls quelques rares participants manifestant des défaillances singulières ou des erreurs d’inattention dispersées viennent alimenter la queue gauche de la distribution.
Si le clinicien ou l’expérimentateur utilise la moyenne arithmétique pour qualifier le niveau d’accomplissement de cette population, cette mesure se révélera artificiellement déprimée par les scores marginaux, donnant l’impression trompeuse d’une performance de groupe modérée. La médiane, quant à elle, s’établit résolument sur le plateau de réussite de la cohorte, constatant avec lucidité que plus de 50 % des individus ont atteint l’excellence instrumentale. Elle évite ainsi que la compétence partagée de la majorité ne soit minimisée par une minorité atypique, préservant la validité écologique du diagnostic collectif.
5. Le problème des valeurs aberrantes et contamination des données
5.1 Origine des données extrêmes en protocole expérimental
L’émergence d’observations aberrantes ou aberrantes marginales (souvent désignées par l’anglicisme outliers) constitue une fatalité empirique inhérente à l’expérimentation sur l’être humain. L’analyse des protocoles de laboratoire montre que ces anomalies de mesure ne proviennent pas d’une source unique, mais d’une constellation hétérogène de mécanismes d’interférence psychologique, instrumentale ou nosologique. La première étiologie, hautement répandue lors de tâches d’évaluation cognitive informatisées de longue durée, relève de la fluctuation endogène des états de vigilance. Un accès brutal de fatigue, un éternuement intempestif ou une distraction cognitive momentanée du sujet peut dilater un temps de réaction habituel de 400 ms pour l’amener à plus de 4000 ms, sans que cet essai ne reflète le processus cognitif ciblé par le paradigme.
Une seconde catégorie de contaminations procède directement de failles technologiques ou de bévues d’encodage humain au sein de la chaîne de recueil des données. Malgré l’automatisation croissante des logiciels d’expérimentation, la dérive d’une horloge logicielle sous l’effet d’une interruption du système d’exploitation, le décrochage passager d’une électrode de conductance cutanée lors d’un test polygraphique, ou la saisie manuelle d’un zéro supplémentaire lors du report des inventaires papier (par exemple, transcrire « 120 » au lieu de « 12 » pour un score borné à 20) génèrent des points d’une discordance radicale avec le reste de l’échantillon.
Enfin, une origine clinique majeure réside dans la présence de sous-populations masquées au sein des groupes réputés homogènes. Lors d’une étude portant sur la mémoire épisodique chez des adultes âgés présumés sains, il arrive qu’un ou deux participants soient en réalité dans la phase prodromique inaugurale d’une pathologie neurodégénérative non diagnostiquée. Leurs scores démesurément effondrés introduisent une contamination qualitativement distincte du simple bruit expérimental, altérant les caractéristiques descriptives globales du groupe contrôle.
5.2 Démonstration quantitative de la distorsion par les valeurs aberrantes
Afin de quantifier la discordance comportementale entre les estimateurs sous l’impact d’une contamination aberrante, examinons une expérience numérique contrôlée. Considérons une cohorte fictive de 10 patients évalués sur une échelle de gravité du trouble obsessionnel-compulsif (Y-BOCS), dont les scores bruts sont initialement homogènes et centrés autour d’une intensité clinique modérée :
Série initiale non contaminée (N = 10) : {18, 19, 20, 20, 21, 22, 22, 23, 24, 25}
Calculons les indicateurs initiaux :
- Somme initiale = 214
- Moyenne initiale : X̄1 = 214 / 10 = 21,40
- Médiane initiale : Les valeurs de rang 5 et 6 sont 21 et 22. D’où M̃1 = (21 + 22) / 2 = 21,50
À ce stade de conformité parfaite, moyenne et médiane délivrent un constat clinique rigoureusement unifié (21,40 contre 21,50).
Supposons à présent qu’une erreur matérielle de report survienne lors de l’archivage du dixième dossier : au lieu du score valide de 25, une interversion de touches enregistre le score absurde de 95, ce qui est matériellement impossible sur l’échelle mais indétecté lors de l’exécution d’un script automatisé. La série de données devient :
Série contaminée (N = 10) : {18, 19, 20, 20, 21, 22, 22, 23, 24, 95}
Réévaluons les indicateurs après l’injection de cette unique anomalie métrologique :
- Nouvelle somme = 18 + 19 + 20 + 20 + 21 + 22 + 22 + 23 + 24 + 95 = 284
- Nouvelle moyenne : X̄2 = 284 / 10 = 28,40 (Soit un bond colossal de +7,00 points, déplaçant l’indice de sévérité du groupe du registre « modéré » vers un niveau de pathologie « extrêmement sévère »).
- Nouvelle médiane : Les valeurs de rang 5 et 6 dans la série ordonnée demeurent impavides : x(5) = 21 et x(6) = 22. D’où M̃2 = (21 + 22) / 2 = 21,50.
La médiane affiche une variation rigoureusement égale à zéro pour cent : elle absorbe l’onde de choc de la contamination sans dévier d’une fraction d’unité. La moyenne arithmétique, en revanche, a subi une distorsion qui invalide totalement l’intégrité diagnostique de l’échantillon. Cet exemple numérique démontre pourquoi fonder des seuils de remboursement thérapeutique ou des critères d’inclusion hospitalière sur la seule moyenne expose les institutions à des décisions biaisées par des artefacts marginaux.
5.3 Stratégies alternatives de gestion des extrêmes
Face à la vulnérabilité de la moyenne et à la perte d’information métrique potentiellement associée à la médiane pure, les statisticiens méthodologues ont développé des estimateurs de compromis sophistiqués appartenant à la famille des statistiques robustes. Parmi ces alternatives, les moyennes tronquées (trimmed means) et les moyennes winsorisées (winsorized means) occupent une place de choix. La moyenne tronquée à 20 %, par exemple, consiste à supprimer les 20 % de valeurs les plus faibles et les 20 % les plus élevées de la série ordonnée, pour calculer la moyenne arithmétique sur les 60 % de scores médians restants. Cette méthode préserve la dynamique continue des calculs tout en dotant l’estimateur d’un point de rupture substantiel.
Une seconde approche largement standardisée en psychologie expérimentale repose sur l’application de transformations non linéaires destinées à normaliser la géométrie distributionnelle avant tout calcul arithmétique. L’application d’une transformation logarithmique (log10 ou ln) ou d’une transformation racine carrée sur des temps de réaction comprime drastiquement la queue droite de la distribution. En réduisant l’espacement relatif des valeurs extrêmes, la transformation restaure une symétrie approximative permettant de calculer une moyenne arithmétique transformée, dont la rétro-transformation ultérieure génère une moyenne géométrique hautement stable.
Cependant, aucune manipulation mathématique ne saurait exonérer l’analyste d’un examen empirique rigoureux de la nature substantielle de l’extrême. Avant d’éliminer ou de neutraliser une observation déviante, le chercheur doit mener une enquête diagnostique : s’agit-il d’un artefact technique indiscutable (auquel cas son exclusion physique ou sa réimputation est obligatoire), ou d’un authentique cas clinique rare reflétant l’hétérogénéité biologique du phénomène ? Dans cette seconde hypothèse, la conservation de la valeur intégrale sous une analyse descriptive par la médiane s’avère la posture méthodologique la plus intègre.
6. Conditions méthodologiques requises pour l’emploi de la moyenne
6.1 Respect du niveau de mesure d’intervalle ou de rapport
L’utilisation légitime de la moyenne arithmétique impose au premier chef le respect strict du niveau métrologique de la variable examinée, conformément à la théorie axiomatique de la mesure. Pour qu’une sommation arithmétique possède un sens empirique substantiel, la variable sous-jacente doit impérativement être mesurée au minimum sur une échelle d’intervalles constants, voire sur une échelle de rapports dotée d’un zéro absolu. Ce postulat implique que l’intervalle numérique séparant deux unités consécutives demeure rigoureusement équivalent tout au long du continuum métrique : la différence physique ou quantitative entre 10 et 11 doit être indiscernable de celle séparant 89 et 90.
Cette conditionnalité métrologique est indiscutablement satisfaite lors de l’enregistrement de biomarqueurs physiologiques et de variables physiques continues dans les laboratoires de neurosciences comportementales. Des grandeurs fondamentales telles que :
- La conductance cutanée électrodermale exprimée en micro-Siemens,
- La variabilité de la fréquence cardiaque (VRC) quantifiée par l’intervalle inter-battement en millisecondes,
- La puissance spectrale des bandes de fréquence électroencéphalographiques mesurée en microvolts carrés par hertz,
constituent d’authentiques variables d’intervalles ou de rapports. Chaque unité d’incrément y reflète un gradient physique constant, autorisant la sommation intégrale et l’extraction de la moyenne arithmétique sans distorsion sémantique.
À l’inverse, appliquer la formule de la moyenne arithmétique à des données purement qualitatives nominales (comme le statut marital ou le sous-type nosologique d’une pathologie codé de 1 à 4) constitue une hérésie méthodologique absolue. De surcroît, calculer une moyenne sur des rangs ordinaires (par exemple, le classement d’arrivée lors d’un test de sélection) produit un indice numériquement calculable mais structurellement vide de sens, dans la mesure où rien n’atteste que la distance séparant le premier du deuxième candidat corresponde à celle isolant le deuxième du troisième. La métrique doit posséder une propriété d’équidistance interne pour que le barycentre conserve sa pertinence interprétative.
6.2 Validation préalable des postulats de normalité
Même lorsque la nature quantitative continue de la variable est fermement établie, le recours sans discernement à la moyenne arithmétique requiert impérativement un examen diagnostique de la normalité de la distribution empirique. Cette vérification ne saurait reposer sur une simple impression visuelle subjective ; elle réclame le déploiement d’une procédure formelle d’adéquation statistique. Les tests d’hypothèses dédiés, au premier rang desquels figurent le test de Shapiro-Wilk (hautement puissant pour les petits et moyens échantillons, N < 50) et le test de Kolmogorov-Smirnov corrigé par Lilliefors, évaluent explicitement si la déviation des données par rapport à une fonction gaussienne théorique est attribuable au seul hasard de l’échantillonnage.
Cette approche inférentielle doit s’accompagner d’un examen qualitatif des représentations graphiques de conformité, notamment l’inspection méthodique des diagrammes quantile-quantile (Q-Q plots) et des histogrammes de densité superposés à la courbe normale théorique. Sur un tracé Q-Q, l’alignement rectiligne des quantiles empiriques sur la bissectrice atteste de la symétrie mésokurtique des observations. Si les points dévient substantiellement en formant une courbe en sigmoïde ou une parabole prononcée, la normalité est formellement violée, signalant une asymétrie ou un aplatissement incompatibles avec la primauté descriptive de la moyenne.
Il convient néanmoins de modérer cette exigence par les enseignements du théorème central limite (TCL). Ce théorème fondamental de la théorie des probabilités stipule que lorsque la taille d’un échantillon indépendant et identiquement distribué croît pour atteindre des effectifs massifs (conventionnellement N > 100, voire plusieurs centaines de cas), la distribution d’échantillonnage de la moyenne converge inexorablement vers une loi normale, quand bien même la population parente initiale serait asymétrique. Ainsi, l’analyste peut continuer à utiliser la moyenne arithmétique pour des comparaisons inférentielles de cohortes volumineuses, même si la médiane demeure descriptivement plus représentative de la réalité univariée des sujets individuels.
6.3 Finalité de modélisation inférentielle paramétrique
L’argument décisif dictant l’emploi préférentiel de la moyenne arithmétique relève fréquemment des contraintes imposées par la chaîne de modélisation statistique en aval. Dans la recherche translationnelle et clinique moderne, l’analyse descriptive ne constitue qu’un prélude à l’estimation de modèles mathématiques sophistiqués destinés à éprouver des hypothèses théoriques complexes : analyses de variance univariées et multivariées (ANOVA/MANOVA), régressions linéaires multiples, modèles d’équations structurelles (SEM) et modèles hiérarchiques linéaires mixtes (HLM). L’ensemble de cette architecture paramétrique classique est mathématiquement adossé aux statistiques du second ordre : la moyenne et la matrice de variance-covariance.
Renoncer à la moyenne arithmétique dans ces contextes équivaudrait à se priver des propriétés algébriques de la modélisation paramétrique, dont la puissance statistique surpasse systématiquement celle des alternatives ordinales lorsque les postulats théoriques sont raisonnablement satisfaits. La moyenne offre une commodité d’agrégation et de décomposition sans égale : elle permet d’estimer sans biais les paramètres d’effet au sein de la population cible, d’isoler des termes d’interaction multivariés et de quantifier précisément les pourcentages de variance expliquée (η2, R2) par une intervention expérimentale ou un traitement pharmacologique.
De plus, la moyenne arithmétique simplifie grandement l’interprétation clinique lorsqu’il s’agit de formuler des bilans d’efficacité comparée. Exprimer qu’un nouveau protocole de remédiation cognitive permet un gain moyen de 8,5 points sur une échelle d’attention globale fournit aux praticiens et aux décideurs de santé publique un repère métrique direct, intuitif et aisément comparable d’une étude translationnelle à l’autre, sous réserve que l’homogénéité du groupe ait été scrupuleusement validée en amont.
7. Conditions méthodologiques requises pour l’emploi de la médiane
7.1 Exploitation de données purement ordinales
L’impératif méthodologique premier dictant le recours irrévocable à la médiane réside dans la nature strictement ordinale des variables recueillies. En sciences humaines, en sociologie quantitative et en psychologie clinique, une fraction écrasante des données est colligée par l’intermédiaire d’échelles subjectives de type Likert (par exemple, des graduations en 5 ou 7 points allant de « Totalement en désaccord » à « Totalement d’accord »), ou d’échelles de sévérité graduées de type « Absent, Léger, Modéré, Sévère ». Si ces protocoles permettent sans ambiguïté d’ordonner hiérarchiquement les réponses, ils ne confèrent aucunement le statut d’échelle d’intervalles aux chiffres utilisés pour le codage informatique.
Dans une échelle ordinale, il est conceptuellement impossible de garantir que l’intervalle psychologique séparant la modalité 1 (« Jamais ») de la modalité 2 (« Rarement ») équivaille rigoureusement au saut qualitatif isolant la modalité 4 (« Souvent ») de la modalité 5 (« Systématiquement »). Les distances perceptives entre les échelons sont hétérogènes et idiosyncrasiques. Dans ces conditions, effectuer la sommation arithmétique de ces cotes pour calculer une moyenne (aboutissant à des affirmations formellement discutables du type : « Le niveau d’accord moyen est de 3,67 ») constitue une transgression de la métrologie fondamentale.
La médiane s’impose ici comme le seul indice de positionnement rigoureux et intègre : elle opère exclusivement sur les propriétés relationnelles de rang et de comparaison (supérieur, égal, inférieur) sans jamais violer l’architecture ordinale des catégories. Rapporter qu’un groupe de répondants affiche une médiane de 4 (« D’accord ») préserve l’intégrité de l’énoncé sémantique initial, sans projeter arbitrairement une fausse métrique continue continue sur des jugements qualitatifs subjectifs.
7.2 Présence avérée d’une forte asymétrie distributionnelle
La médiane devient l’indicateur méthodologique impératif dès lors que la distribution d’une variable quantitative continue s’écarte substantiellement de la symétrie gaussienne, exhibant des indices d’asymétrie (skewness) dont la magnitude absolue excède les seuils tolérés par la littérature psychométrique (typiquement lorsque le ratio d’asymétrie dépasse |Skew / SEskew| > 2 ou |Skew| > 1). Ce phénomène n’est pas une simple anomalie passagère, mais une propriété structurelle immuable de nombreuses variables investiguées en psychologie sociale et en épidémiologie psychiatrique.
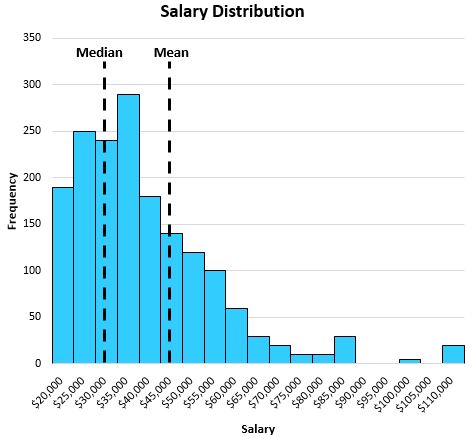
L’illustration la plus universelle concerne l’analyse des ressources socio-économiques des ménages ou les niveaux de revenus individuels, fréquemment manipulés comme variables de contrôle dans les études sur les déterminants sociaux de la santé mentale. Dans n’importe quelle nation contemporaine, la répartition des salaires est marquée par une asymétrie droite gigantesque : une écrasante majorité de citoyens perçoit des rémunérations modestes ou moyennes, tandis qu’une infime proportion d’individus concentre des revenus astronomiques s’étendant à des millions d’unités monétaires. L’utilisation de la moyenne arithmétique aboutit immanquablement à la publication d’un « revenu moyen » surévalué, tiré vers le haut par les fortunes exceptionnelles, ne reflétant en rien la réalité quotidienne vécue par 70 % à 80 % de la population.
Seul le recours au « revenu médian » — seuil salarial exact divisant la société en deux fractions égales — restitue fidèlement le niveau de vie de l’individu socialement représentatif. Le même impératif méthodologique prévaut lors de l’étude de la durée de séjour des patients en milieu hospitalier psychiatrique : si la majorité des épisodes aigus se résout en deux à trois semaines, quelques hospitalisations au long cours s’étendant sur des décennies font exploser la moyenne arithmétique. La médiane fournit ici le seul indicateur de gestion hospitalière évitant des conclusions managériales totalement déconnectées du flux ambulatoire standard.
7.3 Données censurées et temps de survie
Un domaine méthodologique capital où la moyenne arithmétique se révèle non seulement inadaptée, mais purement impossible à calculer sur le plan mathématique, est celui du traitement des données censurées dans le cadre de l’analyse de survie (survival analysis) et des modèles de risques proportionnels de Cox. En psychiatrie clinique et en addictologie expérimentale, les protocoles longitudinaux suivent des cohortes de patients pour évaluer le délai d’apparition d’un événement clinique déterminant, tel que :
- La rechute addictive après un sevrage alcoolique ou tabagique,
- La rémission complète d’un épisode dépressif majeur sous pharmacothérapie,
- Le délai avant récidive d’une décompensation psychotique.
Au terme de la fenêtre d’observation expérimentale prédéfinie (par exemple, un suivi clinique d’une durée calendaire fixe de 18 mois), il arrive systématiquement qu’une proportion substantielle de participants n’ait pas encore manifesté l’événement d’intérêt, tandis que d’autres sont prématurément perdus de vue. Leurs temps de survie réels sont dits « censurés à droite » : on sait que leur délai d’apparition est strictement supérieur à 18 mois, mais leur valeur définitive exacte demeure fondamentalement inconnue et inaccessible à l’expérimentateur.
Dans ce cadre d’incomplétude mathématique absolue, l’équation de la moyenne arithmétique est totalement inapplicable, faute de pouvoir attribuer une magnitude numérique aux données censurées. En revanche, l’estimation non paramétrique de Kaplan-Meier permet de calculer sans aucune difficulté la « durée de survie médiane » : il s’agit du délai temporel précis au terme duquel la fonction de survie estimée franchit le seuil critique de 50 %. La médiane s’impose ici comme le seul outil capable d’intégrer rigoureusement l’information issue des sujets censurés sans formuler d’hypothèses invérifiables sur leur devenir ultérieur.
8. Exemples concrets en psychologie cognitive et neurosciences
8.1 Analyse chronométrique des temps de réaction
L’exploration fine de l’architecture cognitive par la méthode chronométrique offre l’un des cas d’usage les plus démonstratifs de l’arbitrage entre moyenne et médiane. Considérons l’administration informatisée du classique paradigme de l’effet d’interférence de Stroop à un patient cérébrolésé suivi dans un service de rééducation neurocognitive. Le protocole comporte 60 essais congruents (le mot « VERT » imprimé à l’encre verte) et 60 essais incongruents (le mot « ROUGE » imprimé à l’encre bleue). Durant l’épreuve, le sujet valide 58 essais incongruents avec des latences s’échelonnant harmonieusement entre 550 ms et 820 ms. Toutefois, sur les deux derniers essais, le patient marque un temps d’arrêt consécutif à une toux réflexe, validant la touche réponse à 3800 ms et 4200 ms.
Si le neuropsychologue traite ces données en calculant la simple moyenne arithmétique des temps de réaction incongruents, ces deux seuls essais atypiques font basculer le score global d’une moyenne latente d’environ 680 ms à une moyenne calculée distordue de plus de 790 ms, gonflant artificiellement le score d’interférence calculé par rapport à la condition contrôle. En revanche, le calcul de la médiane neutralise intégralement l’impact de ces deux toux accidentelles, maintenant le score à 678 ms. En chronométrie fine, la communauté scientifique internationale prescrit ainsi prioritairement l’extraction de la médiane des TR individuels par condition, garantissant que l’indicateur capté reflète l’efficience computationnelle de l’inhibition exécutive et non les perturbations motrices adventices.
8.2 Mesures de fixation oculaire et comportement de regard
Les technologies de suivi du regard (eye-tracking) génèrent des flux continus de coordonnées spatiales et temporelles dont la distribution obéit à des dynamiques physiologiques hautement asymétriques. Lors d’une tâche de lecture sur écran ou d’exploration de scènes visuelles complexes, les fixations oculaires se scindent physiologiquement en deux régimes opératoires distincts : d’une part, une multitude de fixations courtes (120 à 220 ms) vouées à l’extraction rapide d’indices visuels fovéaux et parafovéaux, et d’autre part, des fixations d’encodage prolongées (excédant fréquemment 700 à 1000 ms) déclenchées par l’apparition de mots rares, d’ambiguïtés syntaxiques ou d’éléments sémantiques inattendus.
Fonder la modélisation de la cinétique visuelle sur la durée moyenne de fixation introduit un biais substantiel en lissant indûment ces deux régimes fonctionnels. La médiane des durées de fixation oculaire s’impose ici comme le paramètre princeps pour capturer le traitement lexical automatique de base du lecteur, car elle résiste à l’attraction exercée par les phases résolutives d’ambiguïtés syntaxiques. La caractérisation du comportement d’exploration fovéale gagne ainsi en finesse : la médiane informe sur la célérité normative de la micro-exploration oculaire, tandis que les fixations longues sont modélisées de manière disjointe par des indices d’écarts interquartiles ou de densités d’asymétrie, révélant la charge cognitive spécifique requise par la compréhension du matériel complexe.
8.3 Performances mnésiques et épreuves de rappel libre
Dans l’évaluation de la mémoire épisodique au moyen de paradigmes d’apprentissage associatif verbal (comme le test de rappel libre/rappel indicé à 16 items de Grober et Buschke), la confrontation entre moyenne et médiane éclaire différemment la dynamique mnésique des cohortes gériatriques. Au sein d’un groupe contrôle homogène d’adultes sains, le nombre total de mots restitués lors des trois essais consécutifs se distribue selon une symétrie relative, la réserve cognitive générale s’exprimant de manière diffuse : le recours à la moyenne arithmétique capture alors avec précision la performance d’apprentissage globale du groupe en bénéficiant de son efficacité statistique maximale.
En revanche, dès lors que l’échantillon intègre des patients amnésiques amnésiques sévères (syndrome de Korsakoff ou maladie d’Alzheimer évoluée), la distribution des scores de rappel s’effondre en touchant le plancher de l’épreuve (scores systématiquement compris entre 0 et 2 items sur 16). L’introduction de quelques individus conservant un score préservé de 12 items au sein d’une cohorte clinique produit une distribution bivariée ou violemment asymétrique. Dans cette situation, la moyenne arithmétique masque la sévérité du déficit pour la majorité des malades en laissant planer l’impression d’une rémanence mnésique partielle de groupe, alors que la médiane clinique affiche sans complaisance un score de 1 ou de 0 item, soulignant l’extinction quasi totale de la fonction de rappel explicite chez la majorité des patients inclus.
9. Exemples concrets en psychométrie et psychologie différentielle
9.1 Scores globaux aux inventaires de personnalité
L’évaluation des traits dispositionnels au moyen des modèles factoriels modernes de la personnalité — à l’instar du modèle des Big Five ou de l’inventaire HEXACO — soulève un débat récurrent sur le statut métrologique des scores composites. Les inventaires de personnalité somment classiquement un nombre important d’items ordinaux de type Likert (généralement 10 à 24 items par dimension) pour forger des scores dimensionnels globaux pour l’Extraversion, l’Agréabilité ou le Névrosisme. La théorie psychométrique classique postule que par l’effet d’agrégation sommatrice de multiples items ordonnés, le score brut total tend asymptotiquement vers une quasi-continuité métrique d’intervalles.
Sous cette convention, lorsque l’échantillon provient de la population générale saine, les scores globaux aux grandes dimensions de la personnalité manifestent une normalité univariée très satisfaisante. Les tests de symétrie valident la convergence étroite entre la moyenne arithmétique et la médiane des notes globales de trait. Le calcul de la moyenne est alors légitimement standardisé pour établir les tables d’étalonnage en scores T ou en stanines, permettant de situer l’individu par rapport à la moyenne normative de la population générale tout en appliquant les équations différentielles de la psychométrie classique.
9.2 Échelles d’anxiété et de dépression dans la population générale
Si la normalité des traits de personnalité générale autorise l’usage de la moyenne, la situation métrologique se transforme radicalement lorsqu’on administre des auto-questionnaires de détresse psychologique — tels que l’inventaire de dépression de Beck (BDI) ou l’échelle d’anxiété de Hamilton (HAM-A) — à un échantillon probabiliste issu de la population générale saine non consultante. Dans ce milieu écologique non clinique, l’immense majorité des citoyens ne présente aucun symptôme psychiatrique actif : ils cotent 0 ou 1 à la quasi-totalité des items. La distribution résultante se trouve violemment comprimée contre le plancher absolu de l’instrument, créant une asymétrie droite aiguë.
Dans un tel contexte épidémiologique :
- La médiane de l’échantillon s’établit fidèlement à une cote de 1 ou 2 points, attestant du silence symptomatique qui caractérise la norme de santé mentale collective.
- La moyenne arithmétique, captant les scores élevés de quelques individus traversant des épisodes dépressifs majeurs transitoires ou des crises de panique, est artificiellement tirée vers une valeur bâtarde oscillant entre 6 et 8 points.
L’utilisation de cette moyenne comme étalonnage normatif de référence induit un risque éthique et clinique majeur de fausse pathologisation : un individu affichant un score brut de 5 points se verrait jugé en deçà de la pseudo-« moyenne » de la population, alors même qu’il présente déjà un niveau de détresse psychologique objectivement supérieur à celui exprimé par plus de 75 % de ses concitoyens. Seule la médiane associée à l’intervalle interquartile permet d’éviter cette illusion métrique délétère.
9.3 Standardisation et étalonnage des échelles d’intelligence
Le domaine de la psychométrie différentielle des aptitudes cognitives illustre une articulation théorique harmonieuse et sophistiquée entre moyenne et médiane lors de la construction des tables d’étalonnage des échelles d’intelligence pour enfants et adultes (échelles d’intelligence de David Wechsler). Les scores bruts obtenus aux différents sous-tests (mémoire des chiffres, cubes, matrices, vocabulaire) ne suivent pas spontanément une distribution normale parfaite. Afin de garantir une comparabilité internationale et inter-âges, les concepteurs opèrent un processus rigoureux de standardisation non linéaire.
Dans cette architecture, la médiane des scores bruts est identifiée pour chaque strate chronologique de normalisation, constituant le point d’ancrage central correspondant formellement au percentile 50. Les scores bruts sont ensuite convertis en notes standardisées selon une transformation qui contraint la distribution résultante à épouser une courbe normale théorique de moyenne 100 et d’écart type 15 pour le Quotient Intellectuel (QI) global. La moyenne arithmétique devient alors le barycentre mathématique opératoire de l’échelle d’évaluation, tandis que la médiane conserve un rôle critique de contrôle métrologique dans l’interprétation des rangs percentiles pour l’identification des profils cognitifs atypiques, tels que le haut potentiel intellectuel (QI ≥ 130, percentile 97,7) ou la déficience intellectuelle (QI ≤ 70, percentile 2,3).
10. Implications pour l’inférence statistique et les tests d’hypothèses
10.1 Correspondance entre moyenne et tests paramétriques
L’investigation scientifique ne se limite pas à cartographier des échantillons finis ; elle s’attache à trancher formellement des hypothèses théoriques par la médiation de tests inférentiels. Dans cet édifice probabiliste, la décision de retenir la moyenne arithmétique oriente mécaniquement l’analyste vers le paradigme des tests paramétriques classiques. Le célèbre test t de Student (pour échantillons indépendants ou appariés) ainsi que les diverses modalités de l’analyse de variance univariée (ANOVA) sont, par définition mathématique, des épreuves d’hypothèses évaluant l’égalité de moyennes vectorielles : l’hypothèse nulle stipule formellement H0 : μ1 = μ2 = … = μk.
Lorsque les données empiriques satisfont avec rigueur les postulats formels exigés par ces modèles paramétriques — à savoir :
- La normalité de la distribution des résidus au sein de chaque groupe expérimental,
- L’homogénéité des variances intra-groupes ou homoscédasticité (validée par le test de Levene),
- L’indépendance stochastique des erreurs de mesure,
les tests paramétriques fondés sur la comparaison de moyennes déploient une puissance statistique maximale. Cela signifie qu’ils maximisent la probabilité de rejeter formellement une hypothèse nulle fausse (1 – β), détectant ainsi de subtiles différences d’efficacité thérapeutique là où d’autres approches échoueraient par manque de sensibilité métrique.
Néanmoins, la vulnérabilité de cette machinerie paramétrique s’avère considérable lorsque ces postulats sont transgressés. Face à des distributions hautement asymétriques ou parasitées par des variances hétéroscédastiques massives couplées à des effectifs inégaux, le test t de Student et l’ANOVA voient leur taux réel d’erreur de première espèce (taux α de faux positifs) diverger dramatiquement du seuil nominal de 5 %. Les inférences tirées de l’examen de moyennes non assainies deviennent alors statistiquement invalides, exposant l’équipe de recherche au risque d’annoncer des découvertes scientifiques purement fallacieuses.
10.2 Correspondance entre médiane et tests non paramétriques
Lorsque la structure des observations contredit irrémédiablement les postulats gaussiens ou que l’on manipule des variables ordinales pures, la cohérence méthodologique commande de basculer vers les tests non paramétriques ou tests de distribution libre. Dans ce paradigme alternatif, le test U de Mann-Whitney (équivalent non paramétrique du test t pour groupes indépendants), le test des rangs signés de Wilcoxon (analogue pour mesures répétées) et le test de Kruskal-Wallis (substitut de l’ANOVA à un facteur) constituent les procédures d’arbitrage de référence. Ces méthodes transforment les scores métriques bruts en une séquence continue de rangs ordinaux croissants.
Une nuance méthodologique capitale, trop souvent méconnue des praticiens, doit cependant être expressément explicitée : les tests non paramétriques basés sur les rangs ne comparent pas directement et exclusivement des médianes arithmétiques pures, mais évaluent formellement la dominance stochastique entre deux distributions d’échantillons. Le test de Mann-Whitney compare en réalité l’hypothèse nulle selon laquelle la probabilité qu’une observation issue de la population X surpasse une observation issue de la population Y est rigoureusement égale à 0,50 : P(X > Y) = P(Y > X) = 0,50.
Ce n’est que sous le postulat subsidiaire d’une stricte identité morphologique des formes de distribution entre les deux groupes (c’est-à-dire une distribution de scores présentant un skewness et une variance strictement comparables, simplement translatée spatialement par un paramètre d’emplacement) que le rejet de l’hypothèse nulle d’un test de Mann-Whitney ou de Kruskal-Wallis peut être formellement assimilé à une différence significative entre les médianes des deux populations. Si cette condition de morphologie similaire est vérifiée, ces tests non paramétriques fournissent une sécurité méthodologique absolue sur les petits effectifs cliniques (N < 15 par groupe), préservant le taux nominal de l’erreur α tout en s’affranchissant du diktat de la normalité.
10.3 Techniques de rééchantillonnage et bootstrap
Face au dilemme classique opposant l’efficacité des méthodes paramétriques axées sur la moyenne et la robustesse des alternatives non paramétriques centrées sur la médiane, l’essor computationnel moderne a ouvert une troisième voie d’une souplesse exceptionnelle : les techniques de rééchantillonnage par bootstrap (ou auto-amorçage). Théorisée initialement par le statisticien Bradley Efron, la méthodologie du bootstrap permet d’estimer avec une précision remarquable la distribution d’échantillonnage empirique de n’importe quel estimateur complexe — qu’il s’agisse de la médiane, de la moyenne tronquée ou d’une différence de médianes — sans dépendre d’aucun postulat théorique quant à la normalité de la population sous-jacente.
Le principe computationnel est d’une remarquable simplicité théorique : l’algorithme génère des milliers d’échantillons de substitution (typiquement B = 5 000 à B = 10 000 réplications bootstrap) par tirage avec remise de taille N au sein de la cohorte empirique originale. Pour chaque échantillon rééchantillonné, l’estimateur de tendance centrale ciblé est recalculé. À partir de ce vecteur massif d’estimations, le logiciel calcule directement des intervalles de confiance robustes — par la méthode des percentiles ou par l’approche plus sophistiquée de l’intervalle bootstrap corrigé pour le biais et accéléré (BCa).
Le bootstrap démocratise ainsi l’inférence rigoureuse sur la médiane. Auparavant, dériver un intervalle de confiance formel pour la médiane s’avérait analytiquement aride et peu standardisé au sein des progiciels statistiques de laboratoire. Grâce aux procédures bootstrap intégrées dans les environnements statistiques contemporains (tels que le langage R, Python, ou les modules avancés de JASP et SPSS), le chercheur peut désormais quantifier l’incertitude entourant son estimation médiane de manière non paramétrique, unifiant harmonieusement la robustesse de l’indicateur d’emplacement et la rigueur de l’inférence probabiliste contemporaine.
11. Visualisation graphique et restitution des tendances centrales
11.1 Diagrammes en boîte et représentation visuelle de la médiane
La restitution visuelle et la communication des tendances centrales ne constituent pas un simple choix cosmétique d’édition : elles conditionnent la transparence scientifique des données et préviennent les erreurs de lecture diagnostique. Dans cette perspective sémiotique, le diagramme en boîte et moustaches (boxplot), initialement conceptualisé par le mathématicien John W. Tukey, s’impose comme le dispositif graphique par excellence pour matérialiser la médiane et sa dispersion non paramétrique associée.
L’anatomie d’une boîte à moustaches de Tukey traduit immédiatement la structure des statistiques d’ordre d’un échantillon :
- Le segment transversal intérieur matérialise sans ambiguïté la médiane (Q2).
- Les bords inférieur et supérieur de la boîte correspondent respectivement au premier quartile (Q1, 25e percentile) et au troisième quartile (Q3, 75e percentile), encapsulant la moitié centrale (50 %) exacte de l’échantillon au sein de l’écart interquartile (IQR = Q3 – Q1).
- Les moustaches s’étendent classiquement jusqu’à l’observation la plus éloignée ne dépassant pas 1,5 fois l’IQR à partir des charnières.
- Les points individuels figurant au-delà de ces frontières sont projetés individuellement sous forme d’outliers formellement identifiés.
Cette visualisation surpasse radicalement les graphiques en barres d’erreurs traditionnels (surnommés péjorativement dynamite plungers). Alors qu’un histogramme opaque dissimule les anomalies sous une barre monochrome, la boîte à moustaches rend compte immédiatement de l’asymétrie de la distribution : si la médiane est décentrée au sein de la boîte et que les moustaches présentent des longueurs disproportionnées, le clinicien identifie d’un coup d’œil l’asymétrie droite ou gauche du phénomène évalué sans risque d’erreur d’interprétation.
11.2 Graphiques d’erreurs et représentation visuelle de la moyenne
Lorsque la structure métrique et la normalité de la distribution autorisent l’emploi préférentiel de la moyenne arithmétique, la restitution graphique de cet estimateur doit obéir à des normes de translucidité méthodologique rigoureuses. Présenter une moyenne arithmétique isolée, sans lui adjoindre la représentation graphique explicite de sa métrique de dispersion associée, constitue une faute de communication scientifique. La convention contemporaine exige que la moyenne soit matérialisée par un point nodal ou une barre de niveau, flanquée d’un intervalle d’erreur calibré sur une base d’incertitude mathématiquement définie.
L’analyste dispose à cet égard de trois métriques fondamentales de dispersion, dont la signification ne saurait être confondue :
- L’écart type (SD) : illustre la dispersion et l’hétérogénéité biologique directe des scores individuels autour de la moyenne au sein de l’échantillon.
- L’erreur type de la moyenne (SEM) : quantifie l’incertitude de l’estimation de l’espérance mathématique, reflétant la variabilité de la distribution d’échantillonnage théorique (SEM = SD / √N).
- L’intervalle de confiance à 95 % (IC 95 %) : circonscrit la zone d’indécision paramétrique au sein de laquelle le véritable paramètre moyen de la population parente se situe avec une probabilité asymptotique de 95 %.
Les recommandations méthodologiques contemporaines édictées par les comités de rédaction scientifique proscrivent désormais l’emploi des graphiques en barres classiques qui occultent la dispersion réelle des données. Les bonnes pratiques imposent l’hybridation des barres d’erreurs avec le tracé systématique du nuage de points individuels bruts (strip chart ou jitter plot superposé). Cette transparence graphique permet au lecteur de vérifier personnellement la symétrie de la distribution et l’absence de valeurs aberrantes susceptibles de vicier l’interprétation de la moyenne rapportée.
11.3 Diagrammes combinés en violon et tracés de densité
Au confluent de la boîte à moustaches et de l’histogramme paramétrique s’est imposée une solution graphique d’une puissance expressive inégalée : le diagramme en violon (violin plot), complété par les tracés d’estimation de densité par noyau (KDE). Cette visualisation hybride juxtapose la structure ordinale de la boîte de Tukey avec une silhouette polygonale continue dont la largeur locale est rigoureusement proportionnelle à la densité probabiliste des observations à chaque niveau de l’échelle d’évaluation.
Le raffinement analytique ultime réside dans l’intégration simultanée de la moyenne arithmétique et de la médiane au cœur même de la silhouette de violon :
- La médiane est classiquement repérée par un point blanc ou un trait noir gras, ancrée au centre du bloc interquartile.
- La moyenne arithmétique est dessinée sous forme d’une ligne discontinue de couleur contrastée traversant le corps du violon.
Cette double figuration résout de manière éclatante l’ambiguïté interprétative pour le chercheur et pour le lecteur :
- Si la ligne discontinue de la moyenne et le point médian se superposent rigoureusement sur le renflement le plus large du tracé, la normalité gaussienne symétrique est démontrée de visu.
- Si le violon exhibe un rétrécissement sinueux prolongé vers le haut avec un décrochage visible entre la médiane stable et une moyenne tractée vers le sommet, l’asymétrie positive saute aux yeux du statisticien.
- De surcroît, le diagramme en violon dévoile instantanément les phénomènes pathologiques de bimodalité ou de multimodalité — situations critiques où la présence de deux renflements distincts signale la coexistence de deux sous-groupes cliniques au sein de la même cohorte —, une réalité métrologique complexe que la moyenne comme la médiane échouent totalement à formaliser de manière isolée.
12. Guide méthodologique et arbre décisionnel de synthèse
12.1 Algorithme décisionnel séquentiel pour le praticien
Afin de guider le chercheur, l’étudiant et le praticien de terrain dans le choix de l’estimateur de tendance centrale adapté à son protocole, nous proposons un algorithme décisionnel séquentiel articulé en trois étapes diagnostiques rigoureuses et hiérarchisées. Cet itinéraire logique doit être parcouru systématiquement avant toute divulgation de résultats ou sélection de tests inférentiels.
Étape 1 : Diagnostic métrologique du niveau de mesure de la variable
L’analyste examine d’abord la nature fondamentale de la métrique selon la classification de Stevens. Si la variable est strictement nominale (catégories qualitatives), aucun des deux indicateurs ne convient ; seul le mode est licite. Si la variable est de nature ordinale pure (échelles de Likert individuelles, classements hiérarchiques, stades cliniques de gravité sans équidistance métrique démontrée), le choix s’arrête immédiatement : la médiane constitue l’unique estimateur mathématiquement légitime. Si et seulement si la variable satisfait au statut d’échelle d’intervalles ou d’échelle de rapports continus, l’analyste est autorisé à franchir l’étape suivante.
Étape 2 : Évaluation quantitative et morphologique de la distribution
Sur la variable quantitative continue identifiée, le praticien procède à un audit distributionnel complet associant :
- Le calcul des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis),
- L’exécution du test de normalité de Shapiro-Wilk (pour N < 50) ou l’évaluation visuelle rigoureuse d’un diagramme quantile-quantile (Q-Q plot),
- L’examen de l’histogramme de densité à la recherche d’une éventuelle bimodalité.
Si la distribution s’écarte significativement de la symétrie normale (asymétrie absolue marquée, déviation non linéaire sur le Q-Q plot), la médiane s’impose impérativement pour caractériser descriptivement la population. Si la distribution est approximativement symétrique et unimodale, l’accès à l’étape finale est validé.
Étape 3 : Audit de contamination et identification des valeurs aberrantes
Le chercheur scrute l’échantillon au moyen d’un diagramme en boîte de Tukey ou par le calcul des scores zed standardisés (en marquant toute observation au-delà de |z| > 3,0 ou 3,29 écarts types). Si des valeurs atypiques majeures émergent et que leur genèse relève d’artefacts non éliminables ou d’une variabilité clinique légitime que l’on souhaite conserver sans biaiser l’estimation centrale, la médiane (ou subsidiairement une moyenne tronquée à 20 %) doit être privilégiée. Si aucune contamination n’est détectée et que les étapes 1 et 2 sont pleinement validées, l’analyste peut déployer en toute sérénité la moyenne arithmétique, exploitant son efficacité maximale au sein de modèles inférentiels paramétriques.
12.2 Normes de rédaction et de communication selon le style APA
La communication publique des résultats au sein de la littérature scientifique internationale impose une standardisation méticuleuse, dont les directives sont périodiquement codifiées par l’American Psychological Association au sein de son manuel officiel (7e édition). Les chercheurs sont tenus de respecter des normes typographiques et statistiques strictes lors de la transcription de leurs mesures descriptives dans le corps du manuscrit ou dans les tableaux récapitulatifs.
Pour la moyenne arithmétique, les prescriptions formelles sont les suivantes :
- La moyenne est désignée par la lettre latine majuscule M, obligatoirement mise en italique : M.
- Elle ne doit jamais être rapportée de manière isolée : elle doit être systématiquement accompagnée de l’écart type, noté SD en italique, ou subsidiairement de son intervalle de confiance à 95 % (noté IC 95 % ou 95% CI).
- Typographie standard d’insertion dans le texte : « Les participants du groupe contrôle ont obtenu un score mnésique significativement plus élevé (M = 24,32, SD = 3,45) que les patients cérébrolésés (M = 17,15, SD = 4,12). »
- Règle de précision décimale : les valeurs doivent être arrondies avec discernement, en général à deux décimales après la virgule (ou une seule décimale si l’appareil de mesure initial ne comporte aucune subdivision millimétrique).
Pour la médiane, les conventions d’écriture répondent aux exigences suivantes :
- La médiane est représentée dans le texte par l’abréviation Mdn, rédigée en italique : Mdn.
- L’indice de dispersion non paramétrique qui lui est obligatoirement indissociable est l’intervalle interquartile, noté IQR (ou le premier et troisième quartiles explicites Q1-Q3).
- Typographie standard d’insertion dans le texte : « Le délai d’endormissement subjectif chez les sujets souffrant d’insomnie chronique s’est révélé substantiel (Mdn = 55,00 minutes, IQR = 32,50) comparativement aux dormeurs sains (Mdn = 15,00 minutes, IQR = 10,00). »
Par ailleurs, dans les situations où la distribution présente une asymétrie modérée mais tolérable, les comités de rédaction de nombreuses revues à fort impact encouragent un double rapportage exhaustif : mentionner simultanément la moyenne (avec son SD) et la médiane (avec son IQR) offre aux lecteurs et aux spécialistes de méta-analyses la totalité du panorama distributionnel sans exiger l’accès aux données brutes.
12.3 Erreurs fréquentes et pièges d’interprétation à proscrire
L’inventaire critique des publications scientifiques et des rapports d’expertise clinique met en lumière la récurrence de bévues méthodologiques tenaces, que tout chercheur rigoureux doit s’employer à éradiquer. La première faute, omniprésente dans la vulgarisation médiatique et administrative, consiste à confondre la médiane de l’échantillon avec l’espérance mathématique individuelle ou le pronostic clinique absolu. Lorsqu’un oncologue ou un neurologue annonce une survie médiane de 18 mois pour une affection neurodégénérative, une frange substantielle de profanes et de soignants interprète erronément ce chiffre comme une borne prédictive inexorable à laquelle chaque patient succombera. C’est oublier que 50 % des malades dépasseront ce terme, certains pouvant survivre des décennies au-delà de ce point médian d’inflexion.
Un second piège d’interprétation, corollaire inverse du précédent, réside dans la croyance selon laquelle la médiane serait universellement et intrinsèquement supérieure à la moyenne en toute circonstance en vertu de sa « robustesse ». Cette dérive conduit certains analystes à renoncer paresseusement à l’usage de la moyenne arithmétique sur des distributions quasi normales, sous prétexte d’éviter l’évaluation des postulats de linéarité. Ce renoncement injustifié s’accompagne d’une dégradation de la puissance statistique des protocoles, exigeant des recrutements de participants inutilement lourds pour détecter des tailles d’effet réelles. La robustesse de la médiane ne confère pas une dispense d’efficience mathématique.
Enfin, une dernière transgression méthodologique consiste à calculer une moyenne sans explorer au préalable la présence d’une bimodalité sous-jacente. Dans une distribution biomodale pure — résultant par exemple de l’amalgame au sein d’une même cohorte d’individus totalement réfractaires et de sujets hautement répondeurs à une psychothérapie —, la moyenne arithmétique se positionne exactement dans le creux intermédiaire entre les deux pics. Elle quantifie alors une zone vide où ne se situe quasiment aucun être humain réel. Proclamer que ce score barycentrique représente la « moyenne » de l’échantillon constitue une aberration descriptive absolue : le devoir de l’analyste est de partitionner l’échantillon en deux sous-groupes homogènes avant de calculer la moindre mesure de tendance centrale.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. Chapman & Hall/CRC. https://doi.org/10.1201/9780429246593
Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
Rousselet, G. A., Pernet, C. R., & Wilcox, R. R. (2017). Beyond differences in means: Robust graphical methods to compare two independent groups. European Journal of Neuroscience, 46(2), 1738–1748. https://doi.org/10.1111/ejn.13610
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Whelan, R. (2008). Effective analysis of reaction time data. The Psychological Record, 58(3), 475–482. https://doi.org/10.1007/BF03395630
Wilcox, R. R. (2022). Introduction to robust estimation and hypothesis testing (5th ed.). Academic Press. https://doi.org/10.1016/C2019-0-03828-9