
L’analyse des phénomènes complexes en sciences humaines, sociales et biomédicales requiert une modélisation fine des interdépendances entre facteurs prédictifs. Dans le cadre de la démarche expérimentale et quasi-expérimentale, l’investigation ne se limite que rarement à l’évaluation d’un facteur isolé ; elle sonde plutôt la manière dont plusieurs déterminants s’articulent, se renforcent, s’atténuent ou s’annulent mutuellement. Le graphique d’interaction constitue l’instrument sémiotique et analytique privilégié pour appréhender cette complexité multivariée. En traduisant visuellement la non-linéarité et la contingence des effets expérimentaux, il permet au chercheur de dépasser les simplifications abusives inhérentes à l’examen exclusif des effets principaux pour saisir la dynamique systémique qui régit les données empiriques.
Bien que des environnements logiciels spécialisés tels que R, SPSS ou SAS soient couramment mobilisés dans les laboratoires universitaires pour les calculs inférentiels, Microsoft Excel demeure une plateforme universellement déployée, dotée d’une flexibilité graphique remarquable lorsqu’elle est exploitée avec rigueur. Trop souvent sous-estimé ou cantonné à des représentations gestionnaires basiques, le tableur d’Excel recèle l’ensemble des fonctionnalités nécessaires pour construire des figures hautement sophistiquées, rigoureusement conformes aux exigences typographiques et méthodologiques des revues scientifiques internationales, notamment les normes établies par l’American Psychological Association (APA). L’enjeu réside dans la maîtrise de l’architecture des données, le calibrage précis des paramètres d’affichage et l’adjonction systématique d’indicateurs de variabilité indispensables à l’intégrité scientifique.
Ce guide exhaustif a été conçu pour accompagner les chercheurs, enseignants-chercheurs, doctorants et analystes de données à travers chaque étape de l’élaboration, de l’optimisation et de l’interprétation critique d’un graphique d’interaction sous Excel. En articulant les soubassements théoriques du modèle linéaire général avec des protocoles opératoires pas à pas, ce manuel fournit les clés méthodologiques permettant de transformer des matrices de données brutes en visualisations académiques de haute précision, prêtes pour l’évaluation par les pairs et la publication scientifique.
1. Introduction méthodologique aux graphiques d’interaction dans la recherche scientifique
1.1 Définition et rôle fondamental du graphique d’interaction
Dans le domaine de l’analyse statistique bivariée et multivariée, un graphique d’interaction est une représentation bidimensionnelle conçue pour illustrer la manière dont l’effet d’une variable indépendante (souvent désignée comme le facteur principal ou prédicteur) sur une variable dépendante continue varie en fonction des niveaux ou modalités d’une seconde variable indépendante, appelée variable modératrice. D’un point de vue géométrique, ce graphique projette les moyennes de cellules issues d’un devis expérimental factoriel sous la forme de points reliés par des segments de droite. La caractéristique essentielle de cette visualisation réside dans l’orientation relative de ces segments : la non-parallélité des pentes signale l’existence potentielle d’une interaction statistique, indiquant que l’impact d’un facteur n’est pas uniforme mais conditionné par le contexte opératoire instauré par le second facteur.
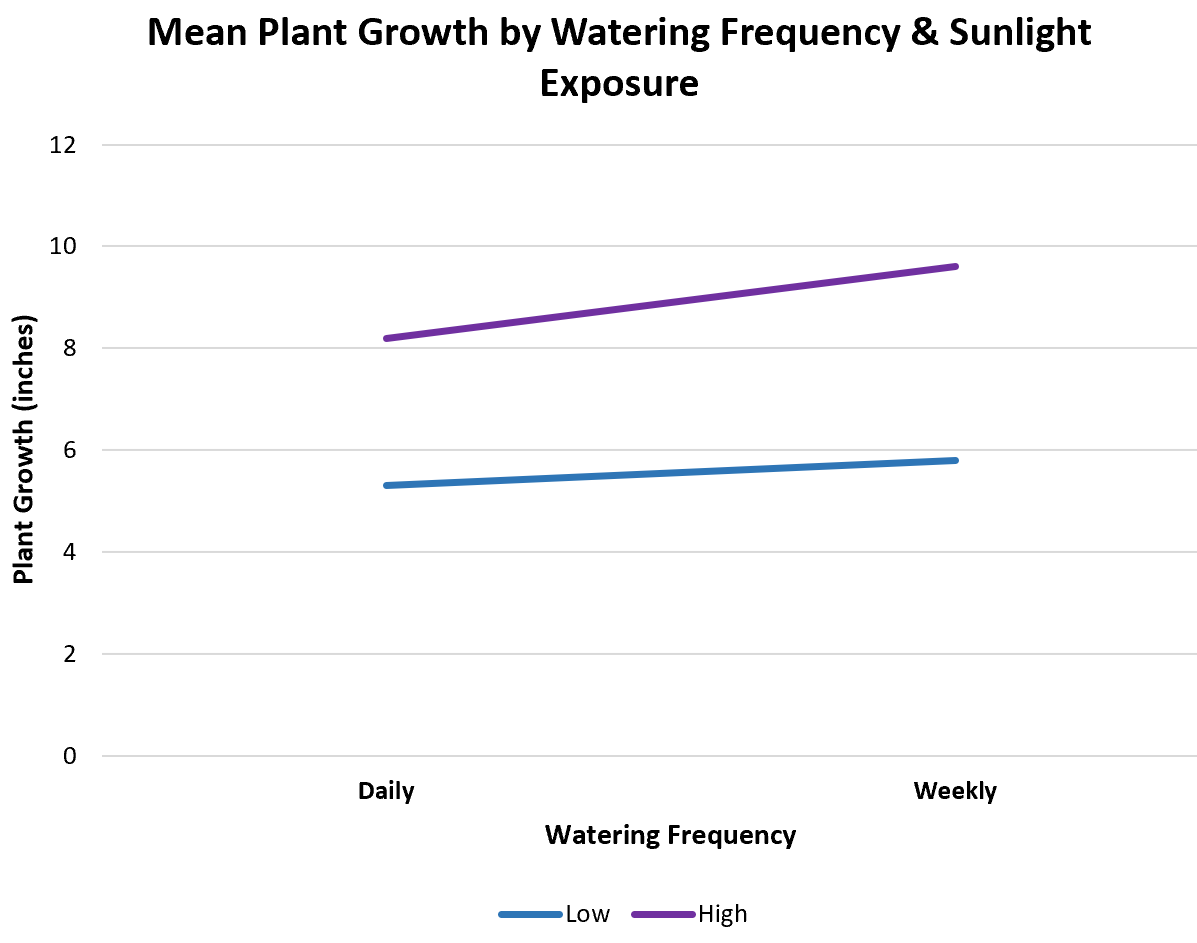
Cette mise en évidence visuelle de la modération statistique joue un rôle déterminant dans les paradigmes expérimentaux modernes. Loin d’être un simple artifice d’illustration, le graphique d’interaction remplit une double fonction épistémologique : exploratoire et confirmatoire. Dans la phase exploratoire, il permet à l’expérimentateur d’inspecter visuellement la directionnalité des tendances, d’identifier des effets plafonds ou planchers inattendus, et d’orienter les contrastes analytiques ultérieurs. Dans une perspective confirmatoire, il matérialise le test des hypothèses formulées a priori en psychologie cognitive, en neurosciences comportementales ou en sociologie quantitative, en offrant un support intuitif pour communiquer des dynamiques de modération complexes qui resteraient opaques à la simple lecture d’un tableau de coefficients de régression.
Il convient d’établir une distinction théorique fondamentale entre les effets additifs et les effets multiplicatifs. Un modèle purement additif postule que l’effet global de deux variables équivaut strictement à la somme de leurs effets isolés ; dans cette configuration, les pentes du graphique demeurent rigoureusement parallèles. En revanche, un effet multiplicatif ou interactif traduit un phénomène d’interdépendance non linéaire où l’action conjointe des facteurs génère un résultat qui dévie de la simple additivité algébrique. L’aptitude du graphique à révéler ces écarts à l’additivité en fait un instrument incontournable de la recherche contemporaine.
1.2 Pertinence de l’utilisation d’Excel en modélisation expérimentale
L’utilisation de Microsoft Excel dans un contexte de recherche fondamentale et appliquée suscite parfois des réticences infondées, souvent motivées par une préférence pour des syntaxes de programmation scriptées. Pourtant, l’accessibilité universelle d’Excel, son omniprésence dans les infrastructures institutionnelles et l’absence de barrière à l’entrée logicielle constituent des atouts majeurs pour la démocratisation des compétences analytiques chez les étudiants et les jeunes chercheurs. Au-delà de sa convivialité, le moteur graphique vectoriel d’Excel offre un niveau de personnalisation micrométrique permettant d’ajuster chaque composant visuel avec une précision chirurgicale, rivalisant sans peine avec les figures produites par des logiciels spécialisés réputés rigides dans leurs paramétrages par défaut.
L’un des avantages les plus notables du tableur réside dans l’intégration transparente et dynamique entre la feuille de calcul des données brutes, les tables récapitulatives de moyennes et la figure géométrique finale. Contrairement aux environnements où les calculs intermédiaires sont dissimulés dans des objets informatiques abstraits, Excel expose la mécanique computationnelle à chaque étape. Cette visibilité permanente favorise une compréhension intuitive des liens mathématiques unissant la variance observée, l’erreur standard et la dispersion spatiale des points tracés sur le graphique.
De surcroît, la standardisation des flux de travail dans Excel permet d’automatiser la mise à jour des visualisations en cas de réplication expérimentale ou d’adjonction de nouvelles cohortes de sujets. Grâce à la liaison dynamique entre les formules de calcul d’agrégats et les plages sources du tracé, toute modification ou correction appliquée à la matrice de données primitives se répercute instantanément sur la géométrie des courbes, garantissant une cohérence documentaire inaltérable tout au long du processus de rédaction du manuscrit scientifique.
1.3 Objectifs pédagogiques et structure du protocole
Ce protocole vise avant tout à développer une triple compétence chez le praticien : technique, esthétique et épistémologique. Sur le plan technique, il s’agit d’acquérir une maîtrise sans faille des fonctionnalités avancées d’Excel, incluant la manipulation des séries de données matricielles, l’insertion personnalisée de mesures de variabilité expérimentale et la configuration des systèmes de coordonnées cartésiennes. Ces manipulations seront détaillées en tenant compte des nuances opératoires propres aux versions contemporaines du logiciel, qu’il s’agisse de Microsoft 365, d’Excel 2021 ou des versions antérieures couramment installées dans les laboratoires.
Sur le plan stylistique et typographique, l’objectif est d’inculquer le respect rigoureux des standards internationaux de présentation scientifique, avec une focalisation spécifique sur les recommandations de la septième édition du manuel de l’APA. L’élimination du superflu décoratif, la maîtrise du contraste chromatique pour l’accessibilité visuelle et l’exactitude de l’étiquetage des unités de mesure font partie intégrante des exigences formelles imposées par les comités de lecture des revues à fort impact. La figure finale doit être autosuffisante, sobre et dénuée de toute ambiguïté interprétative.
Enfin, sur le plan interprétatif, ce guide se propose d’aiguiser le regard critique du chercheur face aux trajectoires de pentes visualisées. Savoir discerner si une divergence de tracés reflète une véritable modulation statistique significative ou un simple bruit d’échantillonnage aléatoire nécessite de croiser en permanence l’intuition géométrique avec l’inférence formelle issue des tables d’analyse de variance. À l’issue de cet apprentissage, le lecteur sera capable non seulement de tracer un graphique irréprochable, mais aussi de verbaliser avec exactitude les implications théoriques des patterns observés dans sa discipline d’appartenance.
2. Fondements théoriques des plans factoriels 2×2 en psychologie expérimentale
2.1 Architecture et logique des devis factoriels 2×2
Le devis factoriel 2×2 représente la structure expérimentale canonique par excellence dans les sciences du comportement. Il organise l’investigation empirique en croisant de manière exhaustive deux facteurs indépendants discrets (nommés conventionnellement Facteur A et Facteur B), chacun comportant précisément deux modalités ou niveaux distincts. Cette combinatoire génère une matrice orthogonale de quatre conditions expérimentales élémentaires (souvent désignées comme des cellules expérimentales : A1B1, A1B2, A2B1 et A2B2). Cette architecture systématique permet d’évaluer simultanément l’impact isolé de chaque variable tout en quantifiant précisément leur synergie ou antagonisme potentiel.
En fonction de la nature de l’échantillonnage et de l’assignation des participants, ces plans peuvent se décliner selon trois modalités méthodologiques majeures. Dans un plan factoriel entièrement inter-sujets (ou groupes indépendants), chaque participant n’est exposé qu’à une seule des quatre conditions, ce qui neutralise les effets d’apprentissage mais requiert une taille d’échantillon globale substantielle pour garantir une puissance statistique adéquate. Dans un plan entièrement intra-sujets (ou mesures répétées), chaque participant subit consécutivement les quatre conditions expérimentales, ce qui optimise la puissance en contrôlant la variance interindividuelle au prix d’exigences sévères de contrebalancement. Enfin, le devis mixte (split-plot) associe un facteur inter-sujets (tel qu’un groupe clinique versus témoin) et un facteur intra-sujets (tel qu’un pré-test versus post-test), combinant ainsi l’économie d’échantillonnage et la modélisation longitudinale.
Le traitement des données issues de ces devis repose sur la confrontation systématique des moyennes cellulaires et des moyennes marginales. Les moyennes marginales, calculées en agrégeant les données à travers les modalités d’un facteur donné indépendamment de l’autre, sous-tendent les tests des effets principaux. En revanche, l’évaluation de l’interaction examine si les écarts entre les cellules au sein d’une ligne de la matrice expérimentale sont invariants lorsqu’on examine la ligne adjacente. L’hypothèse nulle (H0) relative à l’interaction postule que la différence (A1B1 – A1B2) est égale à la différence (A2B1 – A2B2), tandis que l’hypothèse alternative (H1) affirme une rupture de cette égalité différentielle.
2.2 Formalisation statistique de l’effet d’interaction
Dans le cadre théorique unifié du modèle linéaire général, l’effet d’interaction s’exprime mathématiquement par l’inclusion d’un terme de produit vectoriel au sein de l’équation de régression sous-jacente. Pour une observation individuelle Y mesurée sous les conditions i du facteur A et j du facteur B, l’équation s’écrit formellement sous la forme :
Yijk = μ + αi + βj + (αβ)ij + εijk
Dans ce formalisme, μ représente la moyenne générale non pondérée des populations, αi désigne l’effet différentiel principal de la modalité i du premier facteur, βj l’effet différentiel principal de la modalité j du second facteur, et εijk symbolise l’erreur résiduelle stochastique propre à chaque individu. Le terme central (αβ)ij modélise l’écart spécifique de la cellule ij par rapport à ce que prédirait la simple addition des effets principaux constitutifs (μ + αi + βj). C’est précisément l’ampleur et la signification statistique de ce coefficient multiplicatif qui attestent de la réalité de l’interaction.
L’existence d’une interaction statistiquement significative modifie radicalement la portée épistémologique des effets principaux. Lorsqu’un terme interactif atteint le seuil de significativité conventionnel (typiquement p < 0,05), l’interprétation isolée des effets principaux devient potentiellement trompeuse, voire fallacieuse. Affirmer de manière globale que le facteur A exerce une influence ascendante sur la variable dépendante s’avère conceptuellement invalide si cette progression ne se vérifie que sous une seule modalité du facteur B, ou pire, si elle s’inverse sous l’autre modalité. En conséquence, la détection formelle d’une interaction impose la suspension des conclusions relatives aux effets principaux au profit d’une analyse conditionnelle des effets simples, dont le graphique constitue le vecteur d’intelligibilité fondamental.
2.3 Exemple d’application empirique : Facteurs de stress et performance cognitive
Afin d’ancrer les développements méthodologiques de ce manuel dans une réalité tangible de laboratoire, nous adopterons un paradigme expérimental classique issu des neurosciences cognitives et de la psychologie ergonomique. Nous étudions l’impact conjoint du niveau d’exigence d’une tâche et de la fatigue biologique sur l’efficience attentionnelle de contrôleurs aériens ou de professionnels de santé opérant en milieu critique.
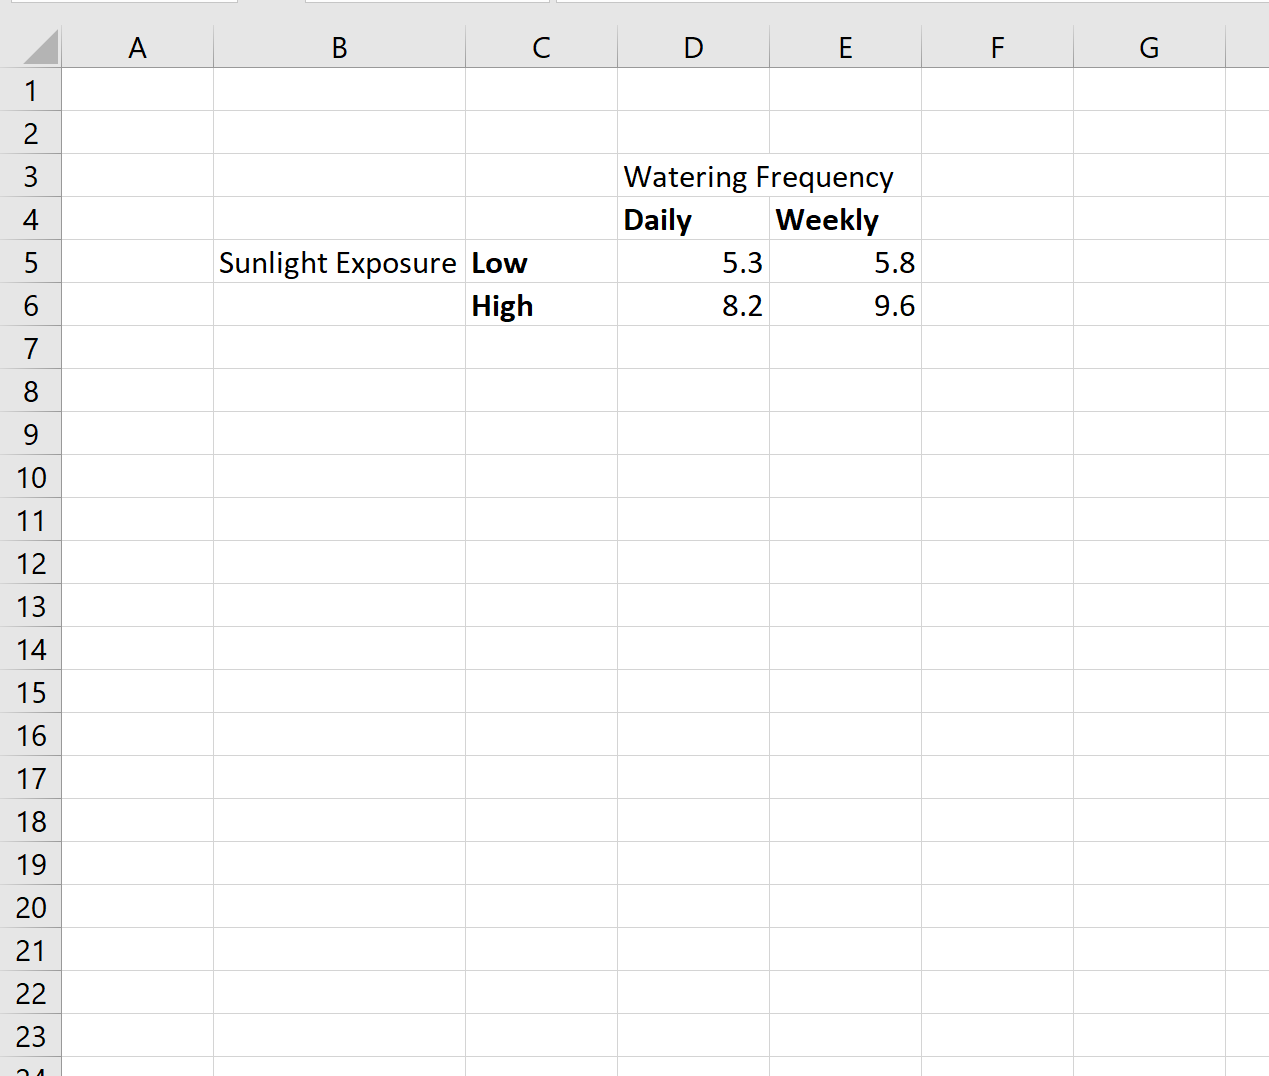
Le Facteur A représente le Niveau de charge mentale, opérationnalisé sous deux modalités distinctes : une charge mentale dite « Faible » (condition de surveillance passive avec faible densité d’informations visuelles) et une charge mentale « Élevée » (condition d’arbitrage multisources sous forte pression temporelle). Le Facteur B modélise la Privation de sommeil, scindé en deux niveaux contrastés : un état de « Vigilance normale » (sommeil réparateur standard de 8 heures précédant la session expérimentale) versus un état de « Privation prolongée » (période de veille continue imposée de 24 heures en laboratoire avant la passation des épreuves psychométriques).
La variable dépendante retenue est le temps de réaction moyen, rigoureusement quantifié en millisecondes (ms), lors de la détection de signaux critiques rares au sein d’une tâche de vigilance continue de type psychomotor vigilance task (PVT). Afin d’alimenter nos tutoriels sous Excel, nous établissons le jeu de moyennes empiriques synthétiques suivant :
- Charge mentale Faible / Sommeil Normal : 350 ms (± 25 ms d’écart-type)
- Charge mentale Élevée / Sommeil Normal : 420 ms (± 30 ms d’écart-type)
- Charge mentale Faible / Privation de Sommeil : 460 ms (± 35 ms d’écart-type)
- Charge mentale Élevée / Privation de Sommeil : 680 ms (± 50 ms d’écart-type)
Ce jeu de données calibré illustre une hypothèse classique d’amplification pathologique de la charge mentale induite par la privation de sommeil, préfigurant une interaction ordinale divergente particulièrement spectaculaire à cartographier sous forme graphique.
3. Préparation et structuration rigoureuse de la matrice de données dans Excel
3.1 Organisation en tableau croisé pour le tracé graphique
La réussite de l’édition graphique sous Excel repose presque intégralement sur la rectitude de la configuration topologique des cellules sources. Les utilisateurs inexpérimentés commettent régulièrement l’erreur de tenter de générer un graphique d’interaction directement à partir d’une liste brute d’enregistrements en colonnes continues, ce qui égare le moteur de tracé cartésien. Pour qu’Excel associe instantanément les séries de données et les catégories d’abscisses adéquates, les données doivent être obligatoirement agencées sous forme d’une table croisée bidimensionnelle compacte.
Dans la première colonne du tableau récapitulatif (par exemple en cellule A2:A3), inscrivez les deux modalités de la variable destinée à occuper l’axe horizontal (l’axe des abscisses X), à savoir le Niveau de charge mentale (« Faible » et « Élevée »). La cellule A1 doit être laissée scrupuleusement vierge ou contenir un libellé neutre afin de faciliter la détection automatique des séries par Excel. Sur la première ligne adjacente (cellules B1:C1), inscrivez les deux modalités du facteur modérateur qui définiront les courbes distinctes, c’est-à-dire l’état de Privation de sommeil (« Sommeil Normal » et « Privation Prolongée »).
Les cellules centrales d’intersection (la plage B2:C3) recevront exclusivement les moyennes calculées correspondantes (respectivement 350, 460 en ligne 2, et 420, 680 en ligne 3). Veillez à ce que le formatage des cellules soit explicitement défini sur le type « Nombre » avec un nombre de décimales constant (par exemple zéro ou une décimale), en évitant toute insertion manuelle de caractères alphabétiques tels que « ms » à l’intérieur des cellules numériques, ce qui convertirait insidieusement vos valeurs quantitatives en chaînes de texte impropres au calcul graphique.
3.2 Extraction des moyennes à partir de données brutes avec les formules Excel
Dans la plupart des situations réelles de recherche, le chercheur dispose d’une feuille de données brutes compilant les scores individuels de dizaines de participants, organisée selon un format rectangulaire standard où chaque ligne représente un sujet ou un essai (ex. Colonne A : ID participant ; Colonne B : Charge_Mentale ; Colonne C : Sommeil ; Colonne D : Temps_Reaction_ms). Il est vivement déconseillé de calculer manuellement les moyennes sur une calculatrice externe pour les recopier ensuite, cette pratique brisant la traçabilité des analyses et augmentant le risque d’erreurs de saisie.
Pour extraire les moyennes conditionnelles de façon entièrement automatisée et dynamique, l’utilisation de la fonction MOYENNE.SI.ENS s’impose comme la solution la plus élégante. Dans la cellule d’intersection de votre table récapitulative destinée à recevoir la moyenne de la condition « Faible » et « Sommeil Normal », implémentez la syntaxe suivante :
=MOYENNE.SI.ENS(DonneesBrutes!$D:$D; DonneesBrutes!$B:$B; "Faible"; DonneesBrutes!$C:$C; "Normal")
Cette formulation ordonne au moteur de calcul de faire la moyenne des valeurs situées dans la colonne des temps de réaction, sous la double condition que la colonne B affiche le niveau « Faible » et la colonne C le statut « Normal ». Une approche alternative, tout aussi robuste pour le traitement de volumes de données massifs, consiste à générer un tableau croisé dynamique (TCD). En positionnant la variable Charge Mentale en zone de « Lignes », la Privation de Sommeil en zone de « Colonnes », et le Temps de Réaction en zone de « Valeurs » configurée sur l’agrégat « Moyenne », Excel structure instantanément la matrice 2×2 idéale, prête à être convertie en support de traçage.
3.3 Calcul préalable des indices de dispersion associés
Une représentation scientifique de moyennes est méthodologiquement irrecevable si elle est dépourvue d’une indication quantitative de la variance ou de la précision de l’estimation. Avant même de solliciter les modules graphiques d’Excel, il est impératif de construire une seconde table récapitulative, rigoureusement symétrique à la première, dédiée au stockage des indices de dispersion associés à chaque cellule expérimentale.
La statistique descriptive élémentaire de dispersion est l’écart-type de l’échantillon. Pour une condition donnée extraite de votre feuille de données brutes, celui-ci peut être calculé par une formule matricielle associant la fonction ECARTYPE.STANDARD et des instructions conditionnelles, ou par le tableau croisé dynamique en configurant les paramètres de champ sur « Écart-type ». Toutefois, dans les publications en psychologie et en neurosciences comportementales, l’indicateur universellement préconisé pour agrémenter les graphiques d’interaction est l’erreur standard de la moyenne (couramment abrégée SEM, pour Standard Error of the Mean).
La formule mathématique de l’erreur standard s’exprime comme le rapport de l’écart-type d’échantillon s sur la racine carrée de la taille de l’échantillon N (SEM = s / √N). Dans votre table miroir dédiée aux dispersions sous Excel, chaque cellule devra donc calculer dynamiquement ce ratio à partir des plages de données filtrées, en combinant les fonctions de la manière suivante :
=ECARTYPE.STANDARD(...) / RACINE(NB.SI.ENS(...))
En disposant ainsi, côte à côte, d’une table matricielle des moyennes et d’une table matricielle des SEM, vous préparez l’infrastructure computationnelle nécessaire à l’implémentation sans accroc des barres d’erreur personnalisées, garantissant une conformité absolue avec les standards de la science ouverte et de la métrologie rigoureuse.
4. Création pas à pas du graphique en lignes dans Excel
4.1 Sélection des plages de données et insertion de l’objet graphique
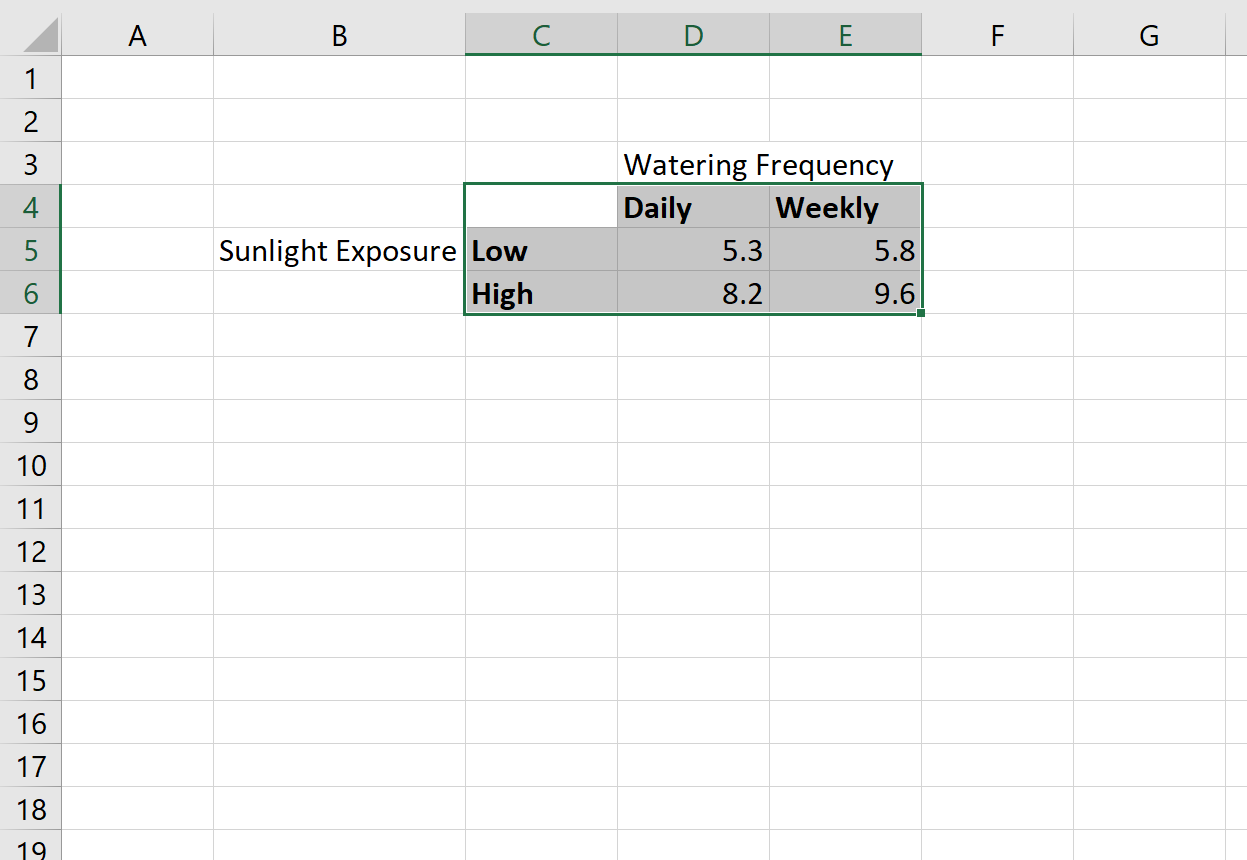
Une fois la table croisée des moyennes structurée conformément aux directives précédentes, sélectionnez avec votre curseur l’intégralité de la plage matricielle, en incluant impérativement les en-têtes textuels de colonnes et de lignes, mais en excluant formellement toute ligne de totalisation générale ou de moyenne marginale. Dans notre exemple, sélectionnez la plage A1:C3. Cette sélection englobant les libellés permet aux algorithmes de reconnaissance d’Excel de configurer immédiatement les légendes et les axes catégoriels sans intervention manuelle ultérieure.
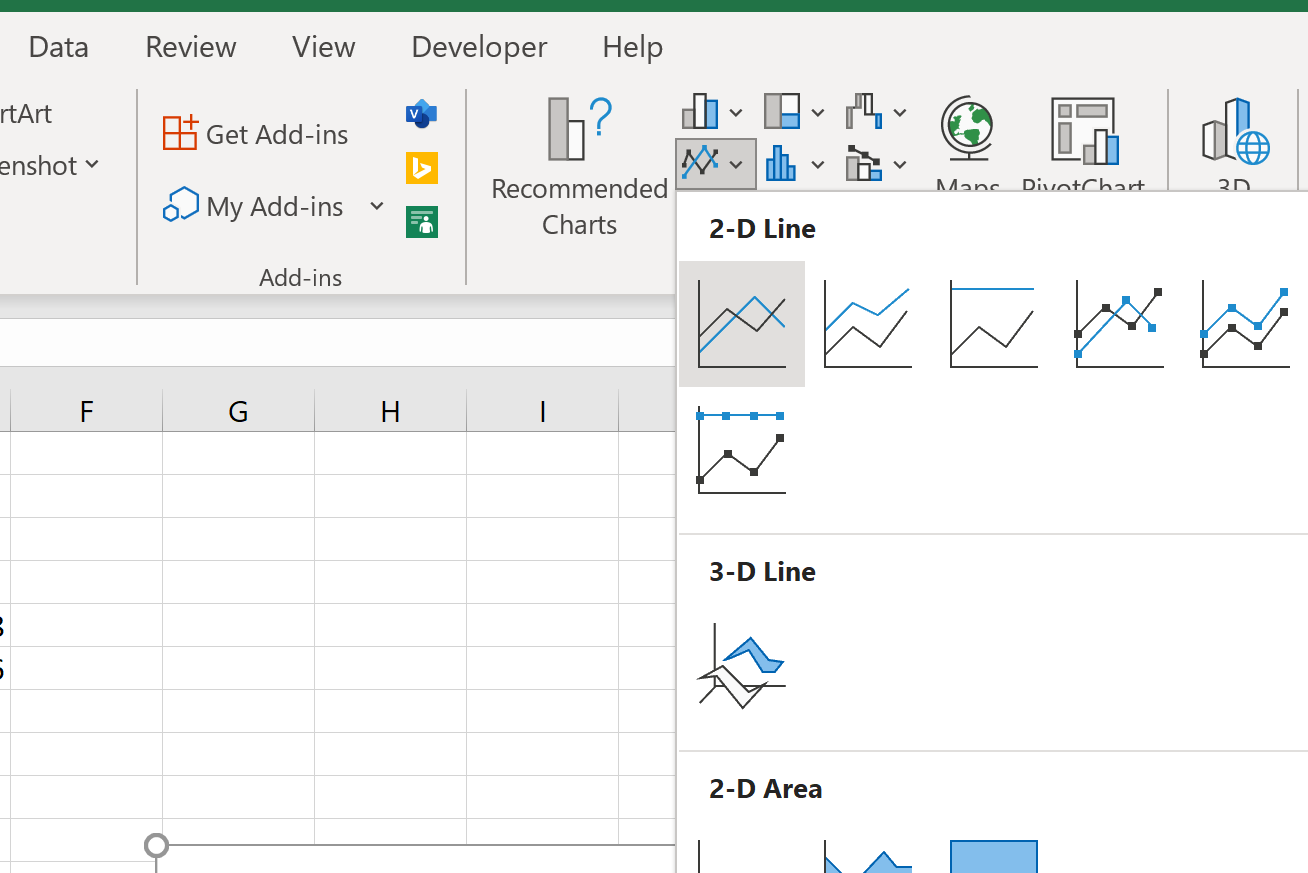
Dirigez-vous vers le ruban supérieur d’Excel et cliquez sur l’onglet Insertion. Dans la section dédiée aux graphiques, repérez l’icône représentant des graphiques en lignes ou en aires. Cliquez sur la flèche de déploiement et sélectionnez précisément le type de graphique intitulé Lignes avec marques (au sein de la sous-catégorie Lignes 2D). Il est capital d’éviter les graphiques en aires, les graphiques à courbes empilées ou les lissages 3D, ces derniers introduisant des artefacts visuels trompeurs qui altèrent dramatiquement la géométrie des relations factorielles.
L’emploi du graphique linéaire pour cartographier un devis factoriel 2×2 relève d’une convention épistémologique solidement ancrée. Bien que les variables indépendantes soient ici discrètes et catégorielles (et non continues), le tracé d’un segment reliant deux conditions ne vise pas à postuler l’existence d’états intermédiaires réels sur l’axe des abscisses, mais sert exclusivement d’opérateur visuel d’inclinaison. C’est l’angle de la pente et la comparaison des inclinaisons des différents segments qui permettent à l’œil humain de décoder instantanément l’existence ou l’absence d’une interaction statistique.
4.2 Vérification et ajustement de l’orientation des séries
Dès l’insertion du canevas graphique au sein de la feuille de calcul, une étape de vérification structurelle s’impose. En fonction de la forme géométrique de la sélection (nombre de lignes supérieur ou inférieur au nombre de colonnes), Excel effectue une déduction automatique de ce qu’il convient de placer sur l’axe des abscisses (catégories X) et dans la légende (séries Y). Très fréquemment, cette configuration automatique ne correspond pas à la vision théorique souhaitée par l’expérimentateur.
Pour permuter l’attribution des variables, cliquez sur le graphique pour activer les onglets contextuels du ruban, rendez-vous dans l’onglet Création de graphique, puis cliquez sur la commande Intervertir les lignes et les colonnes. Observez attentivement la métamorphose de la figure : les facteurs assignés à l’axe horizontal et aux courbes basculent immédiatement. Il est souvent pertinent de tester les deux configurations avant de finaliser la figure pour identifier celle qui maximise l’intelligibilité pédagogique du phénomène étudié.
Le choix conceptuel de l’attribution des rôles repose sur la nature fonctionnelle des variables. De manière conventionnelle, la variable théoriquement considérée comme le prédicteur primaire d’intérêt ou le facteur causal direct (ici, le Niveau de charge mentale) gagne à être positionnée sur l’axe horizontal des abscisses. La variable qui agit comme un modérateur circonstanciel, un filtre biologique ou un statut de groupe (ici, l’état de Privation de sommeil) s’illustre de manière plus intuitive sous forme de séries différenciées, représentées par des courbes distinctes au sein de la légende. Cette disposition permet d’examiner comment l’impact de la charge mentale « se plie » ou « s’amplifie » sous l’effet modérateur de la dette de sommeil.
4.3 Gestion des axes et des catégories initiales
L’inspection du graphique brut généré par le moteur par défaut d’Excel révèle quasi systématiquement des lacunes d’étiquetage qui doivent être corrigées immédiatement. Vérifiez en premier lieu que l’axe horizontal affiche sans ambiguïté les intitulés textuels qualitatifs « Faible » et « Élevée », et non des index numériques arbitraires (1 et 2). Si des chiffres apparaissent, cliquez avec le bouton droit sur le graphique, choisissez l’option Sélectionner des données, puis, dans le panneau latéral droit intitulé « Étiquettes de l’axe horizontal (abscisse) », cliquez sur Modifier et sélectionnez manuellement la plage de cellules textuelles correspondante (A2:A3).
Concernant l’axe vertical (axe des ordonnées Y), examinez la dynamique de l’échelle générée. Excel a pour comportement intrinsèque d’adapter les bornes minimale et maximale au plus près des extrema de vos moyennes empiriques. Si ce centrage resserré peut ponctuellement s’avérer utile, il provoque souvent une troncature drastique de la partie inférieure de l’axe, exagérant artificiellement la pente perçue des segments de droite et induisant chez le lecteur une perception hypertrophiée de l’effet d’interaction. Nous aborderons dans la section dédiée à l’optimisation visuelle les méthodes rigoureuses de paramétrage de ces bornes.
Enfin, assurez-vous de la présence effective de la légende d’identification des séries. À ce stade, la légende doit afficher clairement les deux modalités du second facteur (« Sommeil Normal » et « Privation Prolongée ») associées aux couleurs ou formes de marqueurs correspondantes. Si la légende chevauche la zone de traçage ou obstrue les points de données, repositionnez-la provisoirement par un simple glisser-déposer vers la zone périphérique droite ou supérieure du canevas en attendant son calibrage typographique formel.
5. Optimisation visuelle et mise en conformité avec les normes académiques (style APA)
5.1 Épuration visuelle et suppression des éléments redondants
Les chartes graphiques intégrées par défaut dans les logiciels grand public tels qu’Excel sont prioritairement calibrées pour des présentations d’entreprise ou des tableaux de bord administratifs. Elles abondent en fioritures chromatiques, dégradés d’arrière-plan, ombres portées et grilles denses qui contreviennent frontalement aux règles de publication des périodiques scientifiques à comité de lecture. Le principe directeur régissant l’optimisation visuelle scientifique est celui de la maximisation du ratio « encre-données » (data-ink ratio), concept forgé par le théoricien de l’information Edward Tufte, qui prescrit l’éradication sans concession de tout élément graphique qui ne véhicule pas une information quantitative indispensable.
La première intervention consiste à supprimer le quadrillage horizontal majeur. Cliquez directement sur l’une des lignes grisâtres transversales traversant la zone de traçage et appuyez sur la touche Suppr de votre clavier. L’espace de lecture s’en trouve instantanément aéré, permettant aux trajectoires des segments d’interaction de s’exprimer sans interférence optique. De même, sélectionnez la zone de graphique globale, accédez au panneau Format de la forme, et assignez aux paramètres de « Remplissage » et de « Contour » la valeur Aucun remplissage et Aucun trait. La figure doit s’insérer sur un fond blanc pur et transparent, sans encadrement rectangulaire externe superflu.
Une erreur fréquente consiste à conserver le champ textuel « Titre du graphique » intégré par Excel au sommet de l’image. Dans les normes éditoriales académiques (notamment APA 7), une figure ne comporte jamais de titre incrusté à l’intérieur de sa matrice visuelle. Tout graphique est obligatoirement légendé de manière externe, dans le corps du texte du manuscrit, par un numéro formel de figure suivi d’un intitulé descriptif et d’une note de bas de figure. Supprimez par conséquent la zone de texte du titre interne afin de libérer un espace vertical précieux pour l’expansion du tracé géométrique.
5.2 Standardisation typographique et chromatique
La conformité avec les recommandations typographiques de l’APA exige une uniformité stricte des polices de caractères sur l’ensemble du canevas graphique. Sélectionnez globalement le conteneur du graphique et appliquez une police sans empattement hautement lisible, universellement reconnue sur les systèmes d’exploitation, telle qu’Arial, Calibri ou Helvetica, ou une police à empattement canonique telle que Times New Roman si le corps de texte de votre manuscrit l’exige. La taille de la typographie doit être hiérarchisée et constante : privilégiez un corps de 10 ou 11 points pour les étiquettes de catégories et de graduations, et un corps de 11 ou 12 points, idéalement configuré en gras modéré, pour les titres structurels des axes.
Sur le plan chromatique, la règle d’or pour la diffusion scientifique est l’accessibilité universelle et la résilience à l’impression monochrome. Bien que les publications électroniques autorisent désormais l’usage de la couleur, les manuscrits doivent demeurer parfaitement intelligibles s’ils sont reproduits en niveaux de gris ou consultés par des relecteurs atteints de dyschromatopsie (deutéranopie, protanopie). Il est donc vivement recommandé de proscrire les contrastes binaires trompeurs tels que le rouge versus vert. Adoptez une stratégie de contraste mixte articulant la tonalité de gris et la structure géométrique des traits.
Sélectionnez la première série de données (ex. « Sommeil Normal »), accédez au panneau Mettre en forme la série de données, configurez le trait de courbe en couleur noir pur, avec une épaisseur standardisée à 1,5 ou 2 points, et assignez-lui un style de ligne continue. Dans la sous-section Marqueur, choisissez des options de marqueur intégrées : sélectionnez un cercle plein, d’une taille calibrée à 6 ou 7 points, rempli de noir pur avec une bordure noire identique. Pour la seconde série (« Privation Prolongée »), optez pour un trait noir de même épaisseur mais configuré en Trait tireté ou en pointillés longs. Pour son marqueur, appliquez une forme géométrique différente, tel qu’un carré ou un triangle, doté d’un remplissage blanc pur et d’une bordure noire marquée de 1,5 point. Grâce à cette double dissociation (forme et continuité de ligne), vos séries restent discriminables même en photocopie dégradée.
5.3 Formatage précis des axes et des étiquettes
Les axes cartésiens nécessitent un calibrage rigoureux pour matérialiser la délimitation orthogonale du plan expérimental. Par défaut, Excel omet fréquemment d’afficher la ligne physique de l’axe vertical, laissant les valeurs numériques flotter dans le vide. Cliquez sur l’axe vertical (ordonnées), ouvrez le panneau de mise en forme, rendez-vous dans les options de courbe et sélectionnez une Ligne pleine de couleur noire, d’une épaisseur rigoureusement identique à celle des axes catégoriels (typiquement 1 à 1,25 point). Répétez impérativement cette procédure pour l’axe horizontal, assurant une jonction nette à l’origine du repère.
Pour parfaire l’esthétique scientifique de la figure, ajoutez des graduations physiques. Dans les options d’axe, déroulez le menu Graduations et configurez le « Type principal » sur À l’extérieur pour l’axe vertical. Cette commande ajoute de discrets tirets orientés vers l’extérieur du graphique, conférant immédiatement à votre tracé l’aspect formel d’un instrument de métrologie de laboratoire. Évitez d’activer les graduations secondaires, qui surchargeraient inutilement l’espace visuel sans apporter de valeur ajoutée à la lecture des ordres de grandeur.
Enfin, insérez les titres d’axes par le biais de l’icône « + » (Éléments de graphique) située à l’angle supérieur droit du graphique. Le titre de l’axe vertical doit être explicite, concis et comporter impérativement l’unité de mesure entre parenthèses, par exemple : Temps de réaction moyen (ms). Évitez les abréviations cryptiques qui obligent le lecteur à se référer continuellement au corps de l’article. Pour l’axe horizontal, inscrivez le nom générique du facteur expérimental : Niveau de charge mentale. Les deux libellés doivent être orientés avec naturel : le titre de l’axe vertical orienté selon une rotation de 270 degrés (lecture ascendante verticale classique), et le titre horizontal disposé à l’horizontale sous les étiquettes de catégories.
6. Intégration et paramétrage rigoureux des barres d’erreur
6.1 Justification de l’affichage de la variabilité dans les représentations scientifiques
L’omission des indicateurs de dispersion sur un graphique d’interaction constitue l’une des infractions méthodologiques les plus sévèrement sanctionnées lors du processus de révision par les pairs. Présenter des moyennes géométriques ponctuelles sans refléter le degré d’incertitude associé à leur estimation crée l’illusion trompeuse d’un déterminisme parfait des effets observés. Or, la recherche empirique se caractérise par la variabilité stochastique interindividuelle et le bruit de mesure ; la portée substantive de toute différence observée entre deux conditions ne peut être appréciée qu’au regard de la dispersion sous-jacente des distributions d’échantillonnage.
Il importe de clarifier conceptuellement la métrique de dispersion mobilisée, ces indices n’ayant nullement la même signification biologique ou comportementale :
- L’écart-type (SD) : Quantifie l’amplitude de la dispersion des observations individuelles autour de la moyenne de l’échantillon. Il illustre la variabilité naturelle du phénomène mesuré au sein du groupe étudié.
- L’erreur standard de la moyenne (SEM) : Évalue la précision avec laquelle la moyenne d’un échantillon estime la véritable moyenne de la population parente inconnue. C’est l’indice privilégié pour les comparaisons factorielles.
- L’intervalle de confiance à 95 % (IC 95%) : Délimite une zone probabiliste ayant 95 % de chances de contenir le paramètre réel de la population sous l’hypothèse de répétition indéfinie du protocole expérimental. Deux moyennes dont les intervalles de confiance à 95 % se chevauchent largement préfigurent fréquemment une absence de différence statistiquement significative.
Les comités de rédaction des périodiques affiliés à l’APA exigent une transparence sans réserve sur la nature exacte des barres tracées. Tout graphique incorporant des barres d’erreur doit être accompagné d’une mention textuelle univoque stipulant : « Les barres d’erreur représentent ± 1 erreur standard de la moyenne (SEM) » ou « Les barres d’erreur indiquent les intervalles de confiance à 95 % ».
6.2 Procédure d’implémentation des valeurs personnalisées sous Excel
Le paramétrage des barres d’erreur dans Excel recèle un piège critique dans lequel tombent un nombre considérable d’expérimentateurs. Lorsqu’on active les barres d’erreur par le menu standard d’Excel, le logiciel propose des options d’automatisation factices intitulées « Écart-type » ou « Pourcentage ». Ces fonctionnalités natives n’extraient absolument pas la variance réelle de vos cellules expérimentales sous-jacentes ; elles appliquent un calcul algorithmique arbitraire sur l’ensemble de la série globale tracée, générant des barres mathématiquement aberrantes et scientifiquement fausses. Le recours aux Valeurs personnalisées est la seule et unique procédure rigoureuse.
Pour implémenter les véritables valeurs de SEM calculées préalablement dans votre table miroir (Section 3.3), procédez avec une minutie méthodique :
- Cliquez sur le graphique pour sélectionner la première courbe (ex. « Sommeil Normal »).
- Cliquez sur le bouton « + » des éléments de graphique, survolez l’option Barres d’erreur, cliquez sur la petite flèche noire orientée vers la droite, puis sélectionnez impérativement Autres options….
- Dans le volet latéral de mise en forme qui apparaît à droite, assurez-vous que la rubrique « Direction » est fixée sur Les deux, et que le « Style de fin » est réglé sur Avec empattement.
- Descendez au bas du panneau jusqu’à la section « Marge d’erreur », cochez la case à cocher Personnalisée, puis cliquez sur le bouton Spécifier une valeur.
- Une boîte de dialogue surgit, comportant deux champs textuels : « Valeur d’erreur positive » et « Valeur d’erreur négative ».
- Effacez scrupuleusement le contenu textuel par défaut (qui contient généralement
={1}) dans le champ de l’erreur positive. En laissant votre curseur dans ce champ, sélectionnez à la souris la plage de cellules horizontales ou verticales correspondant aux SEM de cette première série au sein de votre table miroir (par exempleE2:F2). - Répétez la même manœuvre d’effacement complet pour le champ de l’erreur négative, puis sélectionnez exactement la même plage de cellules (
E2:F2) afin que les barres s’étendent de manière parfaitement symétrique au-dessus et en dessous de chaque point moyen. - Validez en cliquant sur OK.
Répétez sans altération cette séquence intégrale pour la seconde courbe (« Privation Prolongée ») en prenant un soin extrême à cibler la plage de SEM correspondante (par exemple E3:F3). Toute inversion de plage conduirait à attribuer la variabilité d’une condition expérimentale à une autre, compromettant gravement l’exactitude scientifique de votre publication.
6.3 Ajustement visuel et mise en forme des terminaisons
Après l’injection des valeurs quantitatives personnalisées, les barres d’erreur requièrent une standardisation de leur morphologie visuelle afin de s’intégrer harmonieusement à l’esthétique globale de la figure. Par défaut, Excel trace parfois des segments excessivement pâles ou disproportionnellement épais qui viennent cannibaliser la lisibilité des marqueurs centraux.
Sélectionnez les barres d’erreur qui viennent d’être créées sur le tracé. Dans le panneau de formatage, accédez à l’onglet de remplissage et de contour. Affectez à la ligne de la barre une couleur noire pure et standardisez son épaisseur à une valeur comprise entre 1 point et 1,25 point. Cette épaisseur doit être subtilement inférieure ou égale à celle de la ligne de liaison de la série pour garantir une hiérarchie visuelle fluide, où le marqueur moyen demeure l’élément focal primaire et la barre d’erreur l’indicateur d’incertitude secondaire.
L’empattement horizontal (la petite barre transversale bornant l’extrémité du segment vertical) remplit une fonction sémiotique déterminante : il délimite l’empan extrême de l’intervalle de variabilité calculé. Assurez-vous que cet empattement est parfaitement horizontal et d’une largeur constante d’une série à l’autre. Si Excel a généré par mégarde des barres d’erreur horizontales (parasitisme fréquent lorsqu’on manipule des tracés en lignes ou des nuages de points), cliquez directement sur ces segments d’erreur horizontaux horizontaux et supprimez-les d’une simple pression sur la touche Suppr pour ne conserver strictement que les vecteurs verticaux de dispersion.
7. Typologie et analyse visuelle approfondie des formes d’interaction
7.1 Interaction nulle et parallélisme strict des trajectoires
D’un point de vue géométrique et structural, l’absence formelle d’effet d’interaction se traduit sur le graphique par des trajectoires de pentes parfaitement parallèles ou quasi-parallèles. Si l’on calcule le coefficient directeur du segment reliant la condition de charge faible à la condition de charge élevée pour le groupe en sommeil normal, celui-ci s’avère rigoureusement équivalent au coefficient directeur calculé pour la cohorte en privation de sommeil. L’écart vertical séparant les deux courbes demeure constant sur l’ensemble du domaine d’observation horizontal.
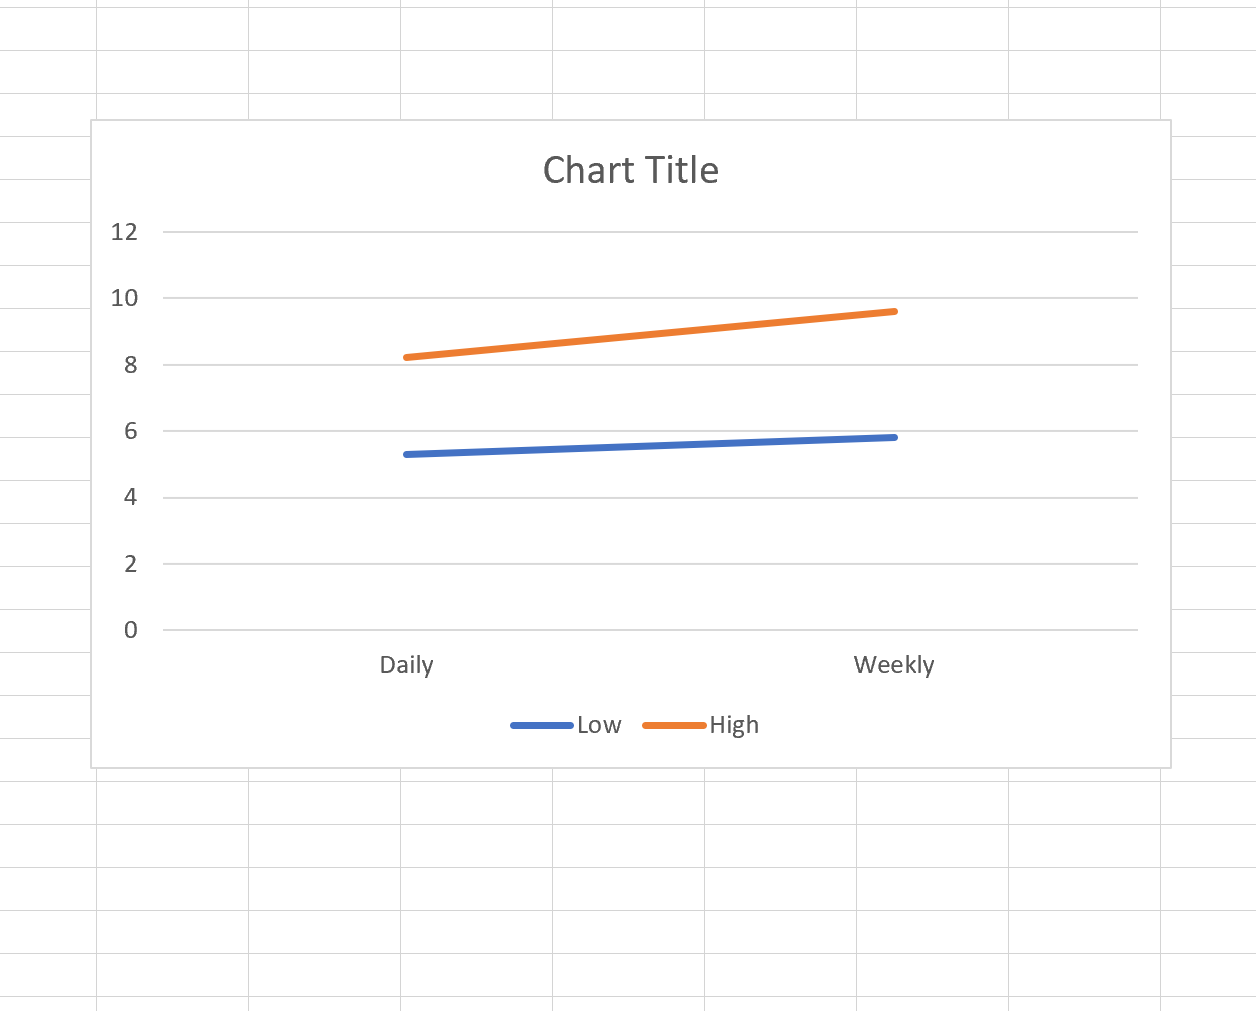
Sur le plan conceptuel, un tel parallélisme indique une totale indépendance opérationnelle des deux facteurs expérimentaux. L’impact de la charge mentale sur le temps de réaction cognitive est immuable, quel que soit l’état de fatigue biologique du participant. Réciproquement, la privation de sommeil induit un ralentissement des performances d’une magnitude identique, que la tâche exécutée soit élémentaire ou d’une complexité extrême. Le système comportemental se conforme ici au principe d’additivité linéaire pure.
Dans cette configuration géométrique, le chercheur dispose d’une autorisation théorique totale pour interpréter les effets principaux de manière directe, autonome et inconditionnelle. On peut affirmer avec une certitude scientifique absolue que « la charge mentale élevée détériore les performances d’une durée moyenne de X millisecondes » et que « la privation de sommeil produit une pénalité temporelle fixe de Y millisecondes ». La communication des résultats s’en trouve grandement simplifiée, les deux mécanismes psychologiques sous-jacents agissant de façon additive sur les chaînes de traitement de l’information.
7.2 Interaction ordinale (non croisée)
L’interaction dite ordinale (ou non croisée) se manifeste sur le plan visuel par des segments de droite qui divergent ou convergent de façon substantielle mais qui ne se coupent à aucun endroit dans la fenêtre spatiale de l’expérimentation. Les pentes possèdent des inclinaisons dissemblables — l’une étant typiquement plus accentuée que l’autre —, mais l’ordre hiérarchique des conditions reste scrupuleusement invariant. La courbe représentant la privation de sommeil demeure systématiquement située au-dessus de la courbe représentant le sommeil normal sur l’intégralité du continuum de l’axe des abscisses.
Cette configuration reflète une variation d’amplitude de l’effet d’une variable sous la dépendance de l’autre, sans que la directionnalité fondamentale du phénomène ne soit remise en cause. Dans notre paradigme empirique (tel qu’illustré par nos données de synthèse où le temps de réaction grimpe de 70 ms en état normal, contre un bond spectaculaire de 220 ms sous privation de sommeil), la privation de sommeil exacerbe dramatiquement la sensibilité du sujet à la charge mentale. L’effet de surcharge s’exprime dans les deux états physiologiques, mais son intensité est multipliée par un facteur supérieur à trois lorsque les réserves homéostatiques sont épuisées.
L’interprétation des effets principaux en présence d’une interaction ordinale réclame de grandes précautions de langage. Si l’on peut généralement maintenir l’affirmation globale selon laquelle la privation de sommeil et la charge mentale détériorent toutes deux les temps de réaction, il est méthodologiquement impératif de stipuler immédiatement que l’amplitude de cette dégradation n’est pas homogène. Toute quantification globale non conditionnelle dissimulerait l’essence même de la découverte scientifique : le caractère synergique ou fragilisant de la combinaison des deux stresseurs.
7.3 Interaction disjonctive ou croisée (crossover interaction)
L’interaction disjonctive, fréquemment qualifiée d’interaction croisée ou de crossover interaction, constitue la forme la plus radicale et théoriquement la plus fascinante de modération expérimentale. Elle se caractérise graphiquement par une intersection nette et spectaculaire des segments de droite à l’intérieur de l’espace de traçage. Les deux courbes forment un « X » plus ou moins asymétrique, témoignant d’une inversion symétrique complète de la hiérarchie des performances entre les conditions.
Considérons à titre d’illustration une inversion théorique où des stimuli visuels familiers seraient traités plus rapidement que des stimuli nouveaux dans un état de vigilance standard, alors que sous privation extrême de sommeil, un réflexe d’orientation inversé conduirait paradoxalement les stimuli nouveaux à capter prioritairement l’attention résiduelle, surpassant les stimuli familiers. Dans une telle conjoncture, la direction même de l’impact de la variable indépendante dépendante bascule d’un pôle à l’autre selon l’état de la variable modératrice.
Les conséquences mathématiques d’une interaction croisée sur les calculs d’ANOVA sont souvent spectaculaires et constituent un piège classique pour les analystes débutants : elle a pour propriété intrinsèque d’annihiler potentiellement les effets principaux marginaux. En calculant les moyennes globales marginales à travers les colonnes et les lignes, les effets opposés s’annulent mutuellement sur le plan arithmétique, aboutissant à des valeurs de F proches de zéro pour les effets principaux, alors même que l’effet d’interaction global atteint une significativité statistique écrasante (p < 0,001). C’est précisément l’inspection du graphique d’interaction qui prémunit le chercheur contre la conclusion catastrophique et erronée d’une prétendue « absence d’effet des facteurs », en révélant que le phénomène repose exclusivement sur une inversion conditionnelle des mécanismes opératoires.
8. Articulation entre le graphique d’interaction et l’analyse de variance (ANOVA)
8.1 Exécution de l’ANOVA factorielle avec l’Utilitaire d’analyse d’Excel
L’exploration visuelle d’un graphique d’interaction ne saurait en aucun cas se substituer à la validation inférentielle formelle. Deux courbes qui semblent diverger à l’œil nu peuvent parfaitement refléter de simples fluctuations aléatoires imputables à l’erreur d’échantillonnage. Il est donc indispensable d’adosser systématiquement la figure au calcul de l’analyse de variance (ANOVA) à deux facteurs avec répétition. Bien qu’Excel ne soit pas un logiciel dédié à la biostatistique lourde, il intègre un composant natif capable d’exécuter cette procédure avec une rigueur mathématique irréprochable : l’Utilitaire d’analyse.
Si ce complément n’est pas visible dans votre onglet Données, activez-le en vous rendant dans le menu Fichier > Options > Compléments, sélectionnez « Compléments Excel » dans le menu déroulant inférieur, cliquez sur Atteindre…, cochez la case Utilitaire d’analyse et validez. Dès son activation, le bouton « Utilitaire d’analyse » apparaît à l’extrémité droite du ruban Données.
Pour lancer la procédure factorielle, la matrice des données doit être organisée selon un canevas matriciel strict exigé par Excel :
- Disposez les colonnes en fonction des modalités du premier facteur (ex. Colonne B : Sommeil Normal ; Colonne C : Privation de Sommeil).
- Disposez en lignes les modalités du second facteur, chaque condition comportant un bloc d’un nombre rigoureusement identique de lignes d’enregistrements (plan factoriel équilibré). Par exemple, les lignes 2 à 11 pour « Faible » (10 sujets), et les lignes 12 à 21 pour « Élevée » (10 sujets).
- Cliquez sur Utilitaire d’analyse, sélectionnez ANOVA : Deux facteurs avec répétition, et validez par OK.
- Dans la plage d’entrée, sélectionnez la matrice intégrale incluant les en-têtes (
A1:C21). - Dans le champ « Lignes par échantillon », renseignez le nombre exact de participants par cellule (ici
10). - Fixez le seuil alpha standard à
0,05et choisissez une plage de sortie pour générer le tableau statistique.
8.2 Rapprochement des valeurs statistiques F et du comportement visuel des pentes
La sortie computationnelle générée par l’Utilitaire d’analyse d’Excel comprend une section descriptive suivie d’une table d’ANOVA conventionnelle partitionnant la somme des carrés (SS), les degrés de liberté (df), les carrés moyens (MS), la valeur du ratio de variance F de Fisher-Snedecor, ainsi que la valeur critique de p (probabilité critique). Pour examiner la viabilité de votre graphique d’interaction, focalisez immédiatement votre attention sur la ligne intitulée Interaction (ou parfois « Échantillon x Colonnes » selon les traductions linguistiques des versions d’Excel).
Le rapprochement entre les métriques de cette ligne et la configuration spatiale des courbes est direct et contraignant :
- Si la probabilité critique associée à la ligne d’interaction est supérieure au seuil nominal (p > 0,05), l’hypothèse nulle d’indépendance ne peut être rejetée. Sur le plan visuel, même si les courbes accusent une légère non-parallélité apparente, celle-ci doit être formellement considérée comme un artefact de variance résiduelle non significatif. Le chercheur doit s’abstenir de surinterpréter la divergence des pentes.
- Si la valeur p est inférieure au seuil critique (p < 0,05 ou p < 0,001), l’interaction est déclarée statistiquement significative. La non-parallélité observée sur votre tracé reflète une réalité expérimentale robuste : la modulation de l’effet d’une variable par l’autre est empiriquement validée, légitimant pleinement le commentaire analytique approfondi de la figure géométrique.
8.3 Mesure de la taille d’effet associée à l’interaction
L’évaluation scientifique moderne des résultats quantitatifs transcende la simple dichotomie binaire significatif/non-significatif imposée par le test de l’hypothèse nulle. La signification statistique d’une valeur p dépend lourdement de la taille de l’échantillon testé : un effectif pléthorique peut rendre significative une interaction géométriquement infinitésimale et dénuée de pertinence pratique. Inversement, une cohorte restreinte peut échouer à faire émerger une divergence pourtant massive. Les directives éditoriales actuelles exigent en conséquence la quantification systématique de la force du phénomène au moyen d’un indicateur de taille d’effet.
Dans le cadre de l’ANOVA factorielle, l’indicateur le plus universellement rapporté dans la littérature scientifique est l’êta-carré partiel (ηp2). Cet indice évalue la proportion de la variance totale attribuable au terme d’interaction spécifique, après avoir mathématiquement exclu la variance captée par les autres effets systématiques du modèle. Bien qu’Excel n’affiche pas directement cette métrique dans sa table automatisée, son calcul s’exécute aisément à la main dans une cellule adjacente à partir des données de la somme des carrés (SS) :
ηp2 = SS(Interaction) / (SS(Interaction) + SS(Résiduelle))
Selon les conventions canoniques formulées par le statisticien Jacob Cohen, un ηp2 de 0,01 signale un effet de faible amplitude, un score de 0,06 reflète une taille d’effet moyenne, tandis qu’une valeur franchissant le seuil de 0,14 traduit une interaction majeure, captant une fraction substantielle de la variabilité cognitive du comportement exploré. Ce paramètre quantitatif doit être systématiquement inclus dans le texte descriptif accompagnant votre figure d’interaction.
9. Décomposition post-hoc : L’analyse des effets simples dans Excel
9.1 Nécessité méthodologique de l’analyse des effets simples
L’obtention d’une interaction factorielle significative au test F de l’ANOVA indique formellement que « quelque part dans le devis », les pentes diffèrent significativement de zéro ou l’une de l’autre. Cependant, ce test omnibus est par essence non directionnel : il ne permet pas de statuer avec certitude sur la localisation exacte des dissociations cellulaires critiques. Peut-on soutenir que l’effet de la charge mentale est statistiquement perceptible lorsque les sujets bénéficient d’un sommeil préservé ? L’écart observé en condition de charge faible entre sujets reposés et fatigués franchit-il le seuil de l’erreur fortuite ?
Pour répondre à ces interrogations ciblées, l’expérimentateur a l’obligation épistémologique de procéder à la décomposition de l’interaction globale en une série d’effets simples (simple effects analysis). L’analyse d’un effet simple consiste à isoler artificiellement l’impact d’un facteur A en maintenant le facteur B constant à une modalité fixée unique, puis à réitérer l’opération à la modalité alternative. On décompose ainsi un problème multidimensionnel complexe en une suite logique de comparaisons univariées directes guidées par l’inspection visuelle du graphique.
9.2 Calcul des tests t de Student pour les comparaisons directes
Sous Excel, l’estimation des effets simples peut être menée avec rigueur par le biais de la fonction TEST.ETUDIANT, qui exécute directement un test t à deux échantillons comparant les distributions individuelles associées aux points tracés sur la figure. La syntaxe générique de cette fonction est :
=TEST.ETUDIANT(matrice1; matrice2; unilatéral/bilatéral; type)
Pour illustrer la décomposition de notre modèle de vigilance :
- Effet simple de la Charge sous Sommeil Normal : Comparez la plage des 10 observations de la condition (Faible / Normal) avec la plage des 10 observations de (Élevée / Normal). Configurez le test sur
bilatéral (2)et choisissez le paramètre detype (3)correspondant à des variances hétérogènes (test de Welch), à moins que l’homoscédasticité n’ait été formellement validée par un test de Levene. La formule renvoie directement la probabilité critique exacte p. - Effet simple de la Charge sous Privation de Sommeil : Comparez la plage des 10 enregistrements de (Faible / Privation) avec la plage des 10 enregistrements de (Élevée / Privation), selon les mêmes réglages.
Cette approche permet d’objectiver numériquement ce que l’œil perçoit sur le graphique : on démontre souvent qu’un segment qui semble visuellement plus plat correspond à un effet simple statistiquement non significatif (ex. p = 0,12), alors que le segment divergeant très redressé génère un effet simple hautement significatif (ex. p < 0,001), validant définitivement la théorie d’une vulnérabilité cognitive sélective.
9.3 Application des ajustements pour comparaisons multiples
La multiplication de contrastes statistiques univariés sur un même jeu de données expérimentales induit une dérive mathématique insidieuse : l’inflation de l’erreur globale de première espèce (l’erreur alpha par famille de tests). En formulant quatre ou six tests t post-hoc sur une matrice 2×2, la probabilité cumulée de déclarer à tort au moins une différence significative alors qu’elle ne résulte que du hasard excède substantiellement le seuil nominal standard de 5 %.
Pour neutraliser ce risque et garantir l’intégrité déontologique de la recherche, il est impératif d’assortir les tests post-hoc menés sous Excel d’un ajustement de protection. Le protocole le plus accessible et le plus classique est la correction de Bonferroni. Elle consiste à diviser le seuil de significativité nominal initial (α = 0,05) par le nombre total k de comparaisons prévues a priori (par exemple 4 comparaisons simples) :
αajusté = α / k = 0,05 / 4 = 0,0125
Dès lors, un effet simple ne sera considéré comme empiriquement fondé que si la valeur calculée par la fonction TEST.ETUDIANT est strictement inférieure à ce nouveau seuil pénalisé de 0,0125. Une fois ces significativités scellées, le chercheur peut enrichir le graphique d’interaction d’annotations graphiques explicites, telles que de discrètes accolades surplombant les segments critiques accompagnées d’astérisques conventionnels (* p < 0,05 ; ** p < 0,01 ; *** p < 0,001), offrant au lecteur une synthèse visuelle instantanée des contrastes victorieux.
10. Pièges fréquents, erreurs de construction et biais d’interprétation
10.1 Distorsion d’échelle et manipulation involontaire de l’axe vertical
L’écueil ergonomique le plus destructeur dans l’élaboration d’un graphique d’interaction réside dans la manipulation non réfléchie de l’empan de l’axe vertical Y. Les mécanismes d’auto-calibrage d’Excel ont une fâcheuse propension à caler le minimum de l’axe sur une valeur immédiatement inférieure à la moyenne la plus basse observée. Si cette pratique accentue les contrastes internes d’un jeu de données resserré, elle introduit une distorsion optique majeure en magnifiant artificiellement l’amplitude des pentes et en donnant à une interaction marginale l’apparence visuelle d’un bouleversement fonctionnel dramatique.
La décision méthodologique d’ancrer ou non l’axe vertical au zéro absolu doit être guidée par la nature métrologique de la variable dépendante :
- Pour des variables possédant un zéro naturel signifiant (telles que des pourcentages d’erreurs, des comptes d’occurrences ou des fréquences de réponses comportementales), l’inclusion du point d’origine zéro est une exigence déontologique forte pour préserver l’intégrité de la perception des proportions.
- Pour des variables continues sans zéro opératoire direct (telles que des scores d’échelles de Likert standardisées de 1 à 7, des temps de réaction chronométriques ou des amplitudes d’ondes électroencéphalographiques), démarrer systématiquement l’axe à zéro écraserait la totalité des courbes au sommet du graphique, rendant la détection des trajectoires d’interaction totalement inopérante. Dans cette situation, un fenêtrage resserré est scientifiquement légitime, à la condition expresse que les bornes de l’axe soient clairement explicitées, proportionnées à la variabilité empirique réelle, et ne cherchent pas à déformer l’effet réel.
Un facteur tout aussi déterminant concerne le ratio d’aspect (aspect ratio), c’est-à-dire le rapport entre la hauteur et la largeur géométrique de la boîte englobante du graphique. Un graphique étiré de façon disproportionnée sur le plan vertical confère à la moindre déviation de parallélisme l’allure d’une pente abrupte, tandis qu’un graphique aplati horizontalement masque les interactions ordinales les plus robustes. Les recommandations ergonomiques préconisent le maintien d’un ratio canonique d’environ 3:4 ou 4:5 pour stabiliser la perception des inclinaisons relatives.
10.2 Confusion entre significativité visuelle et robustesse statistique
L’esprit humain est naturellement doté d’une tendance cognitive à rechercher et imposer des patterns signifiants au sein du champ visuel, un biais particulièrement prégnant lors de l’inspection de graphiques scientifiques. Devant deux segments de droite présentant une non-parallélité manifeste, l’intuition perceptive conclut quasi instinctivement à l’existence d’une interaction majeure. Cette déduction immédiate est pourtant l’une des sources les plus prolifiques de fausses découvertes scientifiques.
Il est fondamental de rappeler qu’un échantillonnage aléatoire extrait d’une population où l’effet d’interaction est strictement nul ne produira pour ainsi dire jamais des moyennes d’échantillon parfaitement alignées sur un parallélisme absolu. En raison de la variance d’échantillonnage inhérente à la mesure du vivant, de légères fluctuations de moyennes cellulaires sont inéluctables. Seule la confrontation de la divergence des pentes à la variance résiduelle intra-groupe (l’erreur quadratique moyenne au dénominateur du ratio F) permet de statuer sur la légitimité du phénomène.
La règle d’or épistémologique doit être scrupuleusement observée : l’affirmation visuelle doit être rigoureusement subordonnée au test statistique. Si le terme d’interaction de l’ANOVA n’atteint pas le seuil de probabilité critique α défini a priori, le chercheur a le devoir déontologique de décrire les pentes comme étant fonctionnellement parallèles, en rejetant l’illusion optique issue du tracé. L’intégration scrupuleuse des barres d’erreur (SEM) joue à cet égard un rôle prophylactique capital : des barres d’erreur volumineuses qui se chevauchent verticalement de part et d’autre des points moyens constituent un puissant signal d’alerte visuel rappelant l’instabilité de l’estimation observée.
10.3 Erreurs de traitement des variables continues versus catégorielles
Dans de nombreuses disciplines quantitatives, les facteurs indépendants investigués ne sont pas des entités naturellement catégorielles (comme le genre biologique ou un protocole de traitement pharmacologique actif versus placebo), mais des dimensions intrinsèquement continues (telles que le quotient intellectuel, le niveau d’anxiété-trait mesuré par inventaire psychométrique, ou l’âge chronologique des participants). Une pratique méthodologique historiquement répandue mais aujourd’hui sévèrement condamnée consiste à discrétiser artificiellement ces variables continues au moyen d’une dichotomisation par la médiane (median split) afin de forcer les données à entrer dans le carcan d’un devis factoriel 2×2 traçable sous forme de graphique en lignes classique.
Cette discrétisation arbitraire entraîne des conséquences désastreuses amplement documentées par la littérature méthodologique contemporaine. Elle provoque une perte drastique de puissance statistique (équivalant fréquemment à sacrifier un tiers de l’échantillon collecté), altère artificiellement les distributions sous-jacentes, et engendre un risque dramatique de générer des artefacts d’interaction fictifs (faux positifs) ou d’étouffer des relations non linéaires authentiques. Traiter un individu situé juste au-dessus du seuil médian comme étant qualitativement identique à un individu occupant le décile extrême relève de l’aberration psychométrique.
Face à des variables continues, la démarche légitime consiste à mobiliser une régression linéaire multiple incorporant le terme de produit continu centré, ou une régression modérée formalisée par la macro PROCESS d’Andrew Hayes. Dans ce contexte analytique, le tracé du graphique d’interaction ne relie pas des moyennes empiriques brutes, mais illustre les droites de régression conditionnelles calculées à des valeurs cibles conventionnelles du modérateur (généralement la moyenne ± 1 écart-type), complétées idéalement par l’identification des points d’inflexion via la technique de Johnson-Neyman. Excel demeure parfaitement capable de tracer ces droites modélisées à condition d’implémenter les équations de régression dans les cellules sources.
11. Techniques avancées : Automatisation et dynamisation sous Excel
11.1 Utilisation des tableaux structurés et des plages dynamiques
Pour pérenniser vos outils de calcul et transformer un classeur ponctuel en un canevas d’analyse réutilisable pour de futurs protocoles, il est particulièrement avantageux de substituer aux plages de cellules standard des Tableaux structurés Excel. Sélectionnez votre matrice de données brutes et utilisez le raccourci clavier Ctrl + L (ou Ctrl + T selon l’environnement régional) pour convertir la zone en tableau dynamique formel.
L’immense valeur ajoutée de cette structure réside dans l’auto-expansion dynamique des références. Lorsque vous assignez des noms explicites aux colonnes de données (par exemple TblDonnees[TempsReaction]), les formules d’agrégation de votre table récapitulatrice de moyennes exploitent ces références textuelles structurées plutôt que des adresses rigides de type D2:D50. Si vous intégrez ultérieurement dix nouveaux participants à votre cohorte d’expérimentation, le tableau absorbe automatiquement ces entrées supplémentaires, les moyennes de cellules se recalculent en temps réel, et la géométrie des segments de votre graphique d’interaction se réajuste instantanément sans la moindre réintervention sur les plages de traçage.
Pour les utilisateurs chevronnés évoluant sur des versions d’Excel antérieures à l’introduction des tableaux structurés, le même degré d’automatisation dynamique s’obtient par la définition de Noms de plages exploitant la combinaison des fonctions DECALER et NBVAL dans le Gestionnaire de noms. Cette formulation avancée recalcule la hauteur des vecteurs de données à chaque exécution, garantissant que les figures générées restent en syntonie absolue avec les flux de collecte de données vivantes du laboratoire.
11.2 Intégration de contrôles de formulaire pour l’exploration interactive
L’exploration visuelle d’un espace de données multivarié gagne considérablement en fluidité lorsque le chercheur ou l’enseignant peut manipuler dynamiquement les perspectives d’affichage sans reconstruire manuellement les tables sources. Grâce à l’onglet Développeur d’Excel (activable via les options de personnalisation du ruban), il est possible d’insérer des composants d’interface ergonomiques tels que des boutons d’options ou des listes déroulantes de contrôle de formulaire directement au-dessus du graphique.
En associant un composant de case d’option à une cellule de contrôle booléenne (valeur 1 ou 2), vous pouvez piloter une fonction conditionnelle INDEX ou CHOISIR dans votre table récapitulative. D’un simple clic sur le bouton d’option intitulé « Inverser les facteurs », la table de tracé commute instantanément l’attribution de l’axe des abscisses et des séries de courbes. Le graphique d’interaction se métamorphose sous vos yeux, permettant d’évaluer en temps réel si l’interaction apparaît plus intelligible lorsque le Facteur A est en abscisse ou lorsqu’il est projeté en séries multiples.
Cette approche dynamique présente une vertu pédagogique exceptionnelle pour les séminaires universitaires et les réunions d’équipes de recherche. Elle permet d’examiner collectivement les données sous tous leurs angles sémiotiques, facilitant le consensus méthodologique quant à la figure factorielle définitive qui méritera d’être soumise à l’évaluation éditoriale.
11.3 Automatisation via des macros VBA simples
L’implémentation répétée des protocoles de mise en forme scientifique décrits dans la Section 5 (suppression des grilles, réassignation des polices, injection personnalisée des barres d’erreur) peut s’avérer chronophage lorsqu’un programme de recherche comporte une multiplicité d’épreuves factorielles à cartographier. Le recours au langage de programmation Visual Basic for Applications (VBA) natif d’Excel offre une solution élégante pour automatiser l’intégralité de ces opérations typographiques en une fraction de seconde.
En ouvrant l’éditeur Visual Basic (raccourci Alt + F11) et en insérant un module standard, vous pouvez consigner un script procédural calibré pour normaliser instantanément le graphique sélectionné. À titre d’exemple canonique, le listing suivant illustre l’épuration automatique d’un tracé :
Sub NormaliserGraphiqueAPA()
    Dim monGraph As Chart
    On Error Resume Next
    Set monGraph = ActiveChart
    If monGraph Is Nothing Then
        MsgBox "Veuillez sélectionner un graphique préalable.", vbExclamation
        Exit Sub
    End If

    With monGraph
        .HasTitle = False
        .HasAxis(xlValue, xlPrimary) = True
        .HasAxis(xlCategory, xlPrimary) = True
        .Axes(xlValue).HasMajorGridlines = False
        .ChartArea.Format.Line.Visible = msoFalse
        .ChartArea.Format.Fill.Visible = msoFalse
        .PlotArea.Format.Line.Visible = msoFalse
        .PlotArea.Format.Fill.Visible = msoFalse
        .ChartArea.Font.Name = "Calibri"
        .ChartArea.Font.Size = 10
        .Axes(xlCategory).Format.Line.ForeColor.RGB = RGB(0, 0, 0)
        .Axes(xlValue).Format.Line.ForeColor.RGB = RGB(0, 0, 0)
        .Axes(xlValue).MajorTickMark = xlTickMarkOutside
    End With
End Sub
En assignant ce script à un bouton de raccourci positionné dans votre barre d’outils d’accès rapide, vous standardisez l’ensemble de votre production iconographique en garantissant une identité stylistique homogène et professionnelle à l’ensemble des figures factorielles de votre laboratoire.
12. Exportation haute résolution et rédaction de la légende académique
12.1 Exportation vectorielle et matricielle de haute précision
La finalisation technique de votre figure ne s’arrête pas à sa confection à l’écran : elle englobe impérativement la chaîne de restitution graphique jusqu’à l’impression finale. L’un des écueils les plus désastreux consiste à effectuer une copie d’écran matricielle basique (via l’outil Capture de Windows ou une commande équivalente) pour coller l’image dans un logiciel de traitement de texte. Cette méthode capture la figure à la résolution intrinsèque de l’écran (typiquement 72 ou 96 DPI), générant lors de l’impression sur papier glacé ou de l’agrandissement en consultation PDF un flou de pixellisation hautement préjudiciable pour la crédibilité du travail.
Les maisons d’édition scientifiques internationales (Elsevier, Springer, Wiley, APA Press) exigent formellement que les figures soient soumises sous forme de fichiers autonomes à une résolution minimale de 300 DPI pour les photographies en demi-teintes, et de 600 à 1200 DPI pour les dessins au trait et tracés linéaires (ce qui correspond précisément à la typologie des graphiques d’interaction). Deux voies opératoires permettent d’atteindre ce standard sous Excel :
- L’exportation vectorielle native : Copiez le graphique sous Excel (
Ctrl + C). Dans votre document de rédaction Microsoft Word, utilisez l’option Collage spécial > Image (métafichier amélioré) ou Graphique Microsoft Office lié. Le format EMF (Enhanced Metafile) préserve la nature vectorielle intégrale des segments, des marqueurs et des typographies, autorisant un agrandissement infini sans la moindre perte de netteté. - La conversion matricielle haute définition via PDF : Isoler le graphique sur une feuille de calcul dédiée vierge, ajustez la mise en page sans marges, et exécutez la commande Fichier > Exporter > Créer un document PDF/XPS en sélectionnant la qualité standard d’impression commerciale. Le fichier PDF vectoriel généré peut ensuite être converti sous un logiciel d’imagerie scientifique (tel que GIMP, Inkscape ou Adobe Photoshop) en format TIFF non compressé (avec compression LZW) calibré à 600 DPI réels.
12.2 Rédaction scientifique d’une note de figure conforme aux standards de publication
Selon les canons rédactionnels de l’APA (7e édition), une figure scientifique ne s’appréhende jamais de façon isolée ; elle forme avec sa légende un ensemble sémantique autonome qui doit être compréhensible par tout lecteur instruit sans qu’il soit nécessaire d’aller fouiller le texte principal de l’article. La formalisation de la légende se déploie selon une architecture codifiée en trois segments obligatoires :
Figure 1
Temps de réaction en fonction du niveau de charge mentale et de l’état de privation de sommeil
La légende textuelle descriptive doit être positionnée directement sous l’illustration, initiée par l’italique canonique Note., et structurée de la façon suivante :
Note. Les temps de réaction sont mesurés en millisecondes lors de l’exécution d’une tâche de vigilance attentionnelle psychomotrice (PVT). La ligne continue noire et les marqueurs circulaires pleins représentent le groupe en état de Vigilance normale (n = 10) ; la ligne pointillée noire et les marqueurs carrés vides représentent le groupe soumis à 24 heures de Privation prolongée de sommeil (n = 10). Les barres d’erreur verticales figurent ± 1 erreur standard de la moyenne (SEM). L’interaction factorielle globale 2×2 est statistiquement significative, F(1, 18) = 14,32, p = 0,001, ηp2 = 0,44. Les astérisques désignent les différences simples significatives issues de contrastes post-hoc corrigés par la méthode de Bonferroni (** p < 0,01 ; *** p < 0,001).
Cette exhaustivité documentaire permet à tout évaluateur ou méta-analyste de reconstruire la structure exacte des degrés de liberté, d’appréhender la métrique d’incertitude affichée et de vérifier la cohérence interne globale du modèle empirique.
12.3 Bonnes pratiques de reproductibilité et de gestion des données ouvertes
La crise contemporaine de la reproductibilité qui traverse les sciences empiriques impose aux chercheurs une transparence méthodologique absolue dans la gestion et le partage de leurs artéfacts numériques. L’époque où le tableur d’analyse demeurait enfoui sur le disque dur personnel d’un expérimentateur est révolue. Pour s’inscrire dans le mouvement vertueux de la Science Ouverte (Open Science), le classeur Excel ayant servi à la conception de la figure d’interaction doit être documenté avec un soin d’archivage rigoureux en vue de son dépôt public.
Adoptez une structure de classeur rationnelle scindée en plusieurs onglets thématiques clairement libellés :
- Un onglet
READMEconsignant le dictionnaire des variables, les unités de mesure physiques, la date d’extraction et les coordonnées de l’auteur référent. - Un onglet
Donnees_Brutescontenant l’enregistrement source brut sans la moindre formule destructrice, protégé en écriture. - Un onglet
Calculs_Analysesexposant ouvertement les tableaux de moyennes, les variances, les SEM et les tables d’ANOVA générées par l’Utilitaire d’analyse. - Un onglet
Figures_Finaleshébergeant l’objet graphique calibré aux normes éditoriales.
En déposant ce classeur auditable et ouvert sur des plateformes institutionnelles pérennes certifiées telles que l’Open Science Framework (OSF) ou Zenodo, assorti d’un identifiant numérique d’objet persistant (DOI), vous assurez à vos recherches une reproductibilité computationnelle intégrale, attestant de votre adhésion aux standards éthiques et scientifiques les plus exigeants de la communauté internationale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.utstat.toronto.edu/~brunner/oldclass/378f16/readings/CohenPower.pdf
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Hayes, A. F. (2018). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (2nd ed.). Guilford Press. https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030
- Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall. https://www.pearson.com/en-us/subject-catalog/p/design-and-analysis-a-researchers-handbook/P200000003507
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Microsoft Support. (2023). Ajouter, modifier ou supprimer des barres d’erreur dans un graphique. Support Microsoft. https://support.microsoft.com/fr-fr/office/ajouter-modifier-ou-supprimer-des-barres-d-erreur-dans-un-graphique-e6d12c87-8533-4cd6-aa70-e40da6709668
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press. https://www.edwardtufte.com/tufte/books_vdqi
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0