
Dans l’arsenal méthodologique de la recherche contemporaine en sciences humaines, sociales et biomédicales, l’analyse de variance (ANOVA) s’impose comme l’un des piliers fondamentaux du raisonnement inférentiel. Développée originellement par Sir Ronald A. Fisher au début du XXe siècle, cette approche statistique a profondément transformé la manière dont les chercheurs évaluent l’impact de variables indépendantes catégorielles sur des variables dépendantes quantitatives continues. Qu’il s’agisse d’évaluer l’efficacité différentielle de protocoles psychothérapeutiques, de mesurer les variations de potentiels évoqués en neurosciences cognitives ou d’analyser l’impact de contextes pédagogiques sur la mémorisation, l’ANOVA fournit un cadre formel et robuste pour déterminer si les divergences observées entre plusieurs moyennes relèvent de véritables effets expérimentaux ou de simples fluctuations d’échantillonnage aléatoires.
Cependant, l’application concrète de l’analyse de variance confronte invariablement le chercheur à un arbitrage architectural décisif : celui du choix entre un plan à groupes indépendants (conduisant à l’ANOVA à un facteur inter-sujets) et un plan à mesures répétées (relevant de l’ANOVA intra-sujets). Bien que ces deux méthodologies partagent une vocation commune — à savoir partitionner la variance globale des données pour tester l’hypothèse nulle d’égalité des moyennes —, elles reposent sur des topologies matricielles, des postulats mathématiques et des modélisations de l’erreur résiduelle radicalement divergents. Confondre ces deux paradigmes analytiques ne constitue pas une simple imprécision technique : une telle méprise compromet gravement la validité interne et externe des conclusions, soit en gonflant dramatiquement le risque d’erreur de première espèce (α), soit en étouffant la puissance statistique par une incapacité à isoler la variabilité interindividuelle systématique.
Cet article propose une dissection exhaustive, conceptuelle, mathématique et computationnelle de ces deux modèles canoniques. En explorant successivement la décomposition formelle des sommes de carrés, les propriétés stochastiques des distributions du ratio F, les postulats d’homoscédasticité et de sphéricité, ainsi que les solutions contemporaines offertes par les modèles mixtes et les tests de robustesse, ce guide fournit aux chercheurs, psychométriciens et analystes de données la grille d’analyse rigoureuse indispensable à la conception de protocoles expérimentaux irréprochables et à l’interprétation intègre de leurs résultats empiriques.
1. Introduction aux modèles d’ANOVA en psychologie quantitative
1.1 Le rôle de l’analyse de variance dans la recherche expérimentale
L’avènement de la psychologie scientifique et quantitative a été conditionné par la nécessité impérieuse d’extraire des signaux causaux stables au milieu d’un bruit stochastique considérable inhérent à la variabilité humaine. Dès lors qu’un chercheur souhaite comparer les scores moyens d’une variable dépendante continue — telle que le temps de réaction, le niveau d’anxiété mesuré par une échelle psychométrique standardisée, ou le taux de rétention mémorielle — à travers trois conditions ou davantage, la démarche intuitive consistant à multiplier les tests t de Student pour échantillons indépendants s’avère méthodologiquement désastreuse. Cette répétition désordonnée engendre une inflation exponentielle du taux d’erreur de type I global (l’erreur de la famille d’hypothèses, ou family-wise error rate). Si l’on applique c tests t indépendants avec un seuil de significativité nominal α fixé à 0,05, la probabilité d’observer au moins un résultat faussement positif ne demeure pas à 5 %, mais bondit selon la formule 1 – (1 – α)c. Pour quatre modalités expérimentales impliquant six comparaisons bilatérales, le risque d’erreur de type I réel culmine déjà à plus de 26 %.
L’analyse de variance résout ce problème théorique majeur en intégrant l’ensemble des données au sein d’un test global (omnibus) fondé sur la distribution du ratio F de Fisher-Snedecor, documentée en profondeur par le National Institute of Standards and Technology. Au lieu de disséquer prématurément le jeu de données en paires isolées, le test F évalue simultanément la dispersion des moyennes observées par rapport à la moyenne générale globale (le « grand mean ») au regard de la dispersion résiduelle présente à l’intérieur des conditions. En établissant ainsi un rempart strict contre les faux positifs, l’ANOVA protège l’intégrité de la démarche inférentielle fréquentiste.
Au-delà de cette régulation du risque d’erreur, l’analyse de variance impose une adéquation profonde entre le devis expérimental et le modèle analytique sous-jacent. Une expérimentation n’est pas un agrégat aléatoire de chiffres ; elle reflète une chorégraphie théorique où le contrôle des facteurs parasites, la standardisation des stimuli et le plan d’assignation des participants conditionnent directement la validité des inférences causales. Le modèle d’ANOVA retenu doit ainsi être le miroir mathématique parfait de l’architecture méthodologique mise en œuvre sur le terrain de la recherche.
1.2 Origine des confusions récurrentes chez les chercheurs et étudiants
Malgré sa diffusion universelle dans les programmes d’enseignement supérieur en statistique, l’ANOVA demeure une source chronique d’erreurs d’application et de contresens méthodologiques chez les apprentis chercheurs et même au sein de publications évaluées par des pairs. L’origine de cette confusion réside principalement dans une symétrie de surface trompeuse : dans l’ANOVA à un facteur inter-sujets comme dans l’ANOVA à mesures répétées intra-sujets, le dispositif analytique mobilise une unique variable indépendante catégorielle comportant au minimum trois niveaux (ou modalités), et une unique variable dépendante continue. Dans les deux cas, le logiciel statistique standard restitue un tableau d’ANOVA contenant une somme des carrés, des degrés de liberté, un carré moyen, une statistique F et une p-valeur associée. L’objectif déclaré semble identique : rejeter l’hypothèse nulle fondamentale stipulant l’absence de divergence entre les conditions expérimentales.
Cette similitude opérationnelle occulte la césure épistémologique qui sépare la nature des facteurs manipulés. La terminologie elle-même tend à égarer les novices : qualifier un facteur de « traitement » ou de « temps » ne suffit pas à expliciter sa structure topologique. Un facteur est dit « inter-sujets » (between-subjects) lorsque chaque participant n’est exposé qu’à une et une seule modalité expérimentale, créant des strates d’individus strictement disjointes. Inversement, un facteur est qualifié d’« intra-sujets » (within-subjects ou mesures répétées) lorsque la même unité d’échantillonnage — généralement le même participant — traverse successivement l’ensemble des conditions expérimentales ou est évaluée à plusieurs moments d’un continuum chronologique.
Les conséquences inférentielles d’un mauvais aiguillage entre ces deux modèles s’avèrent délétères. Traiter des mesures répétées comme si elles provenaient de groupes indépendants viole l’un des postulats les plus sacrés du modèle linéaire général : l’indépendance conditionnelle des résidus. Cette violation induit une estimation biaisée — et le plus souvent dramatiquement gonflée — de la variance d’erreur, ce qui affaiblit considérablement la puissance du test statistique (erreur de type II). À l’inverse, modéliser des groupes indépendants à travers un algorithme de mesures répétées conduit à incorporer des pseudo-dépendances artificielles, détruisant la validité nominale du test F et produisant des résultats ininterprétables qui violent l’éthique de la rigueur scientifique.
1.3 Définition synthétique des deux approches d’inférence
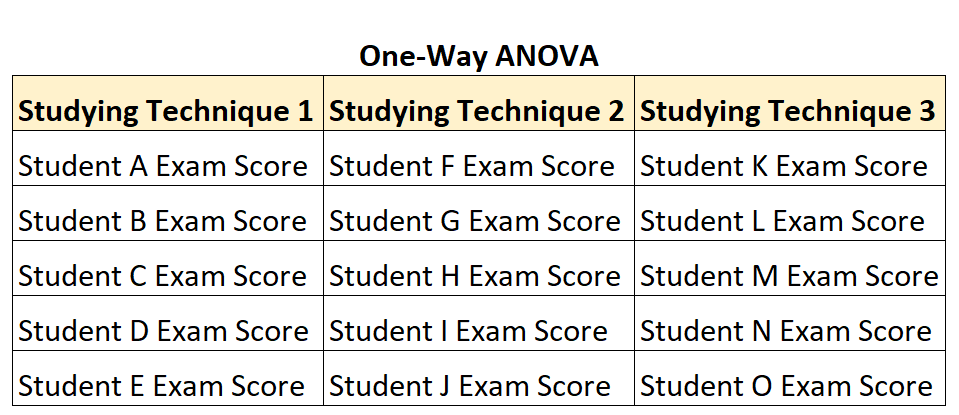
Pour dissiper ces ambiguïtés structurelles, il convient de poser avec netteté les axiomes définitoires de chaque modalité de l’analyse de variance à un facteur. L’ANOVA à un facteur inter-sujets (souvent désignée sous le terme d’ANOVA unidirectionnelle classique ou One-Way Independent ANOVA) est un modèle linéaire destiné à tester l’égalité des moyennes de k populations indépendantes (avec k ≥ 3). Dans cette configuration, chaque participant appartient exclusivement à un groupe unique ; les sous-échantillons sont mutuellement exclusifs et exhaustivement séparés. L’objectif fondamental consiste à comparer la variance existant entre les groupes (due à la fois à l’effet putatif du traitement expérimental et aux variations aléatoires) à la variance interne aux groupes (qui ne capture que les variations individuelles idiosyncrasiques et l’erreur de mesure aléatoire).
En miroir, l’ANOVA à mesures répétées à un facteur (One-Way Repeated Measures ANOVA) évalue les modifications de la moyenne d’une variable quantitative mesurée sous k conditions différentes ou à k points d’ancrage temporels distincts sur la même cohorte d’unités expérimentales. Ici, les k vecteurs de données ne représentent pas des populations d’individus disjointes, mais les facettes multidimensionnelles d’un profil de réponse individuel. Le paradigme analytique change de nature : il ne s’agit plus d’opposer les variations entre individus à l’effet expérimental, mais de neutraliser la variabilité interindividuelle globale en observant comment chaque individu dévie de sa propre ligne de base sous l’effet du traitement.
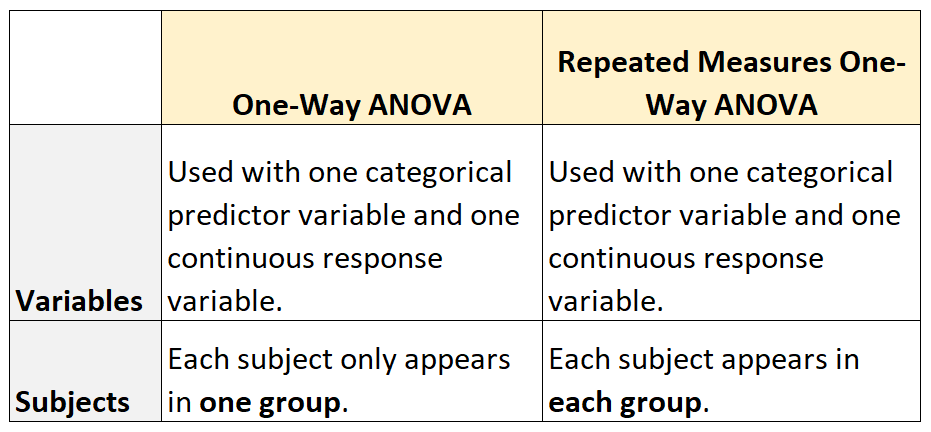
Cette dissemblance conceptuelle s’incarne matériellement dans la structure matricielle des données manipulées par les logiciels statistiques. Dans le cadre inter-sujets, la matrice se structure conventionnellement sous forme d’une table bidimensionnelle où chaque ligne correspond à un sujet singulier, complétée par une variable d’identification de groupe et la mesure dépendante. En mesures répétées, la manipulation impose une distinction cardinale entre le « format large » (wide format), où chaque sujet occupe une ligne unique comportant k colonnes correspondant aux différentes conditions répétées, et le « format long » (long format), requis par les moteurs d’estimation modernes comme la fonction lmer sous The R Project for Statistical Computing, où chaque sujet est répété sur k lignes successives, appariées par un identifiant univoque.
2. Fondements théoriques de l’ANOVA à un facteur (plan inter-sujets)
2.1 Architecture conceptuelle du plan inter-sujets
L’architecture du plan inter-sujets repose sur un impératif fondamental : le postulat d’indépendance stochastique stricte de l’ensemble des observations. Chaque mesure recueillie doit être totalement décorrélée des autres mesures du jeu de données. Pour satisfaire cette exigence d’indépendance, la méthodologie expérimentale s’appuie sur la procédure de randomisation (ou assignation aléatoire). Des participants recrutés au sein d’une population cible sont répartis par tirage au sort probabiliste dans les k modalités du facteur expérimental. Cette randomisation a pour vocation de neutraliser les biais de confusion systématiques : en moyenne, toutes les caractéristiques préexistantes (traits de personnalité, intelligence générale, bagage génétique, antécédents socio-éducatifs) se distribuent de manière équivalente entre les différents bras de l’expérimentation.
Dans ce modèle univarié simple, chaque participant apporte une contribution informationnelle unique et irrévocable : un point de donnée scalaire isolé. Si l’expérimentation comporte trois conditions (par exemple : placebo, molécule active A, molécule active B) et que 20 sujets sont assignés à chaque condition, l’échantillon global comprend N = 60 individus distincts, générant 60 observations indépendantes. L’erreur résiduelle non expliquée par le modèle — le dénominateur de la future statistique de test — est alors composée de l’intégralité des différences individuelles qui subsistent entre les sujets au sein de chaque groupe, additionnée aux erreurs de mesure instrumentales inhérentes au protocole.
Ce devis expérimental présente une pureté conceptuelle remarquable, particulièrement protectrice contre les contaminations cognitives ou physiologiques : aucun sujet n’étant confronté à plus d’une condition, les risques d’effets d’apprentissage ou de lassitude sont structurellement évacués. Toutefois, son coût méthodologique réside dans une vulnérabilité directe au bruit interindividuel : si les participants d’un même groupe présentent une forte hétérogénéité naturelle, la variance interne gonfle, masquant potentiellement les effets réels les plus discrets de la variable indépendante.
2.2 Formulation du modèle linéaire général
D’un point de vue mathématique formel, l’ANOVA à un facteur inter-sujets s’inscrit pleinement dans la théorie du modèle linéaire généralisé (Wolfram MathWorld ANOVA). Pour une observation quelconque notée Yij, représentant le score obtenu par le j-ième participant (avec j allant de 1 à ni) assigné au i-ième niveau du traitement (avec i allant de 1 à k), l’équation de décomposition s’énonce comme suit :
Yij = μ + αi + εij
Dans cette formulation canonique, μ représente la moyenne générale théorique (ou grand mean) de la population parente, définie comme l’espérance mathématique globale de la variable étudiée en l’absence de tout effet différenciateur. Le terme αi désigne l’effet fixe spécifique associé à l’appartenance à la i-ième condition de traitement ; il se définit algébriquement comme l’écart entre l’espérance de la modalité i et la moyenne générale (αi = μi – μ). Sous la contrainte d’identifiabilité standard des modèles à effets fixes, la somme pondérée des effets du traitement est nulle (∑ niαi = 0). Enfin, le terme εij incarne l’erreur résiduelle aléatoire, c’est-à-dire la déviation spécifique du participant j par rapport à la moyenne de son propre groupe (εij = Yij – μi).
Ce formalisme permet d’exprimer avec une parfaite rigueur l’hypothèse nulle (H0) soumise à l’épreuve des faits empiriques :
H0 : μ1 = μ2 = … = μk (ou, de manière équivalente, α1 = α2 = … = αk = 0)
L’hypothèse alternative (H1) n’affirme pas que l’ensemble des moyennes divergent systématiquement les unes des autres, mais postule l’existence d’au moins une paire de conditions dont les espérances mathématiques sont significativement non congruentes :
H1 : ∃ (i, m) tel que μi ≠ μm pour i ≠ m
2.3 Décomposition des sommes de carrés inter-sujets
Le génie algorithmique de l’ANOVA réside dans la partition algébrique de la déviation totale des observations en composantes additives orthogonales. La somme totale des carrés des écarts (notée SSTotal ou SST) quantifie l’ensemble de la variabilité présente dans le jeu de données par rapport à la moyenne générale globale empirique (Ȳ..) :
SSTotal = ∑i=1k ∑j=1ni (Yij – Ȳ..)2
Cette variabilité globale se scinde de manière exacte en deux termes distincts et non recouvrants : la somme des carrés intergroupes (notée SSBetween ou SSB), et la somme des carrés intragroupes (notée SSWithin, SSW ou somme des carrés résiduelle SSResidual) :
SSTotal = SSBetween + SSWithin
La somme des carrés intergroupes (SSB) mesure la dispersion des moyennes observées des k groupes (Ȳi.) autour de la moyenne générale, pondérée par la taille respective de chaque groupe (ni) :
SSBetween = ∑i=1k ni (Ȳi. – Ȳ..)2
Parallèlement, la somme des carrés intragroupes (SSW) agrège les écarts quadratiques de chaque individu par rapport à la moyenne spécifique du groupe auquel il appartient. Elle constitue l’estimation de la variance résiduelle non attribuable à la variable manipulée :
SSWithin = ∑i=1k ∑j=1ni (Yij – Ȳi.)2
À chacune de ces sommes de carrés sont assignés des degrés de liberté (ddl ou df) reflétant le nombre d’informations indépendantes mobilisées pour leur estimation. Pour SSTotal, les degrés de liberté sont de N – 1 (où N représente l’effectif global cumulé). Pour SSBetween, ils s’élèvent à k – 1. Enfin, pour SSWithin, ils sont égaux à N – k. L’additivité des sommes de carrés s’accompagne d’une stricte additivité de leurs degrés de liberté respectifs : (N – 1) = (k – 1) + (N – k).
3. Fondements théoriques de l’ANOVA à mesures répétées (plan intra-sujets)
3.1 Architecture conceptuelle du plan intra-sujets
L’ANOVA à mesures répétées incarne un changement de paradigme fondamental en substituant à la logique de comparaison entre individus distincts le principe élégant de l’auto-référencement : chaque sujet devient son propre témoin (contrôle intra-individuel). Dans ce type de plan d’expérience, les n participants recrutés sont successivement exposés à la totalité des k niveaux de la variable indépendante, ou sont observés de manière répétée à travers le temps (études longitudinales, cinétiques pharmacologiques, courbes d’apprentissage moteur). La conséquence statistique immédiate de ce devis est l’émergence d’une dépendance structurée inévitable : les scores d’un individu sous la condition 1 corrèlent systématiquement avec ses scores sous les conditions 2 et 3.
Cette non-indépendance, loin de constituer une entrave, représente l’atout majeur du plan intra-sujets. Dans l’espèce humaine, les différences stables entre individus — le profil cognitif général, l’excitabilité neuronale de base, le métabolisme, l’optimisme dispositionnel — génèrent une dispersion colossale des scores. Dans un plan inter-sujets, cette dispersion s’agrège indistinctement dans le terme d’erreur intragroupe (SSW), obscurcissant le signal expérimental. Dans le plan intra-sujets, puisque ces caractéristiques demeurent stables d’une condition à l’autre chez un sujet donné, il devient mathématiquement possible de quantifier cette variabilité interindividuelle globale et de la soustraire analytiquement du terme d’erreur résiduel.
Cette architecture confère une rentabilité expérimentale remarquable. D’une part, elle permet une économie substantielle de ressources humaines : pour évaluer 4 conditions avec 20 observations par cellule, un plan inter-sujets exige N = 80 participants distincts, tandis qu’un plan intra-sujets n’en requiert que 20 au total. D’autre part, en épurant l’erreur de mesure de la variabilité stable propre aux personnes, le plan intra-sujets optimise drastiquement la sensibilité du dispositif expérimental.
3.2 Formulation mathématique du modèle à mesures répétées
Pour capturer analytiquement cette stratification, le modèle linéaire général de l’ANOVA à mesures répétées intègre explicitement un paramètre aléatoire dédié au sujet. Pour une mesure Yij collectée auprès du i-ième sujet (avec i allant de 1 à n) soumis à la j-ième condition expérimentale (avec j allant de 1 à k), l’équation structurelle s’établit ainsi :
Yij = μ + πi + αj + εij
Dans ce modèle d’analyse à effets mixtes (où les conditions expérimentales constituent un facteur fixe et les participants un facteur aléatoire), μ désigne la constante correspondant au niveau moyen global du phénomène dans la population. Le paramètre αj représente l’effet fixe propre à la j-ième condition de mesure répétée, soumis à la contrainte standard ∑ αj = 0. Le terme novateur réside dans πi, qui modélise l’effet aléatoire invariant du i-ième participant. Ce terme πi suit une distribution normale théorique d’espérance nulle et de variance σπ2 ; il formalise le fait structurel que certains individus présentent systématiquement des scores supérieurs ou inférieurs à la moyenne, indépendamment du traitement administré.
Le dernier terme, εij, correspond à l’erreur résiduelle pure. Dans la formulation d’un plan à un facteur répété sans réplications au sein des cellules, ce résidu est indissociable de l’interaction spécifique entre le sujet et le traitement (πα)ij. Ainsi, le terme d’erreur n’exprime plus la dispersion brute des individus, mais l’inconstance de la réponse des participants d’une modalité à l’autre — c’est-à-dire l’incapacité d’un participant particulier à répondre à la condition j exactement de la même manière que la tendance moyenne de la cohorte.
3.3 Décomposition de la variance en mesures répétées
La partition de la variance en mesures répétées franchit une étape supplémentaire par rapport au schéma inter-sujets classique. La somme des carrés totale (SSTotal) demeure définie par la dispersion de l’ensemble des n × k mesures par rapport à la moyenne globale :
SSTotal = ∑i=1n ∑j=1k (Yij – Ȳ..)2, avec ddl = (n × k) – 1
La décomposition primaire sépare cette variabilité globale en une composante « entre sujets » (SSBetween-Subjects ou SSSujets) et une composante « intra-sujets » (SSWithin-Subjects) :
SSTotal = SSSujets + SSWithin-Subjects
La somme des carrés entre sujets (SSSujets) capture l’ampleur des différences chroniques et stables qui séparent les participants, en mesurant l’écart entre la moyenne individuelle de chaque participant (Ȳi.) et le grand mean :
SSSujets = k ∑i=1n (Ȳi. – Ȳ..)2, avec ddl = n – 1
C’est au sein de la fraction restante — la somme des carrés intra-sujets (SSWithin-Subjects) — que s’opère l’isolement du signal expérimental. Cette variabilité intra-sujets se scinde à son tour rigoureusement en deux fractions orthogonales : la variabilité directement induite par le traitement répété (SSTraitement) et la variabilité d’erreur résiduelle épurée (SSErreur) :
SSWithin-Subjects = SSTraitement + SSErreur
La somme des carrés du traitement (SSTraitement) s’exprime par la déviation des moyennes de chaque condition (Ȳ.j) par rapport à la moyenne globale :
SSTraitement = n ∑j=1k (Ȳ.j – Ȳ..)2, avec ddl = k – 1
Enfin, la somme des carrés d’erreur résiduelle (SSErreur), qui servira de terme d’évaluation au test F, est obtenue par soustraction directe (SSErreur = SSWithin-Subjects – SSTraitement). Algébriquement, elle se formalise par :
SSErreur = ∑i=1n ∑j=1k (Yij – Ȳi. – Ȳ.j + Ȳ..)2
Les degrés de liberté associés à cette erreur épurée résultent du produit arithmétique des degrés de liberté des deux sources croisées : ddlErreur = (n – 1)(k – 1). Cette extraction formelle de SSSujets constitue la clé de voûte de l’avantage inférentiel des plans à mesures répétées.
4. La distinction fondamentale : Groupes indépendants vs Sujets appariés
4.1 Origine de la variance résiduelle dans les deux plans
La divergence cardinale entre les plans inter-sujets et intra-sujets ne réside pas dans la quantification de l’effet expérimental — qui, au plan descriptif, compare toujours des moyennes de conditions — mais dans l’anatomie intime du terme d’erreur résiduel placé au dénominateur du ratio de Fisher. Dans le cadre de l’ANOVA inter-sujets, l’erreur résiduelle (SSW) agrège sans distinction toutes les sources de variation qui ne relèvent pas de l’appartenance au groupe. Elle incorpore donc l’intégralité des différences génétiques, cognitives, métaboliques, biographiques et motivationnelles des participants. Si un sujet du groupe « Traitement A » présente un QI de 135 et un sujet du groupe « Traitement B » un QI de 95, cette disparité naturelle vient massivement accroître la somme des carrés intragroupes, créant un bruit statistique considérable qui diminue la valeur du ratio F.
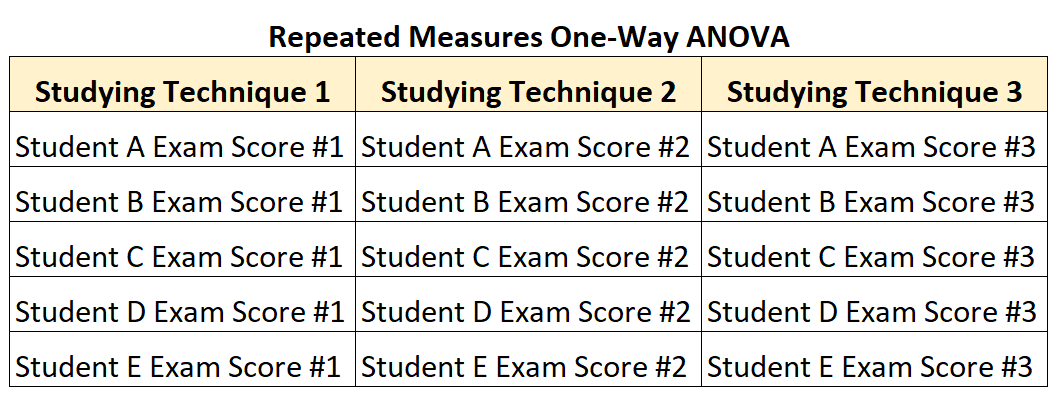
À l’opposé, l’ANOVA à mesures répétées réalise une véritable purification statistique du bruit de fond. En modélisant explicitement la performance moyenne de chaque participant à travers ses k passages, l’algorithme retire du terme d’erreur l’ensemble de la variance attribuable aux caractéristiques interindividuelles stables. La variance résiduelle (SSErreur) ne mesure plus « combien les individus diffèrent les uns des autres », mais uniquement « à quel point la trajectoire différentielle d’un individu s’écarte de la trajectoire différentielle moyenne du groupe ». Tout ce qui constitue un profil stable — le fait d’être chroniquement plus lent, plus anxieux, ou plus performant — est entièrement neutralisé.
Cette soustraction analytique a un impact direct et massif sur la précision de l’estimation. Le dénominateur du test F s’en trouve généralement drastiquement amoindri. Dès lors, pour un même différentiel observé entre les moyennes des conditions, le test à mesures répétées affichera une valeur de F substantiellement supérieure, conférant à l’expérimentateur une acuité accrue pour rejeter l’hypothèse nulle lorsque celle-ci est fausse en réalité.
4.2 Conséquences sur l’échantillonnage et la représentativité
Ce partitionnement différencié induit des répercussions logistiques et épistémologiques profondes sur les stratégies d’échantillonnage. En premier lieu, la demande volumétrique brute en participants varie du simple au multiple. Si une analyse de puissance a priori prescrit la collecte de 30 observations par cellule pour détecter une taille d’effet modérée à travers 4 modalités expérimentales, le plan inter-sujets impose le recrutement, l’accueil et la prise en charge de 120 individus distincts (n = 30 × 4). Le plan à mesures répétées permet d’atteindre le même nombre d’observations cellulaires avec seulement 30 participants uniques (N = 30).
Cependant, cette économie d’échantillonnage s’accompagne d’une vulnérabilité accrue à un fléau méthodologique majeur : l’attrition expérimentale (ou abandons de recherche). Dans un plan inter-sujets, si le quarantième participant omet de se présenter à la session de test ou si ses données sont corrompues, seule cette observation isolée est retranchée de l’analyse, réduisant marginalement la taille du groupe concerné (n = 29 au lieu de 30), sans vicier fondamentalement la structure orthogonale du modèle. En mesures répétées classiques, la structure matricielle matricielle est rigide : si un participant réalise les conditions 1, 2 et 3 mais fait défection avant la condition 4, l’algorithme standard d’ANOVA à mesures répétées — fondé sur le modèle linéaire général par moindres carrés ordinaires — rejette l’intégralité du profil de l’individu par suppression par liste (listwise deletion). L’abandon d’un sujet entraîne ainsi l’amputation de 3 points de données valides déjà enregistrés.
Par ailleurs, le plan inter-sujets demeure exposé au spectre de l’échec d’assignation aléatoire. En dépit de la rigueur de la randomisation probabiliste, des cohortes de petite taille (par exemple n ≤ 15 par groupe) peuvent fortuitement hériter de déséquilibres flagrants sur des variables parasites non mesurées. Le plan intra-sujets, par essence, assure un contrôle écologique parfait de ces covariables latentes, puisque chaque participant conserve son profil génétique et son passé expérientiel invariable d’une condition à la suivante.
4.3 Comparaison synthétique des caractéristiques structurelles
L’analyse des différences fondamentales entre ces deux démarches gagne à être synthétisée selon une grille de lecture multidimensionnelle, contrastant leurs spécificités structurelles, conceptuelles et opérationnelles :
| Paramètre de comparaison | ANOVA à un facteur (Inter-sujets) | ANOVA à mesures répétées (Intra-sujets) |
|---|---|---|
| Structure de l’échantillon | Groupes de participants distincts et mutuellement exclusifs. | Cohorte unique de participants traversant toutes les conditions. |
| Indépendance des observations | Stricte : corrélation nulle requise entre toutes les mesures. | Dépendance positive structurée entre les mesures d’un même sujet. |
| Origine du terme d’erreur | Variance intragroupe globale (différences individuelles + erreur de mesure). | Interaction sujet × condition (résidu épuré de la variance entre sujets). |
| Sensibilité à l’attrition | Modérée : perte restreinte à l’observation manquante. | Sévère : perte fréquente de l’ensemble du sujet en cas de cellule manquante. |
| Menaces majeures à la validité | Biais d’échantillonnage, déséquilibre fortuit des covariables parasites. | Effets d’ordre, effets de période, lassitude, apprentissage, report. |
| Degrés de liberté de l’erreur | Élevés : N – k. | Réduits : (n – 1)(k – 1). |
| Hypothèse de variance spécifique | Homoscédasticité (homogénéité des variances intergroupes). | Sphéricité (homogénéité des variances des différences par paires). |
Cette distinction matérialise l’arbitrage fondamental de l’expérimentateur : opter pour la robustesse logistique et l’immunité contre les effets de contamination temporelle (inter-sujets), ou maximiser l’économie d’échantillonnage et la sensibilité statistique en acceptant des contraintes méthodologiques d’ordonnancement sévères (intra-sujets).
5. Analyse comparative approfondie des formules et calculs du test F
5.1 Calcul du ratio F dans l’ANOVA à un facteur
L’évaluation statistique de l’hypothèse nulle repose sur le ratio de variance F, construit de telle sorte que son comportement probabiliste sous H0 soit parfaitement modélisé par la loi théorique de Fisher-Snedecor. Dans le plan inter-sujets, la mécanique calculatoire procède par conversion des sommes de carrés en « carrés moyens » (Mean Squares ou MS), obtenus en divisant chaque somme quadratique par ses degrés de liberté correspondants :
MSBetween = SSBetween / (k – 1)
MSWithin = SSWithin / (N – k)
Le carré moyen intergroupes (MSBetween ou MSB) estime théoriquement la variance de l’erreur résiduelle augmentée de la composante attribuable au différentiel moyen des traitements, pondérée par l’effectif des groupes : E[MSB] = σε2 + [(∑ ni αi2) / (k – 1)]. Le carré moyen intragroupe (MSWithin ou MSW) constitue quant à lui une estimation sans biais exclusive de la variance résiduelle aléatoire de la population : E[MSW] = σε2. La statistique F est alors le quotient direct :
FInter = MSBetween / MSWithin
Lorsque l’hypothèse nulle est scrupuleusement vérifiée dans la population (αi = 0 pour tout i), la composante de traitement s’évanouit et le numérateur n’est plus qu’une seconde estimation indépendante de σε2. En conséquence, le ratio F gravite autour d’une espérance mathématique proche de l’unité (plus précisément ddlerreur / (ddlerreur – 2)). La distribution théorique associée est formellement une distribution F possédant ν1 = k – 1 et ν2 = N – k degrés de liberté. Si la statistique calculée empiriquement surpasse la valeur critique définie au seuil α, le chercheur conclut au rejet de l’hypothèse d’invariance des moyennes.
5.2 Calcul du ratio F dans l’ANOVA à mesures répétées
En mesures répétées, l’équation d’estimation du ratio F subit une transformation capitale commandée par la nouvelle structure d’erreur. Les sommes de carrés pertinentes sont préalablement réduites à leurs carrés moyens respectifs :
MSTraitement = SSTraitement / (k – 1)
MSErreur = SSErreur / [(n – 1)(k – 1)]
L’espérance mathématique du carré moyen du traitement s’énonce : E[MSTraitement] = σε2 + n [(∑ αj2) / (k – 1)]. En revanche, le dénominateur n’est plus constitué par la dispersion globale des sujets, mais par le résidu pur d’interaction entre les participants et les conditions expérimentales. L’espérance mathématique du terme d’erreur épuré s’établit à : E[MSErreur] = σε2. La statistique de test prend dès lors la forme :
FRépété = MSTraitement / MSErreur
Cette statistique empirique est régie par une distribution théorique de Fisher affichant des degrés de liberté modifiés : ν1 = k – 1 au numérateur, et ν2 = (n – 1)(k – 1) au dénominateur. La conséquence de cette structure réside dans la double modification du dénominateur par rapport au plan inter-sujets : la valeur numérique de MSErreur est substantiellement amoindrie dès lors que les scores des participants sont positivement corrélés entre les sessions, mais les degrés de liberté résiduels sont également réduits, imposant une valeur critique de F théorique légèrement plus exigeante pour franchir le seuil de rejet conventionnel.
5.3 Démonstration de l’impact de l’extraction de variance sur la statistique de test
Pour appréhender concrètement la puissance du mécanisme d’épuration, considérons une expérience impliquant k = 3 conditions administrées à n = 10 sujets. Supposons que l’effet expérimental produise une somme des carrés de traitement SSTraitement = 120 (donc MSTraitement = 120 / 2 = 60). Admettons que la somme des carrés intra-sujets totale SSWithin-Subjects s’élève à 250. Dans cette situation, si les caractéristiques individuelles des participants sont fortement discriminantes, une vaste part de cette dispersion sera captée par SSSujets, par exemple 190. La somme des carrés d’erreur résiduelle résiduelle tombe alors à SSErreur = 250 – 190 = 60.
Calculons le carré moyen d’erreur : avec (10 – 1)(3 – 1) = 18 degrés de liberté, MSErreur = 60 / 18 ≈ 3,33. La statistique F en mesures répétées s’élève alors à :
FRépété = 60 / 3,33 = 18,02 (avec p < 0,001).
Imaginons désormais que ces mêmes données proviennent d’un plan inter-sujets comportant 3 groupes distincts de 10 participants, produisant les mêmes moyennes et la même variance globale. Dans ce cas, les 190 points de variabilité individuelle ne peuvent pas être isolés : ils demeurent intégrés au terme d’erreur SSWithin, lequel cumule 190 + 60 = 250. Les degrés de liberté résiduels s’élèvent à N – k = 30 – 3 = 27. Le carré moyen intragroupe devient alors : MSWithin = 250 / 27 ≈ 9,26. La statistique F inter-sujets s’établit à :
FInter = 60 / 9,26 = 6,48 (avec p ≈ 0,005).
Le ratio F a été quasiment triplé en mesures répétées (18,02 contre 6,48) en vertu de l’élimination de la composante SSSujets. Le cas limite théorique apparaît lorsque la corrélation intra-classe entre les conditions répétées est strictement nulle (les individus ne présentent aucune stabilité relative dans leurs scores). Dans ce scénario pathologique singulier, SSSujets tend vers sa valeur d’espérance aléatoire, l’extraction de variance ne compense plus la déflation mécanique des degrés de liberté au dénominateur, et le plan à mesures répétées perd alors son avantage statistique.
6. Hypothèses sous-jacentes et conditions d’application respectives
6.1 Postulats partagés par les deux modèles
L’utilisation intègre des modèles d’analyse de variance repose sur un socle de postulats paramétriques universels qui conditionnent la fidélité de l’inférence. Le premier postulat réside dans la métrique de la variable dépendante : celle-ci doit obligatoirement être quantitative continue, mesurée selon une échelle d’intervalles ou de rapports. Appliquer une ANOVA à des échelles ordinales courtes (comme des échelles de Likert à 3 ou 4 points) sans précaution expose à des distorsions métriques substantielles, bien que la littérature montre une tolérance pragmatique lorsque les distributions approchent la symétrie.
Le second postulat partagé concerne la normalité de la distribution des résidus d’erreur dans la population. Il ne s’agit pas d’exiger que l’échantillon brut global suive une loi normale, mais de vérifier que les résidus ε — c’est-à-dire les déviations individuelles par rapport à la moyenne conditionnelle — obéissent à une distribution gaussienne théorique N(0, σ2). L’évaluation de cette conformité ne doit pas reposer uniquement sur des tests formels d’adéquation tels que le test de Shapiro-Wilk ou de Kolmogorov-Smirnov, dont la puissance excessive sur de grands échantillons conduit à rejeter la normalité pour des écarts insignifiants. Le diagnostic gagne à s’appuyer sur l’inspection graphique des diagrammes quantile-quantile (Q-Q plots), complétée par les indices d’asymétrie (skewness) et d’aplatissement (kurtosis).
Enfin, la présence de valeurs aberrantes (outliers) non représentatives constitue une menace partagée pour les deux démarches. En raison de l’utilisation de termes quadratiques dans la somme des carrés, un unique score déviant de plusieurs écarts-types est susceptible de gonfler artificiellement les moyennes conditionnelles ou de surdimensionner la variance d’erreur résiduelle, induisant indifféremment des erreurs d’interprétation de type I ou de type II.
6.2 L’homogénéité des variances (Homoscédasticité) pour le plan inter-sujets
Dans l’ANOVA inter-sujets, la validité du ratio F est tributaire du respect impérieux de l’hypothèse d’homoscédasticité : les variances de la variable dépendante au sein de chacune des k populations doivent être strictement équivalentes (σ12 = σ22 = … = σk2 = σ2). Cette condition est nécessaire car le dénominateur MSWithin repose sur une agrégation globale (un « pool ») des variances internes à chaque groupe. Si les dispersions intrinsèques divergent profondément, cette estimation commune perd sa signification probabiliste.
Pour contrôler ce postulat, les chercheurs recourent classiquement au test de Levene (préférable au test de Bartlett en raison de sa moindre sensibilité aux entorses à la normalité pure). Le test de Levene standard évalue l’égalité des variances en appliquant une ANOVA sur les écarts absolus des scores par rapport à la moyenne du groupe ; la variante robuste développée par Brown et Forsythe substitue la médiane à la moyenne pour un comportement optimal en présence d’asymétrie.
L’impact de la violation de l’homoscédasticité dépend intimement de l’équilibre des effectifs (sample sizes). Lorsque le plan d’expérience est parfaitement équilibré (n1 = n2 = … = nk), le test F fait preuve d’une robustesse exceptionnelle face à des hétérogénéités modérées des variances. En revanche, si le plan est déséquilibré, la violation devient fatale : l’association d’un petit échantillon à une grande variance produit une inflation massive du taux d’erreur de première espèce (α effectif pouvant atteindre 0,15 pour un seuil nominal de 0,05). À l’inverse, l’association d’un grand échantillon à une grande variance bride indûment la puissance du test. En cas d’hétéroscédasticité avérée en plan non balancé, le recours direct à l’ajustement de Welch ou à l’ANOVA de Brown-Forsythe s’impose comme une nécessité algorithmique.
6.3 L’hypothèse de sphéricité pour le plan intra-sujets
Dans l’ANOVA à mesures répétées, l’exigence d’homogénéité ne se limite pas à l’égalité des variances univariées de chaque condition ; elle s’étend à la structure de covariance multivariée à travers le concept capital de sphéricité (ou circularité). Formalisée par Box, la sphéricité stipule que les variances de toutes les différences possibles calculées par paires de conditions doivent être strictement égales. Pour trois conditions A, B et C, la sphéricité requiert que :
Var(A – B) ≈ Var(A – C) ≈ Var(B – C)
Une condition suffisante (quoique non strictement nécessaire) pour que la sphéricité soit respectée est la symétrie composée (compound symmetry), qui postule à la fois l’homogénéité des variances de chaque condition et l’égalité parfaite des covariances entre toutes les paires de conditions. Dans les recherches empiriques en psychologie, cette exigence est très fréquemment violée. Dans une étude longitudinale, par exemple, deux points de mesure temporellement contigus (semaine 1 et semaine 2) corrèlent presque systématiquement davantage que deux points de mesure chronologiquement distants (semaine 1 et semaine 8). Cette dérive structurelle rompt l’égalité des variances des différences, induisant une défaillance de la sphéricité.
Le diagnostic universel de ce postulat est opéré au moyen du test de sphéricité de Mauchly. L’hypothèse nulle du test de Mauchly pose que la matrice de variance-covariance des différences est proportionnelle à une matrice identité. Si la valeur p associée au W de Mauchly franchit le seuil critique (p < 0,05), l’hypothèse de sphéricité est formellement rejetée. La sanction statistique de cette violation est immédiate : le ratio F ne suit plus la distribution théorique présumée sous H0, provoquant une augmentation substantielle du taux d’erreur de type I (rejet intempestif de l’hypothèse nulle en l’absence d’effet réel).
7. Puissance statistique et contrôle de la variabilité interindividuelle
7.1 Le mécanisme d’amplification de la puissance statistique en mesures répétées
La puissance statistique — définie comme la probabilité (1 – β) de rejeter l’hypothèse nulle lorsqu’elle est effectivement fausse — constitue le critère suprême de performance d’un protocole de recherche. Dans cette perspective, l’ANOVA à mesures répétées dispose d’un avantage comparatif intrinsèque sur les plans inter-sujets grâce à l’élimination systématique de la variance interindividuelle stable du terme d’erreur résiduel.
L’intensité de ce gain de puissance dépend directement du coefficient de corrélation intra-classe (ICC) liant les observations répétées chez les mêmes sujets. Plus les caractéristiques intrinsèques des participants influencent de manière homogène leurs scores d’un essai à l’autre (se traduisant par de fortes corrélations bivariées positives, par exemple r ≥ 0,70), plus la proportion de variance soustraite (SSSujets) est importante. En conséquence, la variance résiduelle MSErreur s’effondre, amplifiant mécaniquement la statistique F empirique. Il devient dès lors possible de détecter des tailles d’effet ténues — typiques des processus cognitifs subtils ou des micro-variations physiologiques — qui demeureraient irrémédiablement ensevelies sous le bruit interindividuel au sein d’un devis inter-sujets standard.
Cette sensibilité amplifiée transforme l’équation logistique de la recherche expérimentale. À niveau de puissance visé égal (par exemple 1 – β = 0,80 avec α = 0,05), le plan intra-sujets permet de diviser fréquemment le recrutement nécessaire par un facteur deux, trois, voire quatre, rendant viables des études portant sur des populations cliniques rares (patients cérébrolésés, syndromes génétiques orphelins) où le recrutement de cohortes pléthoriques relève de l’impossibilité pratique.
7.2 Le compromis coût-bénéfice des degrés de liberté
L’avantage du plan à mesures répétées n’est toutefois pas absolu et résulte d’un compromis formel entre la réduction de la somme des carrés résiduelle et la perte arithmétique de degrés de liberté au dénominateur du test F. Dans un plan inter-sujets comprenant k conditions de n participants, les degrés de liberté résiduels s’élèvent à N – k = k(n – 1). Dans un plan intra-sujets mobilisant un échantillon global de n sujets traversant les mêmes k conditions, les degrés de liberté résiduels chutent à (n – 1)(k – 1). Pour une étude à 3 conditions mobilisant 10 participants par modalité, le plan inter-sujets bénéficie de 30 – 3 = 27 ddl d’erreur, alors que le plan intra-sujets (avec 10 participants au total) n’en dispose plus que de (10 – 1)(3 – 1) = 18.
Or, dans la distribution de Fisher-Snedecor, une amputation des degrés de liberté résiduels élargit la queue de distribution, ce qui rehausse la valeur critique de F requise pour atteindre la significativité statistique. Pour que le plan à mesures répétées soit statistiquement avantageux par rapport au plan inter-sujets, le bénéfice issu de l’extraction de variance doit surpasser cette pénalité de degrés de liberté. Ce seuil de rentabilité est précisément gouverné par la corrélation test-retest moyenne existant entre les conditions :
Si la corrélation intra-sujet moyenne r̄ est strictement positive et substantielle (typiquement r̄ > 0,20 ou 0,30 selon les devis), le gain d’épuration de la variance surclasse très largement la perte de degrés de liberté, et la puissance globale s’accroît. En revanche, si la mesure répétée est bruitée au point que la corrélation inter-conditions soit quasi nulle ou négative, l’extraction de variance échoue, la perte des degrés de liberté handicape lourdement le modèle, et l’ANOVA à mesures répétées devient paradoxalement moins puissante que ne l’aurait été un plan inter-sujets équivalent.
7.3 Calcul de la taille d’effet : Eta-carré vs Eta-carré partiel
La seule observation de la valeur p est incapable de renseigner le chercheur sur l’amplitude substantive de l’effet découvert. L’analyse contemporaine impose l’estimation rigoureuse de la taille d’effet. Dans le cadre de l’ANOVA à un facteur inter-sujets, la métrique canonique est l’Êta-carré classique (η2), qui exprime le ratio de la somme des carrés de traitement sur la somme des carrés totale :
η2 = SSBetween / SSTotal
Ce ratio s’interprète directement comme le pourcentage de variance totale de la variable dépendante expliqué par le facteur expérimental. Toutefois, dans les modèles à mesures répétées, l’application de cette formule brute produit des valeurs artificiellement comprimées en raison de la présence de la composante SSSujets dans le dénominateur total. Pour neutraliser cette distorsion métrique, la littérature préconise l’utilisation systématique de l’Êta-carré partiel (ηp2), documenté par les recommandations de l’American Psychological Association :
ηp2 = SSTraitement / (SSTraitement + SSErreur)
Dans l’ANOVA inter-sujets à un facteur, η2 et ηp2 sont rigoureusement identiques puisque SSTotal = SSBetween + SSWithin. Dans l’ANOVA à mesures répétées, en revanche, ηp2 exclut délibérément la variance SSSujets du dénominateur, mesurant la part de variance expliquée par le traitement au sein de la seule variabilité non liée aux disparités interindividuelles stables. Il en résulte un risque critique de surinterprétation : un ηp2 de 0,30 obtenu en mesures répétées ne traduit aucunement la même force associative qu’un η2 de 0,30 obtenu en inter-sujets. Pour pallier les biais de surestimation inhérents à l’Êta-carré sur de petits échantillons, les méthodologistes recommandent fréquemment l’Oméga-carré partiel (ωp2), estimateur ajusté moins biaisé de la véritable proportion de variance expliquée dans la population parente.
8. Biais expérimentaux et menaces spécifiques à la validité interne
8.1 Menaces inhérentes aux plans à mesures répétées
Si le plan à mesures répétées brille par son élégance statistique, il se heurte à des menaces redoutables pesant sur sa validité interne. L’exposition consécutive d’un être humain à plusieurs conditions expérimentales n’est jamais neutre. La première de ces menaces réside dans les effets d’ordre et de séquence : la simple position chronologique d’une tâche dans le protocole influence la performance finale, indépendamment de la nature intrinsèque de la tâche. Ces effets se manifestent de manière bipolaire : sous forme d’effets d’apprentissage et de familiarisation (amélioration graduelle des scores au fil des essais par maîtrise cognitive du dispositif) ou sous forme d’effets de fatigue, de lassitude attentionnelle et de démotivation (dégradation graduelle des scores au fil du temps).
Une menace encore plus insidieuse concerne les effets de report résiduels (carryover effects). Il y a report lorsqu’un traitement administré lors de la condition j produit des altérations physiologiques ou cognitives persistantes qui contaminent la mesure recueillie lors de la condition suivante j+1. Ce phénomène est omniprésent dans les recherches pharmacologiques (cinétique d’élimination lente d’une molécule) ou dans les protocoles de psychologie cognitive mobilisant des stratégies de résolution de problèmes dont le sujet ne peut faire abstraction lors des tâches subséquentes.
Pour neutraliser ces artefacts sans détruire le plan intra-sujets, la méthode reine consiste à recourir au contrebalancement des conditions. Lorsque le nombre de modalités est réduit, le chercheur applique un contrebalancement complet, attribuant aléatoirement les sujets à l’ensemble des k! permutations factorielles possibles. Lorsque le nombre de modalités s’accroît, rendant les permutations exponentiellement impraticables, l’expérimentateur adopte un plan en carré latin équilibré. Dans cette configuration géométrique formalisée, chaque modalité apparaît une fois et une seule à chaque position séquentielle, et chaque modalité précède et suit immédiatement chacune des autres un nombre rigoureusement égal de fois, annulant statistiquement les effets de report linéaire.
8.2 Menaces inhérentes aux plans inter-sujets
Les plans inter-sujets ne sont pas exempts de failles méthodologiques majeures ; leurs vulnérabilités s’expriment simplement dans un registre méthodologique différent. Le talon d’Achille de ces plans réside dans le risque persistant d’inégalité initiale entre les groupes de traitement. Si le tirage au sort probabiliste fonctionne de manière optimale sur de grands volumes asymptotiques, les échantillons restreints — fréquents en neurosciences ou en psychologie clinique — échouent souvent à équilibrer les déterminants individuels profonds des participants.
Cette contingence génère un risque majeur de confusion méthodologique : si, au gré de la randomisation, le groupe assigné à la méthode didactique innovante se trouve accidentellement concentrer des sujets possédant un niveau socio-économique ou des aptitudes métacognitives supérieures à ceux du groupe témoin, l’écart observé en post-test sera imprudemment attribué à l’intervention pédagogique, alors qu’il ne reflète que l’asymétrie structurelle des cohortes initiales. L’analyse de variance à un facteur est incapable de démêler cette intrication si ces variables d’ancrage n’ont pas été identifiées et intégrées a priori sous forme de covariables au sein d’une ANCOVA.
De plus, cette sensibilité au bruit de fond impose aux chercheurs la collecte de cohortes volumineuses afin de diluer statistiquement ces idiosyncrasies individuelles. Cette contrainte volumétrique peut induire des dérives logistiques : étalement du recrutement sur de longs mois, rotation des expérimentateurs, variations temporelles et saisonnières des conditions de passation — autant de macro-variations d’environnement qui réinjectent subrepticement de nouvelles sources d’hétérogénéité résiduelle dans le terme d’erreur de l’ANOVA inter-sujets.
8.3 Critères de sélection méthodologique basés sur les menaces de validité
Le choix décisionnel entre un devis inter-sujets et un devis à mesures répétées ne doit ainsi jamais être guidé exclusivement par la quête opportuniste d’une plus grande puissance statistique, mais par une évaluation lucide des contraintes de validité interne inhérentes à la manipulation envisagée. Il existe des situations expérimentales où le plan à mesures répétées s’avère méthodologiquement prohibé. C’est le cas dès lors que la variable manipulée induit un changement développemental, cognitif ou neurobiologique irréversible. Une recherche évaluant l’efficacité d’une méthode d’alphabétisation ou d’une technique de remédiation cognitive après un accident vasculaire cérébral ne peut être testée en mesures répétées : un participant ayant acquis une compétence mnémotechnique ou linguistique ne peut être « déprogrammé » pour servir de propre contrôle sous la modalité placebo.
De même, dans les protocoles d’évaluation pharmacologique où les composés présentent une demi-vie prolongée ou un métabolisme complexe susceptible de modifier durablement la sensibilité des récepteurs cibles, l’utilisation de groupes indépendants est une exigence de sécurité scientifique incontournable pour écarter tout effet résiduel persistant.
À l’inverse, dès lors que les effets étudiés sont éphémères, réversibles et caractérisés par une cinétique de récupération quasi instantanée — comme l’évaluation de seuils perceptifs visuels en psychophysique, l’analyse de temps de fixation oculaire sous différents contrastes chromatiques ou l’enregistrement de réponses électrodermales face à des stimuli émotionnels —, le plan à mesures répétées s’impose comme le standard d’excellence, combinant une neutralisation maximale du bruit interindividuel à une efficience logistique optimale.
9. Étude de cas empirique : Évaluation de trois techniques d’apprentissage
9.1 Scénario A : Expérimentation inter-sujets avec groupes indépendants
Afin d’illustrer la divergence fonctionnelle des deux paradigmes, déployons une étude empirique comparant trois méthodes pédagogiques destinées à favoriser l’apprentissage du vocabulaire d’une langue étrangère : la méthode par simple répétition mécanique (Modalité 1), la méthode par fiches mnémotechniques ou cartes mémoire (Modalité 2), et la méthode par auto-explication élaborative (Modalité 3). La variable dépendante est constituée par le score obtenu à un examen standardisé de rétention mémorielle (noté de 0 à 100).
Dans le Scénario A, le chercheur met en œuvre un plan inter-sujets classique. Il recrute 15 étudiants distincts et les assigne aléatoirement, par groupes égaux de 5, à l’une des trois conditions d’apprentissage. La matrice de données univariée se présente sous la forme d’un tableau de 15 lignes, comprenant une variable catégorielle de groupe et le score d’examen associé :
- Groupe 1 (Répétition mécanique) : 52, 58, 63, 49, 58 → Moyenne Ȳ1. = 56,0 ; Variance s12 = 29,5
- Groupe 2 (Cartes mémoire) : 64, 71, 68, 62, 70 → Moyenne Ȳ2. = 67,0 ; Variance s22 = 14,5
- Groupe 3 (Auto-explication) : 75, 82, 79, 73, 81 → Moyenne Ȳ3. = 78,0 ; Variance s32 = 15,5
La moyenne générale globale s’établit à Ȳ.. = (56 + 67 + 78) / 3 = 67,0. La somme des carrés intergroupes s’élève à :
SSBetween = 5 × [(56 – 67)2 + (67 – 67)2 + (78 – 67)2] = 5 × [121 + 0 + 121] = 5 × 242 = 1210,0
Pour la somme des carrés intragroupes, en agrégeant les déviations quadratiques par rapport aux moyennes de groupe respectives, nous obtenons : SSWithin = 118,0 + 58,0 + 62,0 = 238,0. Les degrés de liberté sont k – 1 = 2 pour l’intergroupe, et N – k = 15 – 3 = 12 pour l’intragroupe. Les carrés moyens valent :
MSBetween = 1210,0 / 2 = 605,0
MSWithin = 238,0 / 12 ≈ 19,83
La statistique F de Fisher s’élève dès lors à :
F(2, 12) = 605,0 / 19,83 = 30,51 (valeur p = 0,000021)
Dans ce scénario A, l’effet expérimental est suffisamment marqué pour transpercer le bruit résiduel interindividuel (MSW = 19,83), permettant un rejet hautement significatif de l’hypothèse nulle.
9.2 Scénario B : Expérimentation intra-sujets à mesures répétées
Envisageons désormais le Scénario B. Le chercheur utilise un devis à mesures répétées rigoureusement équilibré en carré latin. Plutôt que de recruter 15 sujets distincts, il ne mobilise que 5 participants uniques, chaque participant étant évalué successivement sous les trois méthodes au cours de trois semaines d’apprentissage disjointes (avec des listes de vocabulaire équivalentes).
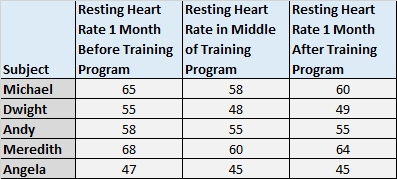
Supposons que les données recueillies soient rigoureusement congruentes avec les scores cellulaires du scénario précédent, les 5 sujets générant les profils appariés suivants :
- Sujet 1 : Répétition = 52 ; Cartes = 64 ; Explication = 75 → Moyenne individuelle Ȳ1. = 63,67
- Sujet 2 : Répétition = 58 ; Cartes = 71 ; Explication = 82 → Moyenne individuelle Ȳ2. = 70,33
- Sujet 3 : Répétition = 63 ; Cartes = 68 ; Explication = 79 → Moyenne individuelle Ȳ3. = 70,00
- Sujet 4 : Répétition = 49 ; Cartes = 62 ; Explication = 73 → Moyenne individuelle Ȳ4. = 61,33
- Sujet 5 : Répétition = 58 ; Cartes = 70 ; Explication = 81 → Moyenne individuelle Ȳ5. = 69,67
Dans ce jeu de données appariées, la somme des carrés totale (SSTotal = 1448,0) et la somme des carrés du traitement (SSTraitement = 1210,0) sont parfaitement identiques à celles du scénario A. Cependant, nous pouvons désormais extraire la variabilité stable attribuable aux sujets :
SSSujets = 3 × [(63,67 – 67)2 + (70,33 – 67)2 + (70,00 – 67)2 + (61,33 – 67)2 + (69,67 – 67)2] = 3 × [11,09 + 11,09 + 9,00 + 32,15 + 7,13] = 3 × 70,46 = 211,38
La somme des carrés résiduelle d’erreur épurée (SSErreur) s’obtient par soustraction de SSSujets hors de la variance résiduelle brute de 238,0 :
SSErreur = 238,0 – 211,38 = 26,62
Les degrés de liberté résiduels s’élèvent à (5 – 1)(3 – 1) = 8. Le carré moyen d’erreur devient :
MSErreur = 26,62 / 8 = 3,33
Le ratio F recalculé dans le cadre de l’ANOVA à mesures répétées bondit alors à :
F(2, 8) = 605,0 / 3,33 = 181,68 (valeur p = 0,00000002)
9.3 Enseignements tirés de la modélisation comparative
La mise en miroir numérique des Scénarios A et B fournit une démonstration saisissante de l’efficacité inférentielle de l’ANOVA à mesures répétées. En soustrayant analytiquement les 211,38 points de variance correspondant aux variations cognitives stables entre les 5 participants, le dénominateur de la statistique de test a été compressé de 19,83 à 3,33. La valeur de F s’en trouve sextuplée, propulsant la significativité statistique vers des seuils infinitésimaux.
Ce contraste met également en relief le coût de chaque modèle. Dans le scénario intra-sujets, la puissance a culminé avec un tiers seulement de l’échantillon humain requis par le modèle inter-sujets (5 participants contre 15). Toutefois, pour que ce résultat soit scientifiquement irréprochable dans le monde réel, l’expérimentateur du scénario B a dû concevoir trois listes de vocabulaire rigoureusement équivalentes en difficulté lexicale et en fréquence d’usage pour éliminer tout effet de contenu, déployer un contrebalancement systématique de l’ordre d’administration, et imposer un intervalle temporel de plusieurs jours entre les sessions afin d’éviter la contamination résiduelle de la fatigue cognitive.
10. Stratégies d’analyses post-hoc et contrastes a priori
10.1 Comparaisons multiples dans le cadre inter-sujets
L’obtention d’une statistique F globale statistiquement significative atteste de l’existence d’une divergence au sein du réseau des moyennes, mais ne spécifie aucunement quelles paires de conditions se distinguent mutuellement. Pour cartographier ces disparités sans compromettre le taux d’erreur nominal global, le chercheur doit déployer des procédures de comparaisons multiples a posteriori (analyses post-hoc). Dans le cadre de l’ANOVA inter-sujets, la méthode canonique universelle est le test HSD (Honestly Significant Difference) de Tukey.
Le test HSD de Tukey repose sur la distribution de l’étendue studentisée (distribution q). Il exploite le carré moyen intragroupe (MSW) issu de l’ANOVA globale comme estimateur commun et convergent de la variance d’erreur résiduelle, pondéré par l’effectif des groupes :
q = |Ȳi. – Ȳm.| / √(MSWithin / n)
Cette approche est optimale pour comparer toutes les paires possibles de moyennes tout en maintenant rigoureusement l’erreur de type I globale au seuil α. Si l’expérimentateur a formulé a posteriori des hypothèses complexes — comparant par exemple la moyenne combinée de deux groupes d’interventions actives à un groupe témoin —, le test de Scheffé offre une protection absolue contre l’erreur de première espèce, quelle que soit la complexité des contrastes explorés, bien qu’au prix d’une sévérité conservatrice accrue.
10.2 Comparaisons multiples en mesures répétées
L’application mécanique des procédures post-hoc inter-sujets (tel que le test HSD de Tukey standard basé sur un dénominateur groupé unique) aux plans à mesures répétées constitue une faute méthodologique fréquemment épinglée par les statisticiens méthodologistes (notamment Maxwell et Delaney). Dans un devis intra-sujets, le postulat de symétrie composée universelle est rarement respecté point par point : la variance d’erreur résiduelle associée à la différence entre les conditions 1 et 2 n’est presque jamais strictement identique à celle qui sépare les conditions 2 et 3.
En conséquence, l’utilisation d’une variance d’erreur résiduelle commune agrégée (MSErreur) tend à sous-estimer le taux d’erreur de première espèce pour certaines paires de conditions et à le surestimer pour d’autres. La recommandation méthodologique préconise dès lors le recours à des séries de tests t appariés calculés de manière spécifique et individualisée pour chaque paire de conditions — en exploitant l’erreur type propre à la différence de cette paire précise —, tout en appliquant une correction rigoureuse du seuil de significativité pour juguler l’inflation du risque α global.
Parmi les algorithmes d’ajustement, la procédure séquentielle de Holm-Bonferroni (ou méthode de Bonferroni descendante) supplante avantageusement la correction classique de Bonferroni par division brute. Elle conserve un contrôle strict du family-wise error rate tout en conférant une puissance statistique supérieure. Par ailleurs, la représentation graphique de ces comparaisons multiples impose de ne pas utiliser les intervalles de confiance univariés classiques — qui intègrent la variance inter-sujets et masquent visuellement des effets intra-sujets significatifs —, mais de mobiliser les intervalles de confiance ajustés intra-individuels formalisés par la méthode de Cousineau-Morey.
10.3 Contrastes orthogonaux et polynomiaux planifiés
Lorsque le chercheur dispose d’hypothèses directionnelles solides formulées en amont de la collecte des données sur la base d’un cadre théorique mature, la substitution des tests post-hoc omnibus par des contrastes planifiés (a priori) maximise la rigueur déductive et la puissance analytique. Un ensemble de contrastes est dit orthogonal si les vecteurs de coefficients d’ajustement λ satisfont à la double condition ∑ λi = 0 pour chaque contraste individuel, et ∑ λ1iλ2i = 0 pour toute paire de contrastes distincts. Cette orthogonalité garantit que chaque contraste extrait une information pure et totalement indépendante de la variance de traitement.
Dans les plans à mesures répétées, les contrastes polynomiaux revêtent une pertinence théorique de premier ordre dès lors que la variable manipulée s’échelonne le long d’un continuum ordonné ou quantitatif (cinétique temporelle, paliers progressifs de dose pharmacologique, durée d’exposition perceptive). L’analyse polynomiale décompose l’effet global en tendances morphologiques fondamentales :
- Un contraste linéaire (λ = [-1, 0, 1] pour 3 conditions), attestant d’une progression ou régression constante et monotone de la performance au fil des niveaux.
- Un contraste quadratique (λ = [1, -2, 1]), identifiant une inflexion parabolique en U ou en U inversé, caractéristique des relations non linéaires (loi de Yerkes-Dodson reliant l’éveil motivationnel et la performance cognitive).
- Des composantes d’ordre supérieur (cubique, quartique), décelant des oscillations dynamiques plus complexes à travers les points d’observation temporels.
11. Violations des postulats et alternatives non paramétriques ou robustes
11.1 Gestion de la non-sphéricité en mesures répétées
Lorsque le test de sphéricité de Mauchly révèle une violation tangible de l’égalité des variances des différences (p < 0,05), l’analyste ne doit en aucun cas interpréter le test F standard non ajusté. Pour restaurer l’intégrité nominale de l’inférence sans abandonner le cadre de l’ANOVA, la méthodologie standard recourt à la réduction correctrice des degrés de liberté au numérateur et au dénominateur par un coefficient d’ajustement epsilon (ε), borné mathématiquement entre une valeur minimale théorique 1 / (k – 1) (correspondant à la non-sphéricité maximale absolue) et 1,0 (sphéricité parfaite).
Deux estimateurs d’epsilon dominent l’écosystème statistique : l’epsilon de Greenhouse-Geisser (ε̂GG) et l’epsilon de Huynh-Feldt (ε̃HF). Le correcteur de Greenhouse-Geisser est un estimateur conservateur qui sous-estime légèrement la valeur réelle d’epsilon sur les petits échantillons, ce qui prémunit rigoureusement le chercheur contre les faux positifs au prix d’une légère déperdition de puissance. Le correcteur de Huynh-Feldt a été développé pour corriger ce conservatisme sur les cohortes de taille modeste, mais présente l’inconvénient occasionnel de produire des valeurs d’ajustement supérieures à 1,0 (qui doivent alors être tronquées à l’unité).
Les recommandations méthodologiques contemporaines (notamment celles de Girden) préconisent une règle décisionnelle séquentielle claire :
- Si l’indice ε̂GG calculé est strictement inférieur à 0,75, la violation de la sphéricité est qualifiée de sévère ; il convient alors d’adopter systématiquement la correction de Greenhouse-Geisser.
- Si ε̂GG est supérieur ou égal à 0,75, la distorsion est jugée modérée ; la correction plus libérale de Huynh-Feldt doit être privilégiée afin de préserver la puissance statistique du test.
En alternative ultime aux corrections d’epsilon, certains auteurs recommandent le recours à l’approche multivariée de l’ANOVA pour mesures répétées (MANOVA). Les tests multivariés (comme le Lambda de Wilks ou la Trace de Pillai) ne postulent aucune structure de covariance circulaire des résidus, s’affranchissant totalement de l’exigence de sphéricité. Cependant, la MANOVA s’avère notablement moins puissante que l’ANOVA univariée ajustée lorsque l’échantillon est de taille restreinte (notamment lorsque n < k + 10).
11.2 Alternatives non paramétriques
Lorsque la variable dépendante viole dramatiquement les postulats métriques fondamentaux — distributions hautement asymétriques défiant la normalité des résidus, présences d’outliers impossibles à modéliser, ou données d’échelle strictement ordinale —, l’expérimentateur doit se tourner vers des méthodologies non paramétriques fondées sur les rangs relatifs.
Pour le devis inter-sujets, le substitut canonique à l’ANOVA à un facteur est le test de Kruskal-Wallis (Kruskal-Wallis H-test). L’algorithme agrège l’ensemble des N observations de tous les groupes confondus, leur attribue un rang hiérarchique unifié (de 1 à N), puis compare les sommes de rangs spécifiques obtenues par chaque groupe. La statistique H suit asymptotiquement une distribution du Chi-deux (χ2) à k – 1 degrés de liberté, évaluant si la probabilité qu’un score issu d’une modalité surpasse un score issu d’une autre diffère substantiellement de 0,50.
Pour le devis intra-sujets, l’alternative non paramétrique directe est le test de rangs de Friedman. Dans ce dispositif, le classement des scores par rangs s’opère de manière hermétique à l’intérieur de chaque sujet : pour chaque participant individuel, la performance est ordonnée de 1 à k le long des différentes conditions. La statistique χF2 évalue la concordance inter-individuelle des rangs assignés aux conditions. En présence de plans incomplets équilibrés où chaque sujet n’a pu parcourir qu’un sous-ensemble standardisé de conditions, le test de Durbin généralise l’approche de Friedman.
Si ces méthodes non paramétriques assurent une robustesse sans faille face aux anomalies distributionnelles, leur vulnérabilité conceptuelle réside dans leur incapacité à modéliser aisément des plans expérimentaux complexes impliquant des interactions factorielles multiples ou à intégrer élégamment des covariables continues d’ajustement.
11.3 Modèles mixtes linéaires (LMM) : Le prolongement moderne
Dans la recherche quantitative du XXIe siècle, l’ANOVA à mesures répétées classique par moindres carrés ordinaires cède progressivement le pas face à l’hégémonie des modèles linéaires mixtes (Linear Mixed-Effects Models ou LMM), théorisés par Laird et Ware. Cette transition méthodologique s’explique par la capacité des modèles mixtes à surmonter les limitations intrinsèques les plus pénalisantes du paradigme de l’ANOVA intra-sujets traditionnelle.
La première rupture majeure concerne la gestion des données manquantes. Comme explicité précédemment, l’ANOVA intra-sujets impose l’exclusion par liste intégrale (listwise deletion) de tout sujet présentant une unique observation cellulaire défaillante, amenuisant substantiellement la puissance et risquant d’introduire un biais d’échantillonnage si l’attrition n’est pas aléatoire (Missing Completely at Random). Les modèles mixtes linéaires, fondés sur des algorithmes d’estimation par maximum de vraisemblance restreint (REML), utilisent l’intégralité des points de mesure existants sans exiger que tous les sujets disposent d’un nombre identique d’observations, exploitant ainsi la totalité des informations empiriques collectées.
La seconde avancée conceptuelle réside dans la modélisation explicite et personnalisée des structures de variance-covariance. Plutôt que de subir la contrainte rigide et artificielle de la sphéricité ou d’imposer des pénalités globales d’epsilon, le chercheur modélisant ses données via un modèle linéaire mixte peut définir et comparer statistiquement des topologies de covariance complexes : structure autorégressive d’ordre 1 (AR[1]) où la corrélation décline de manière exponentielle avec l’écart temporel, structure Toeplitz, ou matrice entièrement non structurée (UN). De surcroît, les modèles mixtes autorisent l’intégration simultanée de facteurs fixes inter- et intra-sujets, de prédicteurs continus temporels dynamiques, et d’effets aléatoires croisés (comme la modélisation simultanée de la variabilité propre aux participants et de celle propre aux stimuli expérimentaux), conférant une adaptabilité écologique et analytique incomparable.
12. Guide décisionnel méthodologique et implémentation computationnelle
12.1 Arbre décisionnel pour la sélection du modèle approprié
Face à un projet de recherche expérimental ou observationnel, la sélection rigoureuse entre une ANOVA à un facteur inter-sujets et une ANOVA à mesures répétées requiert une trajectoire décisionnelle arborescente. L’algorithme suivant synthétise les points d’arbitrage méthodologiques et théoriques cardinaux :
Étape 1 : Diagnostic structurel de l’échantillonnage
Chaque unité statistique (participant) contribue-t-elle à un seul score scalaire unique dans l’analyse, ou chaque participant fait-il l’objet de plusieurs évaluations successives à travers les modalités de la variable d’intérêt ?
- Si une observation unique par individu → Orientation vers le plan inter-sujets.
- Si mesures multiples par individu → Orientation vers le plan intra-sujets (mesures répétées).
Étape 2 : Évaluation des risques de contamination temporelle et irréversibilité
L’administration successive des conditions induit-elle un effet de report, une modification cognitive permanente (apprentissage indélébile), ou une altération clinique structurelle empêchant le retour au niveau de base ?
- Si OUI → Le plan intra-sujets est formellement invalidé. Le chercheur doit impérativement adopter un plan inter-sujets avec randomisation stricte (quitte à compenser la perte de puissance par une augmentation de la cohorte).
- Si NON (effets volatils, réversibles et neutralisables par contrebalancement) → Le plan intra-sujets est scientifiquement valide et préférable.
Étape 3 : Examen des postulats distributionnels et structures de données
- Pour le devis inter-sujets : les résidus sont-ils normaux et homoscédastiques (test de Levene) ? Si l’homogénéité des variances fait défaut en plan non balancé, appliquer l’ANOVA de Welch. Si la variable est ordinale ou asymétrique, adopter le test de Kruskal-Wallis.
- Pour le devis intra-sujets : la matrice des données contient-elle des cellules manquantes ? Si le jeu de données présente une attrition substantielle ou si les trajectoires sont complexes, abandonner l’ANOVA au profit des Modèles Mixtes Linéaires (LMM). Si les données sont complètes, vérifier l’hypothèse de sphéricité (test de Mauchly) ; en cas de violation, appliquer la correction d’epsilon de Greenhouse-Geisser ou de Huynh-Feldt. En cas d’échelle purement ordinale, recourir au test de Friedman.
12.2 Syntaxe et exécution sous les environnements statistiques (R et SPSS)
L’implémentation pratique de ces modèles s’effectue quotidiennement dans des écosystèmes logiciels standardisés tels que R et IBM SPSS Statistics. La maîtrise des syntaxes et le repérage précis des outputs analytiques conditionnent l’exactitude des inférences rédigées par le chercheur.
Sous l’environnement statistique R :
Pour l’ANOVA inter-sujets, la formulation canonique s’appuie sur la fonction de base aov() en spécifiant une formule où la variable dépendante est modélisée par le facteur catégoriel unique :
modele_inter <- aov(Score ~ Groupe, data = donnees_inter)
summary(modele_inter)
Pour l’ANOVA à mesures répétées, l’analyse requiert la spécification formelle du terme d’erreur attribuable au sujet. À l’aide de la même fonction aov(), le terme Error(Sujet_ID / Condition) est inséré dans la formule :
modele_intra <- aov(Score ~ Condition + Error(Sujet_ID / Condition), data = donnees_long)
summary(modele_intra)
Alternativement, le package spécialisé ez fournit via la fonction ezANOVA() un bilan diagnostique exhaustif incluant automatiquement le test de sphéricité de Mauchly et les corrections d’epsilon :
library(ez)
ezANOVA(data = donnees_long, dv = .(Score), wid = .(Sujet_ID), within = .(Condition), detailed = TRUE)
La préparation des données dans R nécessite couramment la transition du format « large » vers le format « long » via la bibliothèque tidyr :
library(tidyr)
donnees_long <- pivot_longer(donnees_wide, cols = c("Temps1", "Temps2", "Temps3"), names_to = "Condition", values_to = "Score")
Sous l’environnement IBM SPSS :
Pour l’ANOVA inter-sujets, l’utilisateur sollicite la procédure GLM univariée :
UNIANOVA Score BY Groupe
/METHOD=SSTYPE(3)
/POSTHOC=Groupe(TUKEY)
/HOMOGENEITY
/DESIGN=Groupe.
Pour l’ANOVA à mesures répétées, les données étant obligatoirement configurées en format large dans la vue de données (une variable par condition répétée), l’analyste utilise la commande GLM REPEATED MEASURES :
GLM Cond1 Cond2 Cond3
/WSFACTOR=Condition 3 Polynomial
/MEASURE=Score
/PRINT=ETASQ HOMOGENEITY
/WSDESIGN=Condition.
Dans la fenêtre de résultats SPSS de cette dernière procédure, l’analyste doit impérativement scruter le tableau intitulé « Mauchly’s Test of Sphericity ». Si la significativité est inférieure à 0,05, la lecture du tableau subséquent « Tests of Within-Subjects Effects » doit obligatoirement s’effectuer sur la ligne correspondant à « Greenhouse-Geisser » ou « Huynh-Feldt », et non sur la ligne « Sphericity Assumed ».
12.3 Normes de rapportage académique selon les standards APA (7e édition)
La restitution académique des analyses de variance dans les revues internationales de psychologie obéit aux normes strictes dictées par la 7e édition du manuel de publication de l’American Psychological Association (APA). La rédaction doit fournir de manière exhaustive les descripteurs essentiels : moyennes conditionnelles, écarts-types, valeur exacte de la statistique F, degrés de liberté afférents, seuil de significativité exact (valeur p rapportée avec trois décimales sans zéro initial, ou p < 0,001), et taille d’effet standardisée.
Exemple canonique de rapportage pour une ANOVA inter-sujets :
« Une analyse de variance univariée à un facteur inter-sujets a été menée afin d’évaluer l’effet des différentes techniques d’apprentissage sur les scores de rétention mémorielle. Les résultats indiquent un effet significatif et robuste du type de stratégie pédagogique, F(2, 12) = 30,51, p < 0,001, ηp2 = 0,84. Les comparaisons post-hoc menées à l’aide du test HSD de Tukey révèlent que la technique d’auto-explication (M = 78,00, ET = 3,94) entraîne des performances significativement supérieures à la méthode des cartes mnémotechniques (M = 67,00, ET = 3,81, p = 0,002) ainsi qu’à la simple répétition mécanique (M = 56,00, ET = 5,43, p < 0,001). Par ailleurs, l’usage des cartes mnémotechniques surpasse significativement la répétition mécanique (p = 0,003). »
Exemple canonique de rapportage pour une ANOVA à mesures répétées avec violation de sphéricité :
« Une analyse de variance à mesures répétées à un facteur a été réalisée pour examiner l’évolution des scores de performance mémorielle à travers les trois modalités d’étude chez les mêmes participants. L’examen des postulats distributionnels au moyen du test de sphéricité de Mauchly indique une violation manifeste de l’hypothèse de sphéricité, W = 0,42, p = 0,031. Dès lors, les degrés de liberté ont été ajustés selon la procédure de correction de Greenhouse-Geisser (ε̂ = 0,63). L’effet du type d’apprentissage demeure hautement significatif après correction, F(1,27, 5,06) = 181,68, p < 0,001, ηp2 = 0,98. Des tests t appariés bilatéraux ajustés selon la méthode de Holm-Bonferroni confirment que les scores obtenus sous auto-explication sont significativement plus élevés que sous cartes mémoire, t(4) = 9,49, p < 0,001, d = 4,24, et sous répétition mécanique, t(4) = 16,50, p < 0,001, d = 7,38. »
Dans l’élaboration des figures scientifiques d’accompagnement, les standards éditoriaux exigent désormais d’éviter les graphiques en barres d’erreurs traditionnels non corrigés. Dans les plans à mesures répétées, l’illustration des intervalles de confiance doit impérativement s’appuyer sur la standardisation intra-individuelle de Cousineau-Morey, ou privilégier la représentation visuelle intégrale des distributions sous la forme de tracés en nuages de points reliés (raincloud plots), permettant aux pairs d’apprécier simultanément la trajectoire individuelle singulière de chaque sujet au sein du modèle.
Références
- Box, G. E. P. (1954). Some theorems on quadratic forms applied in the study of analysis of variance problems, I. Effect of inequality of variance in the one-way classification. The Annals of Mathematical Statistics, 25(2), 290–302. https://doi.org/10.1214/aoms/1177728786
- Cousineau, D. (2005). Confidence intervals in within-subject designs: A simple solution to Loftus and Masson’s formula. Tutorials in Quantitative Methods for Psychology, 1(1), 42–45. https://doi.org/10.20982/tqmp.01.1.p042
- Fisher, R. A. (1925). Statistical Methods for Research Workers. Oliver and Boyd.
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.2307/1164736
- Laird, N. M., & Ware, J. H. (1982). Random-effects models for longitudinal data. Biometrics, 38(4), 963–974. https://doi.org/10.2307/2529876
- Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731909
- Maxwell, S. E., & Delaney, H. D. (2004). Designing Experiments and Analyzing Data: A Model Comparison Perspective (2nd ed.). Lawrence Erlbaum Associates.
- Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913